评估要回答的是一个有条件的决策问题:在什么任务与用户分布上,某个系统是否比基线更有效,代价和风险是否可以接受,以及现有证据还有多大不确定性。有限测试集上的分数只是这个问题的一部分。任务定义错误、标签失真或测试污染都可能产生很精确却不对应目标的数字。
本章将指标、测量误差和统计推断放在同一条证据链上。检索与智能体的组件指标分别见第12章《信息检索》、第13章《检索增强生成》及第16章《智能体运行系统》;这里解释如何把逐例观测聚合为有边界的比较,如何设计人工与模型评审,以及怎样避免把离线相关性当作线上因果效果。
9.1评估对象
总体、协议及目标量
待估目标量(Estimand)是统计分析真正要估计的对象。设任务输入及其参考信息为 \(X\sim\mathcal P\),固定系统为 \(f_v\),随机生成条件为 \(\omega\),评估协议为 \(e\),逐例效用为 \(u\)。目标可以写为
这里的系统版本 \(v\) 不只是模型名称,还包括提示、分词器、解码、检索、工具和输出解析等配置。改变协议 \(e\) 也可能改变目标量,例如把不适用项计零与从分母排除,会得到不同含义的分数。
基准测试(Benchmark)是在约定任务和协议下形成的可比较坐标。部署中的任务效用还包含错误损失、完成时间、重试、人工介入与资源成本;基准得分不能不经论证就替代式(9.1)。即使某个题库中所有答案都正确,也不能据此推断另一语言、工具环境或时间范围的任务都正确。
表 9.1 主要统计对象。
| 符号 | 含义 |
|---|---|
| \(n,G,m_g\) | 记录数、独立组数、第 \(g\) 组记录数 |
| \(s_i^{(A)},s_i^{(B)},d_i\) | 同一案例两系统分数与配对差 |
| \(p,\hat p\) | 总体通过概率与样本通过比例 |
| \(\alpha,z_{1-\frac{\alpha}{2}}\) | 显著性水平与标准正态分位数 |
| \(\Delta,\delta\) | 系统期望差与预先规定的最小效应或非劣界 |
| \(\mathcal P,\mathcal Q\) | 目标任务分布与实际抽样分布 |
能力及证据分层
知识评估需要限定知识时间、领域与可访问来源;语言评估关注理解、表达和语言覆盖;推理评估需要检验中间约束与最终结论;长上下文评估需要控制证据位置、干扰与组合跨度;工具使用评估还需要判定参数、授权、执行结果和副作用。通用能力、领域能力与安全对齐必须按任务目的分别定义,不能用大量普通问答平均掉少数高损失失败。
组件指标解释局部机制,端到端任务指标观察整体完成情况,鲁棒性和安全切片观察特定失败面,在线随机实验估计真实流量中的干预效果。四类证据不能互相替代。一个检索器召回相关文档,并不证明生成回答忠实;一个回答通过人工评分,也不证明工具调用遵循了权限。
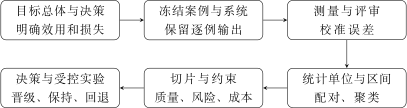
9.2常用数据集及基准协议
环境构建
评测材料至少有三种形态。静态数据集提供问题、参考答案或标签;交互基准还提供工具、初始状态、时间限制和执行后的验收器;综合指数则汇总多个基准的结果。它们都可以用于比较系统,但一个指数不是一套题库,一个终端环境也不只是若干文本问题。以下所称“常用”包括研究中的基础基准和模型发布中具有代表性的基准,并不表示所有基准都适合任意业务。
对静态选择题,核心观测通常是答案是否正确。对交互任务,评测运行框架(Evaluation Harness)负责组织提示、工具调用、环境恢复、预算与结果收集。同一个模型换用不同运行框架,可能执行不同的搜索与修复策略。因此,一个可解释的分数必须绑定
其中 \(D_v\) 为数据或环境版本,\(M_v\) 为模型版本,\(H_v\) 为运行框架,\(B\) 为词元、时间、工具调用和尝试次数预算,\(R\) 为逐例计分规则,\(A\) 为聚合规则。安全控制及回退模型也属于系统配置。两个结果只要这些要素存在实质差异,就不能仅凭同一个基准名称推断为受控对照。
知识、科学及数学
研究生级难检索问答(Graduate-Level Google-Proof Question Answering,GPQA)由生物、物理和化学领域专家编写多项选择题,考察专门知识与推理;Diamond 是其中的特定子集,不能与完整版本混写。主要指标是答案准确率。题目难以通过普通检索解决,是基准设计目标,不构成永远不存在网络答案的保证(Rein 等 2024)。
人类最后的考试(Humanity’s Last Exam,HLE)覆盖多学科的高难度封闭式问题,包含多模态材料,公开定稿集为2500题,并有单独保留的私有测试材料。报告中需要区分文本子集、完整输入、工具可用性及数据修订版本。其准确率与置信度校准考察不同性质:答对更多问题不意味着模型能识别剩余错误,更不直接证明具有开放式科研能力(Center for AI Safety, Scale AI, 和 HLE Contributors Consortium 2026)。
FrontierMath 面向高难度数学问题。Tier 4 是特定难度层,不等于全部题目;v2 修订过题目与集合,因此版本必须随分数保留。官方协议允许使用计算工具,并提交可验证答案。研究级问题上的答案验证与完整证明审查也不是同一件事:一个数值或符号对象通过验收,不能自动替代对证明每一步的核查(Epoch AI 2026)。
基础知识及中文评估
大规模多任务语言理解(Massive Multitask Language Understanding,MMLU)使用跨学科选择题,为知识与推理提供基础坐标;MMLU-Pro 强化了推理要求并调整题目与选项,属于另一套基准。比较时须同时固定少样本示例、选项顺序、答案解析和学科权重(Hendrycks, Burns, Basart, 等 2021; Wang 等 2024)。如果模型已经接近某个题集的上限,少量分数变化提供的区分信息会减少;仍可将其用于回归检测,但选型还需要更贴近目标任务的材料。
C-Eval 与中文大规模多任务语言理解(Chinese Massive Multitask Language Understanding,CMMLU)分别覆盖52个学科与67个主题,适合补充中文及本地知识的评估。二者不是同一套英文题的不同译名;C-Eval Hard、验证集与测试集也必须分别标识。中文选择题得分不能替代中文长文写作、引用问答或业务流程评估(Huang 等 2023; Li 等 2023)。
基础数学及竞赛题
GSM8K 以多步基础算术应用题为主;MATH 包含竞赛数学题及参考解答。通常依据解析后的最终答案计算正确率,但数值格式、符号等价判定和工具使用都属于协议,不能仅报告模型名称(Cobbe 等 2021; Hendrycks, Burns, Kadavath, 等 2021)。MATH-500 与完整测试集的样本构成不同,报告中应保留子集名称。
美国数学邀请赛(American Invitational Mathematics Examination,AIME)是逐年举行的竞赛,每套15题,答案为0至999的整数;它不是一个自带统一模型采样协议的静态数据集。模型评测应写明年份、I卷或II卷、是否合并、每题尝试次数及答案选择方法(Mathematical Association of America 不详)。例如一套15题中多答对一题就改变约6.67个百分点,故小题集的年度差异与抽样变异尤其不能忽略。
函数生成及时间分组的代码题
HumanEval 根据函数签名和文档字符串要求生成 Python 实现,通过测试估计 pass@\(k\);其组合估计见式(9.9)。LiveCodeBench 持续汇集竞赛编程题,并区分代码生成、自修复等场景;用于比较时应固定发布版本、题目日期窗口和测试裁剪方式(Chen 等 2021; Jain 等 2024)。按日期划分有助于控制时间泄漏,但并不自动证明待测模型从未接触题目。基于参考答案判断失败后再反复采样,也不能伪装成一次生成的准确率。
多模态、长上下文及指令遵循
大规模多学科多模态理解(Massive Multi-discipline Multimodal Understanding,MMMU)将大学学科问题与图表等视觉材料结合,按答案正确性计分。需要固定图像分辨率、多图处理及测试划分,避免把视觉预处理差异误认为纯文本推理差异(Yue 等 2024)。MMMU 与 MMMU-Pro 分属不同协议。公开题目与标签的状态也会改变:不能因早期论文采用隐藏测试标签,就永久假定当前测试答案仍未公开。
LongBench 原版混合长文问答、摘要、检索与代码等任务,分别采用 F1、ROUGE 或相似度等指标;LongBench v2 改用更强调长上下文推理的多项选择题。原版总分不是统一的答案准确率,v2 也不能被当作原题集仅增加长度(Bai, Lv, 等 2024; Bai, Tu, 等 2024)。对长度的计量还应注明字符、词还是具体分词器的词元。
多轮共指消解(Multi-Round Coreference Resolution,MRCR)要求在含相近请求的长对话中找回指定的既有回答。OpenAI 公开版本按针数及长度范围分组,计分器先检查指定前缀,再计算文本相似度;它不是一般问答的二元准确率(OpenAI 不详)。这类合成检索成绩需要与多文档推理互补,不能据此声称整个长上下文都被可靠理解。
指令遵循评估(Instruction-Following Evaluation,IFEval)利用程序检查词数、关键词与输出形式等可验证约束。它同时区分提示级和指令级、严格和宽松两组口径:提示级要求一条提示内所有约束均通过,指令级按单个约束汇总;宽松计分只容许协议列出的有限输出变换,并不是任意人工放宽要求(Zhou 等 2023)。格式约束通过不证明事实正确或业务价值充分。
代码、浏览及计算机操作
SWE-bench 根据真实软件仓库的问题描述要求系统生成修补,并在仓库环境中运行测试;Verified 是经过人工筛选的500个实例子集。主要指标为解决比例。该结果受基础提交、依赖环境、测试验收及智能体运行框架影响;函数级代码生成成绩不能替代仓库级修复证据,仓库测试通过也不能证明所有潜在行为均正确(SWE-bench Team 不详)。
Terminal-Bench 系列通过终端环境中的可执行任务评估智能体。需要把通用终端任务与科学工作流分支分开:例如发布材料中的 Terminal-Bench 4.0 与 Terminal-Bench Science 0.1 是不同版本和任务分布,不能合并成一项“代码准确率”。科学工作流还涉及数据分析、模拟与模型拟合;最终产物是否满足验收器,比回答是否声称完成更有意义(OpenAI 2026)。
BrowseComp 以难以定位、但答案较短且可核验的信息检索问题为对象,原始集合包含1266题。它适合研究多步搜索与证据定位,主要报告答案准确率;浏览器、搜索源、访问时间和预算都会影响结果。长篇报告的论证质量、引用覆盖和用户需求理解仍需另外评估(OpenAI 2025)。
OSWorld 2.0 是跨软件的长程计算机操作基准,可按完整集或离线子集评价,也区分部分奖励与二元完成判定。ScreenSpot-Pro 则侧重屏幕元素定位;定位正确并不等于完成整个工作流。前者需要检查最终状态和多步约束,后者的测量对象更接近动作选择中的视觉定位组件(OSWorld Team 2026; OpenAI 2026)。
交互推理及计分单位
ARC-AGI-3 要求智能体探索陌生的交互环境并从反馈中学习,计分包含相对于人类的行动效率。它与 ARC-AGI-1、ARC-AGI-2 的静态任务形式不同;三个版本的百分数不是同一种准确率,也不能因一个基准接近满分就推导出对所有环境的普遍能力(ARC Prize Foundation 2026)。
即使分数都被写为百分数,也必须检查分子和分母。设任务 \(i\) 有 \(m_i\) 个验收项,权重 \(w_{ij}\geq0\) 且 \(\sum_jw_{ij}=1\),验收结果为 \(r_{ij}\in\{0,1\}\)。可以构造任务部分得分与全通过指标
这里假定每个验收项均为完成任务所必需,且没有额外一票否决规则。两个任务各有五项等权要求,分别满足四项与两项,则平均部分得分为60%,完整任务成功率却为0。这个构造例子用于解释计分差异,不是复刻某个实际基准的验收器。正式实验应使用该版本规定的规则。
模型发布评测
以下记录2026年9月8日核实的 GPT-6 Astra 与 Claude Fable 5.1 发布材料,用于说明如何阅读模型发布表。它们是厂商报告的历史观测,不是本书重新运行的实验,也不是持续更新的模型排名。表9.2选取共同或具有代表性的项目;空项表示本表没有对应发布数值,不能填成零。
表 9.2 发布时的代表性评测结果 |
|||
|---|---|---|---|
| 基准或计分项 | Astra | Fable 5.1 | 指标及限定 |
| 基准或计分项 | Astra | Fable 5.1 | 指标及限定 |
| Terminal-Bench 4.0 | 57.9% | 55.8% | 终端任务得分;运行框架须另核对 |
| Terminal-Bench Science 0.1 | 64.6% | 52.6% | 科学工作流得分 |
| HLE,有工具 | 57.2% | 65.0% | 答案准确率;工具与裁判协议不同 |
| HLE,无工具 | — | 60.9% | 与有工具配置分开 |
| AutomationBench | 41.4% | 31.4% | 业务流程任务通过比例 |
| GDPval-AA v2 | — | 1853 | Elo,非百分数 |
| CursorBench 3.2.0 | — | 73.4% | Cursor 编码任务评分 |
| OSWorld 2.0,Astra 发布协议 | 72.6% | — | v2026.08.08 离线集,部分得分 |
| OSWorld 2.0,Fable 发布协议 | — | 77.9% | 8月任务版及修复,部分得分 |
| 同上,严格完成口径 | — | 41.7% | 全部要求满足的任务比例 |
| GPQA Diamond | 96.0% | — | 科学选择题准确率 |
| FrontierMath Tier 4 v2 | 97.6% | — | 指定数学题集得分 |
| ARC-AGI-3 | 99.9% | — | 交互推理与行动效率 |
| BrowseComp | 91.5% | — | 浏览检索答案准确率 |
数据来源分别为 OpenAI 的 Astra 发布表与 Anthropic 的 Fable 5.1 发布主表(OpenAI 2026; Anthropic 2026b)。Fable 主表共七个基准、九个计分行,已全部列入;其系统卡中的其他基准不在这里冒充发布主表。Astra 仅选取代表项目,未将全部内部评测展开。Astra 引言把 FrontierMath 成绩取整为98%,这里保留正式表中的97.6%。
GPT-6 Astra 的发布表还包含专业工作、科学健康、安全和长上下文等评测:例如 Agents’ Last Exam、BenchCAD、DeepSWE v1.1、FrontierCode 1.1、HealthBench Professional、GeneBench Pro、LifeSciBench、MRCR v2,以及内部设计、数据科学和数据库迁移任务。Artificial Analysis 的 Intelligence Index 与 Coding Agent Index 是综合指数,不是单个数据集。内部任务可以提供补充证据,但缺少公开题目和完整协议时,本书不能声称独立复现(OpenAI 2026)。
读发布表时,尤其要保留下列限定。第一,Astra 表中的 OSWorld 2.0 明确为 v2026.08.08 离线集合与部分得分,不能与不同任务修改及评分设置的结果直接相减。第二,Astra 发布表报告各推理档位中的最高分;它不是固定成本下的统一对照。推理强度的模型相关语义与对照方法见第26章《可验证推理训练》。第三,安全干预后改由另一个模型完成的任务,应被解释为包含回退路径的系统结果,不能归给一个未经切换的模型。1(OpenAI 2026)
Fable 5.1 发布案例中的 GDPval-AA v2 根据职业任务产物的盲配对比较形成 Elo;AutomationBench 检查跨应用业务流程的最终状态;CursorBench 3.2.0 使用 Cursor 的编码任务与运行框架。Elo 是相对评级,1853不能读成1853%的准确率,跨日期的评级还可能因参评系统与拟合结果变化而改变。它们分别提供产物偏好、流程验收和编码工作流证据,不应直接平均为一个百分数(Anthropic 2026a)。
Fable 的系统卡还说明了影响解释的实验条件:HLE 分别运行有工具与无工具配置,使用固定裁判,并对检索到题库答案的轨迹重新判错;OSWorld 被安全机制中止的指定任务计零,其他受干预的特定任务可能由较早模型接替。Terminal-Bench Science 0.1 各模型报告的标准误约为3.5至4.5个百分点,主要不确定性来自任务差异。这是标准误范围,不是每个模型统一的95%置信区间(Anthropic 2026a)。同一道任务的多次运行也不能都当成新的独立任务,本章后文的聚类与重复测量方法仍然适用。
这些限制不是把结果全部否定,而是决定证据能支持什么判断。若目标是选择固定月度预算下的代码助手,就应在相同任务和成本约束下比较质量;若目标是研究最大可达能力,可以提高预算,但需同时报告尝试次数、运行时间与成本。跨厂商榜单通常不能提供同题配对结果,因此不应直接套用本章配对检验给分数差赋予显著性。
算法9.1 选择并冻结评测组合
输入:目标任务分布、错误损失、候选系统、时间与费用预算。
输出:版本化基准组合、逐例验收规则与统计计划。
将目标拆成知识、推理、检索、工具动作和最终产物等可观察能力,确定哪些约束必须同时满足。
选取相关公开基准,并加入来自真实业务、与训练和开发过程隔离的保留案例;记录每组材料的来源与权重。
冻结式(9.2)中的全部要素,特别是工具、预算、失败计分、安全控制与回退路径。
在开发材料上校验验收器和答案解析;冻结后保留所有测试案例,包括超时、拒答、无效产物与环境故障的分类记录。
保存逐例观测,按预先定义的独立单位计算区间及切片结果;同时报告质量、延迟、费用和高损失失败。
停止与边界:达到预定样本及预算后停止。公开分数无法提供的配置或逐例信息应明确缺失,不通过猜测补齐。评测组合变化后重新定义目标量。
9.3分类、概率及决策代价
混淆矩阵及平均口径
混淆矩阵(Confusion Matrix)以真实标签为行、预测标签为列。二分类中的真阳性、假阳性、真阴性和假阴性分别记为 TP、FP、TN、FN。准确率(Accuracy)、精确率(Precision)和召回率(Recall)为
F1 分数(F1 Score)是精确率和召回率的调和平均:
分母为零时须显式规定未定义、排除或计零,并报告受影响类别。把“本次没有这种任务”与“这种任务全失败”都记成零会改变结论。
构造一个 \(n=100\) 的例子:实际正类20条,其中12条预测为正;实际负类80条,其中4条预测为正。因此 \(\mathrm{TP}=12,\mathrm{FN}=8,\mathrm{FP}=4,\mathrm{TN}=76\)。准确率为 \(0.88\),正类精确率 \(\frac{12}{16}=0.75\),召回率 \(\frac{12}{20}=0.60\),F1 为 \(\frac{24}{36}=\frac{2}{3}\)。若把负类也按一对其余类别计算,负类 F1 为 \(\frac{152}{164}\approx0.9268\)。
宏平均(Macro Average)使各类别等权,本例 Macro-F1 约为 \(\frac{0.6667+0.9268}{2}=0.7967\)。微平均(Micro Average)先汇总各类计数,再计算指标。在单标签、类别全集齐全的多分类中,每次错误同时贡献一个 FP 和一个 FN,故 Micro-F1 等于准确率,本例为 \(0.88\)。这一等式不应推广到多标签或只选择部分类别的评估。
阈值及概率校准
若 \(p=\Pr(Y=1\mid x)\) 是已校准条件概率,误报和漏报损失为 \(c_{\mathrm{FP}},c_{\mathrm{FN}}>0\),预测正类的条件风险是 \(c_{\mathrm{FP}}(1-p)\),预测负类的风险是 \(c_{\mathrm{FN}}p\)。选择前者当且仅当
例如误报损失为9、漏报为1,阈值为0.9。这个推导假设正确决策损失为零且损失不随个体变化;有额外行动、拒答或个体成本时,应比较全部行动的条件风险。
概率校准(Probability Calibration)要求预测为某概率水平的样本具有相应事件频率。排序好不等于校准好。一个模型把所有概率从 \(p\) 单调变换为 \(p^2\),排序可以保持,式(9.6)的概率含义却不再自动成立。二分类 Brier 分数为 \(n^{-1}\sum_i(p_i-y_i)^2\);若真实概率为 \(q\),其条件期望等于 \((p-q)^2+q(1-q)\),因此在 \(p=q\) 处最小。
期望校准误差(Expected Calibration Error,ECE)常将预测分桶,计算各桶预测均值与事件比例差的加权绝对值。它依赖分桶规则,粗分桶可能掩盖局部错误,样本稀少时又有较大估计噪声。阈值和校准器都应在开发或校准数据上确定,最终测试数据用于评估冻结方案。
排序曲线
提高阈值使预测正类集合缩小,因此召回率非增;精确率不具有一般的单调保证,因为删除的下一个样本可能是真阳性,也可能是假阳性。受试者工作特征曲线(Receiver Operating Characteristic,ROC)描绘真阳性率与假阳性率;其面积可解释为随机正例分数高于随机负例的概率,平分时通常计半分。
精确率—召回率曲线(Precision–Recall Curve,PR)尤其需要同时报告正类基率。按排序位置 \(j\) 记精确率 \(P_j\) 和召回增量 \(R_j-R_{j-1}\),一种平均精确率(Average Precision,AP)定义为 \(\sum_jP_j(R_j-R_{j-1})\),不等于任意插值方式的曲线面积。曲线概括阈值族,部署阈值仍应由实际损失与约束决定。
9.4生成指标的测量对象
概率及词面一致性
困惑度(Perplexity,PPL)将逐词元平均负对数似然指数化:
\(\mathcal S\) 是实际计分位置集合。分词器、文本、上下文窗口、模板、起止符和掩码共同规定“每词元”的单位;重叠滑窗不能无意重复计分。跨分词器的 PPL 不能直接按数值大小比较模型能力。其概率模型基础见第8章《自回归语言建模》。
完全匹配(Exact Match,EM)比较规范化后的答案是否相等。规范化必须声明大小写、空白、标点、数值单位及多参考规则。词元 F1(Token F1)令候选和参考的词元多重集合重合数为 \(m\),候选与参考长度分别为 \(c,r\),则 \(P=\frac{m}{c},R=\frac{m}{r},F_1=\frac{2m}{c+r}\)。重复词元的匹配次数不能超过参考中的出现次数。
双语评估替代指标(Bilingual Evaluation Understudy,BLEU)使用经参考计数截断的 \(n\) 元组精确率 \(p_n\),并施加长度惩罚(Papineni 等 2002):
\(w_n\geq0\) 且总和为1,\(c,r\) 为按协议得到的候选和有效参考长度。通常需在语料层累加计数,而非随意平均逐句 BLEU。2零匹配时的平滑、空输出和多参考长度选择都应固定。
面向召回的摘要评估指标(Recall-Oriented Understudy for Gisting Evaluation,ROUGE)是指标族(Lin 2004)。ROUGE-\(n\) 的基本召回形式为匹配 \(n\) 元组数除以参考 \(n\) 元组数;ROUGE-L 则利用最长公共子序列,具体输出召回、精确率或 F 分数仍须声明。词面相近可以对应事实相反,否定词、数值和单位错误也可能只改变很少词元。
以参考词元序列“甲 乙 丙 丁”、候选“甲 乙 戊”为例,\(m=2,c=3,r=4\),Token F1 为 \(\frac{4}{7}\),ROUGE-1 召回率为 \(\frac{1}{2}\),EM 为零。只计算一元与二元 BLEU、各权重 \(\frac{1}{2}\) 且不平滑时,\(p_1=\frac{2}{3},p_2=\frac{1}{2}\),故分数为 \(e^{-\frac{1}{3}}\sqrt{\frac{1}{3}}\approx0.4137\)。这些数字描述不同计数结构,没有一个直接回答“戊是否为错误事实”。
事实、执行及拒答
事实评估应把回答分解为可判定论断,分别标记证据支持、冲突与未知。引用存在、来源相关和来源支持论断是三个不同事件。引用精确率的分母可以是已给出的引用,论断覆盖率的分母则是需要证据的论断;二者不得混用。检索覆盖与答案忠实性的关系见第12章《信息检索》及第13章《检索增强生成》。
对于数学、代码和结构化操作,可执行验证器(Executable Verifier)以可执行约束或测试判定结果。测试通过仍受测试覆盖限制,不能一般化为程序完全正确。评估执行环境需隔离待测代码和副作用,超时、异常及无效输出必须按预定规则进入分母,而不是只保留成功返回的候选。
若对一题独立同分布生成 \(n\) 个候选,其中 \(c\) 个通过固定验证器,从这些候选均匀无放回选 \(k\leq n\) 个,全部失败的子集数为 \(\binom{n-c}{k}\),总子集数为 \(\binom nk\),故
在同分布独立采样前提下,这个子集平均对 \(k\) 次独立尝试至少一次通过的概率无偏(Chen 等 2021)。例如 \(n=5,c=2,k=2\),结果为 \(1-\frac{3}{10}=0.7\);直接代入样本通过比例得到 \(1-(\frac{3}{5})^2=0.64\),两种估计并不相同。相关采样、不同温度混合或自适应重试会改变目标分布。即使候选集中有正确答案,也不代表产品能识别并选择它,故 pass@\(k\) 不是验证选择后的单次交付成功率。
拒答评估还应区分不可回答任务上的正确弃权,与可回答任务上的过度拒绝。安全失败、事实错误和风格偏好应分维度报告,不能以更流畅的文风抵消一个禁止行动。
9.5评审员测量模型
人工量表及模型裁判
评分量表(Rubric)需要将“好回答”拆成可观察维度,为各等级提供锚点、正反例及不适用规则。人工评审先独立评分再仲裁,保留原始分歧;只保存仲裁标签会隐藏量表歧义。盲评隐藏候选身份、运行成本等无关信息,候选顺序随机化,必要时限制高风险材料的访问与保留。
模型评审(LLM-as-a-Judge)可扩展开放式判断,但会受位置、长度、风格、自我偏好和提示注入影响(Zheng 等 2023)。交换顺序后必须先映射回原候选身份,再比较判定。相同事实的长短改写可以识别冗长偏好;跨模型家族的交叉设计用于识别自我偏好。一个总体人工一致率无法替代这些专门对照。
对人工判定不通过的样本,假通过率定义为 \(\Pr(J=1\mid H=0)\);在裁判判定通过的样本中,错误比例则为 \(\Pr(H=0\mid J=1)\),两者分母不同。裁判模型、量表、语言或候选输出分布改变后,应重新估计这两个量。只有两个顺序都通过才接受,是一种保守决策规则,可能降低假通过,也可能提高假拒绝;两个判断通常相关,不能把两次错误率直接相乘。
一致性及胜率计算
科恩一致性系数(Cohen’s Kappa,\(\kappa\))以边际分布为基准校正观测一致率(Cohen 1960)。若观测一致率为 \(p_o\),两位评审在类别 \(c\) 的边际比例为 \(p_{1c},p_{2c}\),则
例如100条二分类评分中,两人都判通过40条、都判不通过30条,甲通过乙不通过20条,甲不通过乙通过10条。于是 \(p_o=0.7\),甲通过率0.6、乙通过率0.5,\(p_e=0.6\times0.5+0.4\times0.5=0.5\),\(\kappa=0.4\)。它衡量超过特定偶然基准的一致程度,不是二者的准确率;类别极不均衡会改变这个基准。序数、多评审和缺失评分需要适合其结构的统计量。
成对偏好中若胜、负、平分别为 \(W,L,T\),半分平局胜率为 \(\frac{W+\frac{T}{2}}{W+L+T}\)。例如 \((12,6,2)\) 得到 \(0.65\)。单条贡献可以是 \(0,\frac{1}{2},1\),因此它是有界均值而非普通伯努利比例,不能直接把“13胜20题”当作真实二项计数套用所有二项区间。
9.6区间估计
Wilson 区间推导
独立二项比例
本节假设每个统计单位产生一次通过或失败,单位相互独立、通过概率相同,样本来自目标抽样机制,系统与判定规则已冻结。多轮会话、重复用户和多个随机种子并不自动满足这些条件。
令 \(K\sim\operatorname{Binomial}(n,p)\),\(\hat p=\frac{K}{n}\),则 \(\mathbb E\hat p=p\)、\(\operatorname{Var}(\hat p)=\frac{p(1-p)}{n}\)。直接把 \(p\) 换成 \(\hat p\) 得到 Wald 区间,在边界处可能退化或越界。威尔逊区间(Wilson Interval)通过反解关于候选 \(p\) 的分数检验不等式获得(Wilson 1927):
取二次方程两根之间的区间,得到
这是依赖正态分位数近似的区间,不是任意 \(n,p\) 下覆盖率恰好等于标称值的保证。置信区间(Confidence Interval,CI)的频率学派解释是:在相同抽样机制反复取样并按同一规则构造区间时,长期覆盖固定真值的比例接近声明水平。它不表示观察到本区间后,固定参数以95%的概率随机落在其中。
对于 \(n=20,k=20,z=1.96\),上界为1,下界为 \(\frac{20}{20+3.8416}\approx0.8389\)。二十次全通过仍允许相当大的未观测失败率。另从零失败的精确二项关系 \((1-q)^n=\alpha\),得到失败率 \(q\) 的单侧上界 \(1-\alpha^{\frac{1}{n}}\);当 \(q\) 小时近似为 \(-\frac{\log\alpha}{n}\),95%时约为 \(\frac{3}{n}\)。单侧界与前面的双侧 Wilson 界使用不同构造,不能混为一个指标。
区间仅反映给定模型下的抽样误差。判定器偏差、样本代表性和训练污染不会因为 \(n\) 很大就自动消失。
配对差及效应大小
同一批案例比较 A 与 B,令 \(d_i=s_i^{(A)}-s_i^{(B)}\)。在独立案例和有限方差条件下,
其优势来自 \(\operatorname{Var}(A-B)=\operatorname{Var}(A)+\operatorname{Var}(B)-2\operatorname{Cov}(A,B)\)。两模型通常同时在难题上失败,正相关可以降低配对差的方差;把结果当作无关样本会丢弃这部分信息。
例如100个独立案例中,A独胜15条、B独胜5条,其余80条一致。差值总和10、平方和20,所以 \(\bar d=0.10\),\(s_d^2=\frac{20-100\times0.1^2}{99}=\frac{19}{99}\),标准误约0.0438,正态近似95%区间约为 \([0.014,0.186]\)。该算例支持正向平均差,但区间下界未达到假设的最小实用提升0.02,因而“区别于零”和“达到实用标准”是不同结论。
置换检验(Permutation Test)在零假设下交换配对中的系统身份,并比较统计量。独立配对且零假设赋予交换对称性时,可枚举或抽样翻转 \(d_i\) 符号;仅假设均值为零而不具备相应对称或随机化条件,并不足以自动保证任意符号检验有效。\(p\) 值是零假设及检验模型下至少同样极端结果的概率,不是零假设为真的概率。
聚类、Bootstrap 及多种子
自助重采样(Bootstrap)从经验样本重复有放回抽样,以近似统计量的抽样分布(Efron 1979)。计算非线性指标如 Macro-F1 时,应在每次重采样后重算指标,而非只重采样一个已经聚合的数字。
簇重采样(Cluster Bootstrap)将用户、文档等独立组作为抽样单位,保留组内记录共同出现。若每组有 \(m\) 条记录,单条方差 \(\sigma^2\),组内任意两条相关系数为 \(\rho\)、组间独立,则 \(n=Gm\) 条记录均值的方差为
方括号是这一简化模型的设计效应。例如10位用户各10条请求、\(\rho=0.5\),设计效应为5.5,按方差等价得到有效样本量约 \(\frac{100}{5.5}=18.2\),不能视为100个独立用户。
组大小不一致时还必须明确估计请求平均还是用户平均。二者分别为
按用户重采样可以支持两种目标,但每次聚合的权重必须匹配预定目标。
多个案例、多个种子构成交叉重复测量。同一案例跨种子相关,同一种子运行内也可能共享状态。只在每个种子内部聚合再按种子重采样,回答的是固定测试集上的运行变异;若要推断新案例总体,还需按案例来源重采样,或采用适合交叉结构的分层模型与双向方案。增加重采样次数只能减少 Monte Carlo 误差,不能创造更多独立用户或独立种子。
算法9.2 配对簇重采样区间
输入:两方案在同一组案例上的逐例结果、独立簇标识、目标聚合函数 \(T\)、重复次数 \(R\)、水平 \(1-\alpha\)。
输出:配对差点估计及百分位区间。
状态:完整的 \(G\) 个簇与重采样差值列表。
固定缺失、超时和不适用规则;以相同案例键对齐两方案。确认簇的独立性依据及聚合权重。
计算原始差 \(\hat\Delta=T(A)-T(B)\)。
对 \(r=1,\ldots,R\),从 \(G\) 个簇有放回抽取 \(G\) 次;重复抽到的簇作为重复副本加入,保留其全部配对记录。
在同一组簇副本上分别计算 \(T(A^*)\) 与 \(T(B^*)\),保存差值。不能独立为两个方案抽样。
取差值分布的 \(\frac{\alpha}{2}\) 与 \(1-\frac{\alpha}{2}\) 分位点,连同 \(G\)、\(R\)、分位数约定及点估计返回。
停止与边界:完成 \(R\) 次后停止;若独立簇太少或统计量在大量副本中未定义,应报告不稳定及原因,不用更多重复次数掩盖问题。百分位方法也有有限样本和偏差局限。
9.7污染、切片及选择偏差
训练集用于拟合,开发集用于方案选择,校准集用于阈值或裁判标定,最终测试集评估冻结方案。公开题目、答案解析、近重复、来源标题以及文件名都可能泄露信息。测试污染不仅是文本完全相同,也可能是同一模板、同一文档或答案结构进入开发过程。数据血缘与分组切分机制见第18章《训练数据工程基础》。
切片评估(Slice Evaluation)按语言、领域、长度、风险或能力结构分析子群。若各互斥切片权重为 \(w_j\)、得分为 \(\mu_j\),总体为 \(\mu=\sum_jw_j\mu_j\)。假设简单任务得分0.95、困难任务0.50,简单任务占80%时总体0.86,占50%时总体0.725。模型在任何切片都未变化,总分却下降0.135。因此比较时需同时报告切片得分和构成变化。
重叠切片不能把样本数相加当作独立总量。事后发现的切片适合诊断,应标记探索性并在新数据中复验。高严重度失败的硬性约束需要由任务损失定义;某个教学门槛或“每组30条”不是统计充分性的普遍定理。
反复测试许多方案再报告最大分数会产生选择偏差。若 \(M\) 个有效检验各用水平 \(\alpha\),即使每个零假设都成立,也不能把整体误报率当作 \(\alpha\)。Bonferroni 原则给每项 \(\frac{\alpha}{M}\),利用并集上界控制总体误报概率,但可能保守。实际应预先声明主要目标、保留独立最终集,并将探索结果与确认性结论分开。未显著不等于等效;非劣性要求相对于预定损失界单独设计比较。
9.8在线实验及多目标决策
(选修)
随机化及因果效果
随机对照实验(Randomized Controlled Experiment)将合格单位随机分配到不同系统。令 \(Y_i(1),Y_i(0)\) 为同一单位在两种系统下的潜在结果,目标平均处理效应为 \(\mathbb E[Y(1)-Y(0)]\)。随机分配使分组与潜在结果独立;在无干扰、处理定义一致和观测完整等条件下,组均值差估计该效应。
随机化单位应与记忆和干扰结构一致。同一用户跨方案可能发生学习、缓存或会话串扰;用户之间存在网络效应时,仅按用户分流也未必足够。稳定哈希可以实施固定分组,但不能替代对身份、排除规则、互斥实验和样本比例异常的处理。
例如两组各1000个独立用户,A成功600、B成功650,差值为0.05。用独立二项方差估计,标准误为
近似95%区间为 \([0.0076,0.0924]\)。这与离线同题配对是不同设计,不能套用同一协方差结构。若目标是至少提高两个百分点,这个区间仍不足以证明达到目标。
意向处理分析(Intention-to-Treat Analysis,ITT)按最初分配组统计效果,避免只保留成功返回或完成使用的样本所造成的处理后选择偏差。超时、未完成请求和标签延迟需按预先协议处理。固定观察窗口、样本量和停止规则后再查看结果;未经校正地反复查看显著性并提前停止,会改变误报率。
在两组样本量相等、共同基率近似为 \(p\) 的简化设计中,检测绝对差 \(\delta\)、双侧水平 \(\alpha\)、功效 \(1-\beta\),每组样本量的粗略正态近似为
例如 \(p=0.5,\delta=0.05,z_{0.975}=1.96,z_{0.8}\approx0.84\),得到每组约1568。聚类、损耗、稀有事件或多重指标会改变设计,不能把这个近似值当作所有实验的通用要求。
质量、风险、延迟及成本
对质量越高越好、成本与延迟越低越好的目标,若 A 各项不劣于 B 且至少一项严格更优,则 A 支配 B。帕累托前沿(Pareto Frontier)由所有不被支配的方案构成。构造三个方案:A为质量0.90、成本2、延迟200;B为0.92、3、240;C为0.88、2.5、220,其中成本和延迟均采用同一任意单位。A支配C,A与B互不支配。若质量下限0.91,A虽在前沿上仍不可行。
成本需包含生成、检索、评审、人工与失败重试;延迟需固定输入长度、输出长度、并发、缓存及工具路径。采用最近秩定义时,P95是排序后第 \(\lceil0.95n\rceil\) 项;小样本尾部分位数不稳定,也不宜与不同实现的插值分位数混比。质量与成本均带不确定性时,还应避免仅按点估计宣布稳健支配。
证据不足是一种有效决策
发布判断需要同时满足适用的硬约束、效应标准与证据强度。平均分提高不能抵消未满足的权限约束,未发现失败不能证明风险为零,未达到显著性也不能证明两系统等效。保持当前方案并补充针对性证据,可以是统计分析直接支持的结果。
可复现记录应绑定数据快照、模型制品、提示与索引、生成条件、评审协议、逐例输出、统计计划和环境。哈希证明引用的是同一制品,不证明制品质量合格。3保留逐例记录才能重算指标并追溯失败,同时应控制敏感评测材料的访问与删除。上线后输入分布、标签和裁判误差持续变化,重新评估应针对实际变化确定范围。