目标函数规定应当学习什么,优化过程决定参数如何接近这一目标。对于持续数日甚至更久的训练,优化过程还必须能够在有限精度下稳定运行,并在中断后保留其历史。相同的模型权重、不同的优化器状态,通常会产生不同的下一步更新。因此,训练的基本对象是一组随时间共同演化的状态,而不仅是参数矩阵。
第17章《优化及泛化》讨论梯度方法与泛化的基础。本章进一步推导自适应更新,明确调度和裁剪的执行顺序,并建立可恢复训练的状态模型。并行状态如何划分以及如何通信,留给第29章《分布式训练》。
19.1动量优化
符号及更新边界
本章的计量约定
将全部可训练参数展平为 \(\theta\in\Real^P\),但实际存储仍可保持各张量的形状。第 \(t\) 次成功更新前的参数为 \(\theta_{t-1}\),\(t\) 从1开始。\(g_t\) 是该次更新全部有效监督词元上的平均损失梯度;不等长微批次的加权聚合见第29章《分布式训练》。所有向量乘除、平方和开方均按元素进行,范数另行标出。推导先使用精确算术,随后再讨论有限精度偏差。
本章主要符号见表19.1。
表 19.1 训练稳定性的主要符号与计量对象。
| 符号 | 含义与范围 |
|---|---|
| \(P,\theta_{t-1}\) | 可训练标量数,以及更新前的 \(P\) 维参数向量。 |
| \(g_t,m_t,v_t\) | 当前梯度、一阶矩估计与二阶原点矩估计,均为 \(P\) 维。 |
| \(\beta_1,\beta_2\) | 两种指数平均的衰减系数,取值在 \([0,1)\)。 |
| \(\eta_t,\lambda,\epsilon\) | 学习率、权重衰减系数和分母稳定项;前两者非负,\(\epsilon>0\)。 |
| \(c,s\) | 正的梯度范数阈值与损失缩放因子。 |
| \(t,a,n\) | 成功更新次数、尝试更新次数、已消费有效目标词元数。三者不必同步增长。 |
动量(Momentum)利用历史梯度抑制方向上的快速摆动。采用指数平均形式,令 \(m_0=0\),则
展开式表明,第 \(i\) 次梯度的权重随时间间隔指数衰减。它不是最近若干步的等权平均。权重总和为 \(1-\beta_1^t\),因此从零初始化的平均在早期被向零压缩。
假设仅为分析初始化效应而有 \(\mathbb E[g_i]=\mu\),由期望的线性性可得
于是 \(\mathbb E[\widehat m_t]=\mu\)。这个结论不要求各步梯度独立,但要求它们的期望相同。实际训练中参数不断变化,梯度分布也随之变化;此时修正消除了零初始化导致的权重总和不足,不能保证得到当前梯度期望的无偏估计。
Adam 的自适应尺度
自适应矩估计(Adaptive Moment Estimation,Adam)同时维护平方梯度的指数平均(Kingma 和 Ba 2015):
\(v_t\) 估计二阶原点矩,不是减去了均值平方的方差。分母按照各坐标过去的梯度尺度调节步长。它是对角形式的预条件更新,不包含坐标之间的曲率耦合,也不等同于逆 Hessian 方法。
为理解分母的作用,考虑某坐标每一步的梯度均为常数 \(g\ne0\)。偏差修正后 \(\widehat m_t=g\)、\(\widehat v_t=g^2\),该坐标的更新量为
当 \(|g|\gg\epsilon\) 时,其幅度接近学习率,方向与梯度相反。这说明 Adam 的更新幅度不能由原始梯度范数单独推断;当历史梯度方向反转时,一阶矩还可能暂时保留旧方向。
\(\epsilon\) 的位置属于算法定义。\(\sqrt{v}+\epsilon\) 与 \(\sqrt{v+\epsilon}\) 一般不相等。若把式(19.4)写成未修正矩的形式,需要同时变换稳定项:
只移动偏差修正到学习率而保持原稳定项,会改变更新,尤其是在平方梯度很小时。比较实现时应比较完整公式,不能只比较优化器名称。
19.2解耦权重衰减
给定经验损失 \(\mathcal L(\theta)\),添加 \(\frac\lambda2\|\theta\|_2^2\) 后,梯度变为 \(g+\lambda\theta\)。对无动量的普通梯度下降,
此时二次惩罚与按学习率缩放的乘性衰减具有相同代数表达。将 \(g_t+\lambda\theta_{t-1}\) 送入 Adam 时,惩罚还会进入 \(m_t\) 和 \(v_t\),并被各坐标不同的历史尺度调整,因而不再等价于上述乘性衰减。
解耦权重衰减(Decoupled Weight Decay)将这两个动作分别定义(Loshchilov 和 Hutter 2019)。本章采用的 AdamW 为
其中矩估计仅接收数据损失的梯度。多个参数组可有不同的 \(\lambda\) 或学习率。偏置与归一化尺度常被排除在衰减组之外,但这是一项需记录的建模选择,不是所有模型都必须遵守的定理。共享权重只应注册和更新一次。
当数据梯度恒为零、矩也为零时,连续 \(T\) 步后
若每步 \(\eta_t\lambda\) 很小且非负,利用 \(\log(1-z)\approx-z\) 得到近似衰减因子 \(\exp(-\lambda\sum_t\eta_t)\)。因此,即使衰减系数不变,改变日程总长度也可能改变累计收缩。所谓“解耦”不表示实际衰减效果完全独立于学习率日程。
两步参数更新
例17.1
取 \(\theta_0=(1,-2)\),\(\beta_1=0.9\)、\(\beta_2=0.99\)、\(\eta_1=\eta_2=0.1\)、\(\lambda=0.01\),并令梯度序列为 \(g_1=(2,-1)\)、\(g_2=(0,3)\)。为清楚显示中间量,本例分母均非零,纸面计算取 \(\epsilon=0\);实际算法仍保留正稳定项。
第一步有 \(m_1=(0.2,-0.1)\)、\(v_1=(0.04,0.01)\),修正后为 \((2,-1)\) 和 \((4,1)\)。因此 \[\theta_1=0.999(1,-2)-0.1(1,-1)=(0.899,-1.898).\] 第二步有 \[\begin{aligned} m_2&=(0.18,0.21),&v_2&=(0.0396,0.0999),\\ \widehat m_2&=(0.947368,1.105263),& \widehat v_2&=(1.989950,5.020101). \end{aligned}\] 自适应方向约为 \((0.67158,0.49330)\),故 \[\theta_2\approx0.999(0.899,-1.898)-0.1(0.67158,0.49330) \approx(0.83094,-1.94543).\] 第一坐标的当前梯度为零,却仍因历史一阶矩而更新;第二坐标经历梯度符号反转,一阶矩从负转正。若只加载 \(\theta_1\) 并把矩清零,这一步不可能得到相同结果。
19.3学习率日程及训练时钟
学习率预热(Learning Rate Warmup)在训练初期逐步增大学习率;余弦衰减(Cosine Decay)在后续阶段平滑减小学习率。它们规定更新尺度随训练进度的变化,不能替代对错误标签、数值溢出或损失归一化错误的诊断。
为避免端点歧义,令计划成功更新次数为 \(S\),预热次数满足 \(1\le W<S\),第 \(t\) 次更新使用
该定义在 \(t=W\) 达到峰值,在 \(t=S\) 达到 \(\eta_{\min}\)。例如 \(S=6,W=2,\eta_{\max}=0.1,\eta_{\min}=0\) 时,六次学习率依次为 \(0.05,0.1,0.085355,0.05,0.014645,0\)。最后一次梯度可以被计算而不改变参数,因此实际预算必须说明是否保留这一零学习率终点。其他日程可以在最后一次有效更新之后才达到零,两种约定不可混记。
调度器的时钟必须明确
读取一个微批次、尝试一次更新、成功更新参数和消费一批有效词元是不同事件。调度依据成功更新次数时,数值溢出导致的跳步不推进日程;依据消费词元数时,跳步是否消费数据以及日程如何推进必须另行定义。记录一个含义不明的“step”不足以恢复训练。
当批量或有效序列长度随时间变化时,按词元数调度可以直接对应数据预算,但不保证与按步调度产生相同参数轨迹。改变总预算 \(S\) 后重新构造余弦曲线,也会改变恢复点之后的学习率;这属于更改训练方案,应保存新的日程版本。
19.4有限精度、损失缩放及梯度裁剪
数值异常定位
有限精度同时限制可表示范围和有效数字。前向矩阵乘法溢出、归一化统计不准确、概率对数的下溢以及梯度累加误差,是不同位置的问题。交叉熵宜通过稳定的 Log-Sum-Exp 计算:
右式的指数输入不为正,从而避免对巨大正数直接取指数。若输入本身已含非有限值,这个恒等改写不能恢复丢失的信息。
损失缩放(Loss Scaling)令 \(\widetilde{\mathcal L}=s\mathcal L\)。在精确算术下,反向得到 \(\widetilde g=sg\),更新前除以 \(s\) 即恢复原梯度。在低精度中,放大可以使某些过小梯度免于下溢,但也可能使较大梯度溢出。动态策略因而根据非有限梯度反馈调整 \(s\),并在发生溢出时跳过更新。缩放并不能修正前向激活已经发生的溢出,也不能弥补不适合该运算的精度范围。
范数裁剪的几何意义
梯度范数裁剪(Gradient Norm Clipping)以阈值 \(c>0\) 定义
零梯度保持为零。这个向量是 \(g_t\) 到闭球 \(\{u:\|u\|_2\le c\}\) 的欧氏投影:球内点无需改变;球外最短距离点与 \(g_t\) 同方向且范数为 \(c\)。因此它在触发时保持整向量方向,而逐坐标截断一般改变方向。
取 \(g=(3,4)\)、\(c=2\),得到 \(g'=(1.2,1.6)\)。若损失缩放为 \(s=8\),先裁剪 \((24,32)\) 到范数2再除以8,将得到 \((0.15,0.2)\),范数只有0.25。正确顺序是先恢复未缩放梯度,再聚合完整更新的梯度并裁剪。对于参数分片,全局范数需要统计不重复的逻辑参数;数据并行副本不能被重复计数。
裁剪限制输入优化器的梯度,不直接保证 AdamW 参数更新的范数不超过 \(\eta_tc\)。矩估计、分母和权重衰减仍会改变更新尺度。非有限梯度应先判定并处理,不能期待将无穷乘以零得到有效方向。
19.5训练状态闭合性
充分状态及恢复等级
将下一次计算表示为状态转移
其中 \(\mathcal A\) 是版本固定的数据、模型配置和运行环境。检查点(Checkpoint)应保存足以决定后续计算的 \(\mathcal S_t\)。常见组成见表19.2。
表 19.2 训练检查点的状态组成
| 状态 | 保存原因 |
|---|---|
| 参数与缓冲区 | 决定前向计算,包括不属于可训练参数的持久缓冲。 |
| 优化器状态 | 一阶矩、二阶矩、步数、参数组、主精度副本及稳定项配置。 |
| 日程与计数 | 成功更新、尝试更新、消费词元和学习率日程位置。 |
| 精度状态 | 动态缩放因子、增长或回退计数等。 |
| 数据位置 | 数据版本、分片、排列、采样器、已提交游标及尚未提交的预取状态。 |
| 随机状态 | 各进程、各设备及数据工作进程使用的随机数生成器状态。 |
| 资产与环境 | 分词器、模板、掩码规则、模型结构、代码和依赖版本的标识。 |
保存随机种子不同于保存随机数生成器的当前位置。种子只能重建起点;训练中 Dropout、采样和数据增强已经消耗了许多随机数。恢复时还应避免模型初始化或数据预取在载入随机状态后意外消费它们。
语义续训保留目标、资产和必要状态,允许数值误差带来的轨迹差异;数值接近的续训进一步要求相同运算组织并给定误差容限;逐位一致的续训要求算子、归约顺序、并发及随机行为均满足确定性条件。完整状态是精确恢复的必要条件,却不单独保证不同设备和软件版本间逐位相同。1
一致性边界及原子发布
在一次完整更新之后、下一批数据消费之前保存,是较容易说明的一致性边界。若在梯度累积途中保存,还必须保存部分梯度、累计有效词元数、微批次位置及相关随机状态。否则恢复后会丢失或重复部分贡献。
后台写入检查点时,应先获得不可变快照。直接把持续更新的参数张量交给异步写线程,可能将不同更新时刻的张量混在同一文件中。分布式情况下还需确认全部分片属于同一代状态。
发布过程可采用“写分片、验证清单、提交代号”的顺序。分片写入唯一代号的暂存位置,记录大小与摘要;全部必需分片持久化后,提交包含资产版本和状态边界的清单。读取者只接受已经提交且清单完整的代。文件系统重命名和对象存储的发布机制具有不同语义,应由存储层提供明确保证,不能把“文件存在”等同于“检查点完整”。
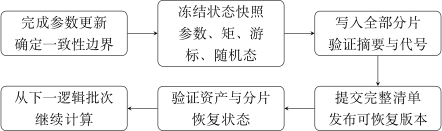
19.6训练算法及诊断
算法19.1 具有明确跳步语义的训练更新
输入:固定版本数据与初始状态,成功更新预算 \(S\),裁剪阈值 \(c\)。输出:最终训练状态与已提交检查点。本算法选择“溢出批次已消费但不更新”的策略,并分别记录三种计数。
在一致性边界恢复状态;若为新训练,初始化参数、矩、随机生成器及数据游标,令 \(t=a=n=0\)。
当 \(t<S\) 且尚有允许消费的数据时,构造完整更新所需的微批次,记录有效目标总数 \(N\)。若 \(N=0\),不执行除法或参数更新,记录原因并继续。
清空旧梯度,以有效词元加权目标执行前向和缩放反向。恢复未缩放梯度,完成必要的梯度聚合。令 \(a\leftarrow a+1\)、\(n\leftarrow n+N\),提交本批数据消费位置。
若梯度非有限,降低缩放因子,清空梯度,记录异常;保持参数、矩和成功更新计数不变。连续异常超过预设停止条件时保存诊断信息并停止。
否则按式(19.12)裁剪,以 \(\eta_{t+1}\) 更新矩及 AdamW 参数,令 \(t\leftarrow t+1\),再更新缩放器的成功计数。
按预定间隔记录损失、梯度范数、更新范数及学习率,执行固定验证;到达保存条件时,按图19.1提交完整检查点。
也可以选择在溢出后重放同一批次,但必须恢复相应随机状态、数据游标以及前向可能修改的缓冲区,并限制重试次数。改变这一策略会改变数据消费轨迹,不能在恢复时隐式切换。
诊断至少联合观察未裁剪梯度范数、裁剪比例、实际更新范数、学习率、缩放因子和有效词元数。对参数组 \(j\),可记录相对更新量
参数接近零时该比值敏感,应同时报告绝对量。损失尖峰若伴随词元数锐减,先检查归一化和数据;若伴随非有限激活,定位首次异常算子;若梯度有限但更新异常,则检查矩状态、稳定项和学习率。仅观察经过裁剪后的范数,可能掩盖持续发生的梯度异常。
验证指标须按有效目标词元聚合,而非简单平均批次均值。用于选择检查点的验证集已经参与模型选择,不能再被当作独立的最终测试证据。断点恢复的验证还应比较下一批标识、学习率、矩状态及后续若干次更新;只比较加载前后权重相等,无法证明后续训练一致。
浮点加法不满足严格结合律。即使输入相同,改变并行归约树也可能改变末位结果;训练迭代可能逐步放大这种差异。↩︎