模型优化围绕质量、容量和执行成本组织四类方法:量化调整数值表示,剪枝选择保留的结构,低秩分解用矩阵因子形成近似,蒸馏把教师行为转移给学生。每种方法都需要说明近似对象、误差目标、训练或校准条件,以及目标硬件上的执行方式。
本章先建立量化映射与低精度计算的数值基础,再推导剪枝、低秩分解和蒸馏,最后讨论组合优化与同条件比较。知识蒸馏只有在学生结构或表示更省资源时才产生压缩收益;参数高效微调中的 LoRA 学习低秩更新,低秩压缩则以因子替换原矩阵。
34.1压缩对象及误差预算
局部近似的边界
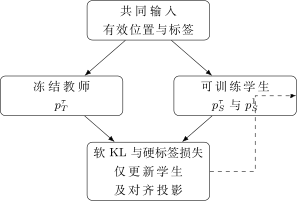
分析线性层时采用列向量约定 \(y=Wx+b\),其中 \(W\in\mathbb R^{m\times n}\)。偏置若未说明则保持不变。剪枝敏感度以可微损失的局部展开为依据,二阶结论不自动适用于大幅参数变动。低秩最优性针对明确的矩阵范数或校准输入分布。蒸馏教师在学生更新期间冻结,师生输出类别及监督位置已对齐。
| 符号 | 含义与形状 |
|---|---|
| \(W,\widehat W,E\) | 原矩阵、压缩后矩阵及误差 \(E=\widehat W-W\),形状 \(m\times n\)。 |
| \(x,X,C_x\) | 输入 \(x\in\mathbb R^n\);校准列矩阵 \(X\in\mathbb R^{n\times N}\);二阶矩 \(C_x=\mathbb E[xx^\mathsf T]\)。 |
| \(M,k,s\) | 二值剪枝掩码、保留权重数量、单权重存储字节数。 |
| \(w,g,H\) | 展平参数向量、损失梯度和 Hessian,形状分别为 \(P\)、\(P\)、\(P\times P\)。 |
| \(r,\sigma_i\) | 近似秩与降序排列的奇异值。 |
| \(A,B\) | 低秩因子,\(A\in\mathbb R^{m\times r}\),\(B\in\mathbb R^{r\times n}\)。 |
| \(z_T,z_S,C,\tau\) | 教师和学生的 \(C\) 维 logits、类别数与正温度。 |
| \(p_T^\tau,p_S^\tau,\lambda\) | 温度分布与硬软目标混合系数,\(0\leq\lambda\leq1\)。 |
| \(H_T,H_S,P_h\) | 展平有效位置后的师生表示与对齐投影,形状为 \(N_t\times d_T\)、\(N_t\times d_S\)、\(d_S\times d_T\)。 |
模型压缩(Model Compression)可以减少权重容量、计算次数、数据搬运或特定结构规模。这些目标不等价。知识蒸馏(Knowledge Distillation,KD)首先是一种监督转移方法,只有学生的实际结构或表示更省资源时才形成压缩。混合专家架构的稀疏激活也不等于压缩,因为它可能同时增大总参数量。
比较方案时,应固定原模型、任务、输入长度分布、批量、输出质量要求与目标设备。局部误差、任务指标和系统指标分别测量:矩阵 Frobenius 误差描述数值近似,任务正确率描述行为,峰值内存和延迟描述执行成本。不能让其中一个指标替代其他两类。
34.2量化
量化对象及基本符号
位宽对象
仅权重量化(Weight-Only Quantization)降低权重存储位宽,而输入激活可以保持浮点。记号 W4A16 通常表示四比特权重与十六比特激活,但仍未说明码本、分组、乘法指令、累加精度及输出类型。W8A8 进一步降低激活位宽,键值缓存量化(Key-Value Cache Quantization)则压缩解码历史中的键与值。这三种对象具有不同生命周期和误差传播方式。
权重通常可以离线统计并一次编码;激活随请求和位置变化;缓存随生成增长并被反复读取。只压缩权重不会按同一比例降低长上下文缓存,激活位宽也不决定累加器位宽。描述一个低精度模型时,应分别给出存储、乘法输入、累加和输出的表示。
表 34.1 主要符号。矩阵乘法采用列向量输入约定。
| 符号 | 含义 |
|---|---|
| \(x,q,\widehat x\) | 原始实数、整数码值、恢复实数 |
| \(s,z\) | 正尺度与整数零点 |
| \(q_{\min},q_{\max}\) | 有限整数编码范围 |
| \(\ell,u\) | 实际可恢复范围的下端与上端 |
| \(W,X,Y\) | 权重 \(d_o\times d_i\)、输入 \(d_i\times n\)、输出 \(d_o\times n\) |
| \(E,C,H\) | 权重误差、输入二阶矩、局部重建 Hessian |
| \(D\) | 正对角通道缩放矩阵,\(d_i\times d_i\) |
| \(g,b\) | 每组元素数与码值位宽 |
量化编码及恢复
仿射量化(Affine Quantization)采用
其中量化尺度(Quantization Scale) \(s\) 决定相邻可恢复值的间距,零点(Zero Point) \(z\) 是实数零对应的整数码。要求 \(z\) 是编码范围内的整数,就可以精确恢复零;这对于填充、稀疏值和某些算子的零语义很重要。反量化(Dequantization)返回一个近似实数,而不是恢复原始数值。整数推理的此类表示与算术关系见 Jacob 等人的研究(Jacob 等 2018)。
对希望覆盖的区间 \([a,b]\),先扩展为 \(a'=\min(a,0)\)、\(b'=\max(b,0)\)。若 \(a'<b'\),一种常见初始化是
由于 \(z\) 被取整,真正的恢复端点是 \(\ell=s(q_{\min}-z)\)、\(u=s(q_{\max}-z)\),不一定恰好为 \(a',b'\)。端点调整和舍入规则应共同写入协议,不能一边用理想区间证明误差,一边用另一组实际端点执行。
全零张量需要显式约定,例如取任意固定正 \(s\)、合法 \(z\),全部编码为 \(z\)。不应令 \(s=0\) 后继续计算 \(\frac{x}{s}\)。非零常量在扩展区间包含零后不再是零宽区间;若采用其他常量特例,也必须保证编码与恢复一致。
对称量化及码值范围
对称量化(Symmetric Quantization)在有符号编码下令 \(z=0\)。例如选择有效码值范围 \([-127,127]\),令 \(c=\max|x|>0\),可取 \(s=\frac{c}{127}\)。八比特有符号存储本身还可表示 \(-128\),但该对称方案有意不使用它。若使用 \([-128,127]\),可恢复范围不再关于零完全对称,尺度约定也应重新说明。1
最近舍入(Round to Nearest,RTN)在等距离点需要平局规则,例如取偶数。向零截断会产生不同偏差,不能套用最近舍入的所有结论。除非特别说明,本章采用最近舍入,数值例题避免依赖未声明的平局选择。
舍入、截断及饱和误差
均匀量化的误差边界
\(s>0\)、\(z\in\mathbb Z\) 固定,码值是连续整数区间,最近舍入后执行范围截断。计算暂视为精确实数运算,忽略尺度本身的浮点舍入。
两类误差的分解
当 \(x\in[\ell,u]\) 时,其最近格点距离至多为半个步长,因此
令 \(x_c=\operatorname{clip}(x,\ell,u)\),则总误差可分解为
第一项是范围内格点误差,第二项是饱和误差(Saturation Error)。若 \(x>u\),恢复值固定为 \(u\),误差绝对值为 \(x-u\);若 \(x<\ell\),则为 \(\ell-x\)。超出范围的误差不受 \(\frac{s}{2}\) 全局约束。裁剪(Clipping)缩小范围会减小多数数值的步长,也会增加尾部饱和损失。
在误差均匀分布于 \([-\frac{s}{2},\frac{s}{2}]\) 的理想模型下,均方误差为
但真实权重可能聚集于格点附近,激活可能含大量零,误差也可能与输入相关。这一噪声模型适合估计量级,不能当作所有张量的实测误差公式。
给定连续密度 \(p(x)\),实际均方误差可写为
其中 \(Q_s\) 为范围内最近格点映射。前两项是尾部损失,最后一项是舍入损失。这给出了选择裁剪范围的统计目标,而不是一味追求无溢出或最小尺度。
例26.1
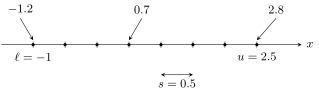
取三比特无符号码 \(q\in\{0,\ldots,7\}\),\(s=0.5,z=2\),实际恢复范围为 \([-1,2.5]\)。对输入 \((-1.2,-0.6,0,0.7,2.8)\),编码、恢复与误差见表34.2。
表 34.2 给定尺度与零点的手工编码结果,误差定义为 \(\widehat x-x\)。
| \(x\) | \(\operatorname{round}(\frac{x}{s})+z\) | \(q\) | \(\widehat x\) | 误差 |
|---|---|---|---|---|
| \(-1.2\) | \(0\) | \(0\) | \(-1\) | \(0.2\) |
| \(-0.6\) | \(1\) | \(1\) | \(-0.5\) | \(0.1\) |
| \(0\) | \(2\) | \(2\) | \(0\) | \(0\) |
| \(0.7\) | \(3\) | \(3\) | \(0.5\) | \(-0.2\) |
| \(2.8\) | \(8\) | \(7\) | \(2.5\) | \(-0.3\) |
均方误差为 \[\frac{0.04+0.01+0+0.04+0.09}{5}=0.036.\] 最后一个值的误差超过 \(\frac{s}{2}=0.25\),因为发生饱和。第一个值也在恢复范围之外,但舍入后码值尚未越界;因此检测饱和应依据实数可恢复范围与误差语义,不能仅计数最终整数裁剪操作是否改变码值。
粒度及校准分布
尺度共享范围
逐张量量化(Per-Tensor Quantization)为整个张量使用同一尺度。逐通道量化(Per-Channel Quantization)允许每个通道独立选择尺度。对 \(W\in\Real^{d_o\times d_i}\),若每个输出通道对应一行,则逐输出通道尺度为 \(s_i\);改变矩阵存储方向时,不能仅按数组的“第一维”推定通道含义。
分组量化(Group-Wise Quantization)在每个明确分组内共享尺度和必要零点。线性层常按每行的输入方向分组,大小为 \(g\);最后一组可能不足 \(g\),仍需元数据及布局约定。粒度越细,越容易适应局部动态范围,但尺度数量、读取成本和内核约束也随之增加。
例如
使用有效三比特对称码 \([-3,3]\),逐张量尺度 \(\frac{20}{3}\) 使第一行全部恢复为零。第二行的 \(10\) 恰在平局点,若采用取偶数则恢复为 \(\frac{40}{3}\);这个结果依赖明确舍入规则。逐行尺度分别为 \(\frac{0.2}{3}\) 和 \(\frac{20}{3}\),第一行恢复为 \((\frac{2}{15},0.2,-\frac{2}{15})\),其平方误差均值为 \(\frac{2(\frac{1}{30})^2}{3}=\frac{1}{1350}\),而逐张量第一行误差均值为 \(0.02\)。第二行保持原量化结果。这说明异尺度通道共享步长可能损害小值通道,不证明逐通道量化总能提高任务质量。
若原始 \(P\) 个元素每个 \(16\) 位,量化码每个 \(b\) 位,每组有 \(h\) 字节元数据且忽略填充,则总存储近似为
四比特码、\(g=64,h=4\) 时,每元素约 \(0.5625\) 字节,相对两字节基线压缩约 \(3.56\) 倍,并非恰好四倍。真实矩阵逐行分组时,应逐行求组数;对齐、索引和未量化层还会增加成本。
校准分布估计
量化校准(Quantization Calibration)用代表性输入估计激活范围、误差或通道重要性。最小最大值策略尽量覆盖观测极值,百分位策略允许一定尾部裁剪,直方图或重建误差策略显式权衡式(34.7)。这些策略使用不同目标,不存在脱离数据分布的统一最优范围。
校准应覆盖预期语言、领域、模板、长度和生成阶段。只使用短输入估计长上下文缓存范围,或只观察预填充却假设逐词解码完全相同,可能遗漏实际分布。最终测试数据应与范围、位宽和算法选择隔离,避免把评估集变成调参集。
静态量化(Static Quantization)在部署前固定激活尺度;动态量化(Dynamic Quantization)在运行时按张量、词元或组更新尺度。动态策略减少对固定范围的依赖,却需要归约、缩放与元数据处理。它也不能保证不存在异常值;只要一个组内极端值与大量普通值共存,动态最大值尺度仍会造成精度损失。
输出误差传播
令 \(E=\widehat W-W\),则单输入误差为 \(Ex\),满足
若输入二阶矩 \(C=\mathbb E[xx^{\mathsf T}]\) 存在,则
因此同样的权重均方误差可能产生不同输出误差:高频或高幅值输入方向赋予对应列更大权重。下游非线性和残差还会重新传播误差,局部重建并不等同于端到端任务最优。这个区别构成激活感知方法与二阶补偿方法的共同出发点。
GPTQ 的二阶误差补偿
(选修)
局部重建目标
生成式模型训练后量化(GPTQ)利用层输入构建局部重建目标,并以二阶信息补偿量化误差(Frantar 等 2022)。固定校准输入 \(X\in\Real^{d_i\times n}\),希望在离散码本约束下减小 \(\|(W-\widehat W)X\|_F^2\)。每一输出行可以分别讨论。
把某行权重转为列向量 \(w\in\Real^{d_i}\),令更新为 \(\delta\)。重建损失增量为
这是固定线性层重建的精确二次形式,不是整个语言模型任务损失的精确 Hessian。
单坐标量化补偿
对当前尚可调整的坐标集合,\(H\) 正定且码本已固定。将坐标 \(i\) 固定为恢复值 \(\widehat w_i\),其余坐标暂可连续调整。若校准矩阵秩不足,可加入正阻尼 \(\lambda I\),此时优化的已是正则化重建目标。
约束二次问题的解
记 \(d=\widehat w_i-w_i\),\(e_i\) 为第 \(i\) 个标准基向量。求解
拉格朗日函数为 \(\tfrac12\delta^{\mathsf T}H\delta+\mu(e_i^{\mathsf T}\delta-d)\)。令梯度为零,有 \(H\delta+\mu e_i=0\),所以 \(\delta=-\mu H^{-1}e_i\)。代回约束得到
若用量化残差 \(w_i-\widehat w_i\) 表示,则更新前有负号。算法中的符号差异常来自残差方向,不应机械照抄。非对角项决定其他坐标如何补偿;若输入不相关且 \(H\) 对角,则没有跨坐标补偿。
固定该坐标后,剩余自由集合的逆 Hessian 可由当前逆矩阵 \(K=H^{-1}\) 消去相应行列:
逐坐标直接执行代价较高。GPTQ 采用一致的处理顺序、分块延迟更新及 Cholesky 形式组织这些计算,以提高大矩阵处理效率(Frantar 等 2022)。这些组织方式不能把逐层贪心的离散选择变成全局最优保证。
(选修) 例26.2
设
采用间隔 \(0.5\) 的格点,先把第一坐标量化为 \(0.5\),\(d=0.2\)。式(34.14)给出 \(\delta=(0.2,-0.1)^{\mathsf T}\),故第二坐标变为 \(0.5\),恰好已在格点上。补偿误差为 \(\tfrac12\delta^{\mathsf T}H\delta=0.03\);若只改变第一坐标,误差为 \(0.04\)。该例显示相关输入允许利用另一坐标抵消输出扰动,不意味着每一步补偿后都无需再量化其他坐标。
算法34.1 二阶补偿量化的概念流程
输入:层权重、校准输入、量化格点、坐标顺序与阻尼。输出:量化码值及元数据。状态:当前连续权重、自由坐标集合、曲率分解。
根据 \(X\) 构建重建曲率,处理不可观测方向并加入所需阻尼,得到稳定分解。
按固定顺序选择自由坐标,对其当前补偿后的值作格点选择。
根据式(34.14)将残差传播到其余自由坐标,已固定坐标不再改变;更新自由子问题。
所有坐标处理后停止,保存格点、分组、处理顺序及布局。实际高效实现使用分块与分解复用,避免重复显式求逆。
不变量:已固定权重始终位于指定格点;校准曲率只约束该重建问题,不能替代独立任务评价。
AWQ 及 SmoothQuant 的通道缩放
通道缩放恒等式
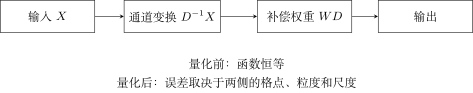
对任意正对角矩阵 \(D=\operatorname{diag}(d_1,\ldots,d_{d_i})\),有
第 \(j\) 列权重乘以 \(d_j\),对应输入通道除以 \(d_j\),未量化的函数不变。但量化不是线性算子,因此对右侧两部分量化后的误差一般不同于直接量化左侧。通道缩放的作用是重新分配表示难度,不能凭恒等式声称量化后仍完全等价。
激活感知权重量化(Activation-Aware Weight Quantization,AWQ)重点关注仅权重量化中的显著输入通道(Lin 等 2023)。用 \(\mathcal Q\) 表示量化后恢复的权重,其校准目标可以写为
若某一权重的组步长从 \(\Delta\) 变为 \(\Delta'\),缩放后换回原坐标的最近格点误差界为 \(\frac{\Delta'}{2d_j}\)。只有当 \(\frac{\Delta'}{d_j}\) 相对原步长更小,相关方向才获得更细分辨率。过大缩放可能提高整个组的最大值,损害其他通道;不能把所有通道无限放大。
AWQ 使用激活统计构造缩放候选并进行有限搜索,而不是根据权重幅值单独决定重要性。这里“保护显著通道”不意味着最终必须把这些通道保留为高精度;可通过尺度变换仍然输出统一低比特权重。候选范围、裁剪和校准数据影响结果,也不能从方法名称推定其不会对校准分布过拟合。
激活离群值迁移
平滑量化(SmoothQuant)利用同一恒等式缓解激活离群值,使权重与激活都更适合低精度计算(Xiao 等 2022)。令 \(a_j=\max_t|X_{jt}|\)、\(b_j=\max_i|W_{ij}|\),对非零通道可取
变换后的输入最大幅值为 \(\frac{a_j}{d_j}=(a_jb_j)^{1-\alpha}\),权重列最大幅值为 \(b_jd_j=(a_jb_j)^\alpha\)。在 \(\alpha=\frac{1}{2}\) 时,两者在该通道达到相同最大幅值。零通道、极小值以及尺度上下界需要显式处理,避免除零或异常放大。
例如 \(a=(100,1)\)、\(b=(0.01,1)\),\(\alpha=\frac{1}{2}\) 时 \(d=(100,1)\),两个变换后张量的对应通道最大幅值均为 \((1,1)\)。这个构造例子展示数值范围如何迁移,不说明任意网络都能如此平衡。选择 \(\alpha\) 仍需考虑两边实际量化粒度与误差。
AWQ 以权重量化误差及激活重要性为中心,SmoothQuant 则平衡权重和激活的量化难度。它们可共用代数视角,但目标与校准统计不同。缩放若吸收到前一归一化或线性层,必须保持所有分支一致;同一输入被多个投影共享时,不能只改其中一个消费者。跨越非线性随意移动缩放通常不保持函数不变。
PTQ、QAT 及低精度训练
训练后量化(Post-Training Quantization,PTQ)从已训练权重出发,利用统计校准、搜索或局部重建产生量化模型,通常不进行完整任务训练。简单最大值权重量化可以不用激活数据,GPTQ、AWQ 和 SmoothQuant 则使用输入统计;所以“PTQ 不需要数据”并非一般定义。
量化感知训练(Quantization-Aware Training,QAT)在训练前向中加入伪量化(Fake Quantization),即 \(\widehat x=D(Q(x))\),让优化过程适应部署格点(Jacob 等 2018)。浮点主参数可以保留,前向使用恢复后的近似值。因最近舍入几乎处处导数为零、跳变处不可导,常使用直通估计器(Straight-Through Estimator,STE),例如把反向近似为
这是人为选择的优化代理,不是真实量化函数的导数;尺度与裁剪参数的学习也需要相应规则。前向模拟的舍入、饱和和粒度若与部署不一致,训练恢复的质量可能无法转移到实际内核。
QAT 不要求训练器本身用目标整数指令完成全部运算。低精度训练(Low-Precision Training)则进一步让某些前向、反向矩阵乘法或状态采用低精度执行,需要管理累加、主权重和更新尺度。QLoRA 的冻结量化基座加可训练适配器,是另一种参数与计算边界;它不等同于对全部量化码值做梯度更新,详见第21章《参数高效微调》。
FP8 及非均匀表示
(选修)
浮点格点随指数变化
八位浮点(8-bit Floating Point,FP8)不是一种均匀整数网格。对普通规格化二进制浮点数,可以写成 \((-1)^s2^{e-\beta}(1+\frac{f}{2^m})\),其中 \(s\) 为符号位、\(e\) 为指数域、\(\beta\) 为偏置、\(m\) 为尾数字段位数。一个指数区间内间隔为 \(2^{e-\beta-m}\),随数量级变化。
在远离溢出和下溢、采用最近舍入的规格化区域,单位舍入误差量级为 \(2^{-(m+1)}\),描述的是相对误差尺度;不能套用单一全张量绝对误差界。次正规数、零附近以及饱和区域需要分别分析。
Micikevicius 等人提出的 FP8 编码包括 E4M3 与 E5M2(Micikevicius 等 2022)。二者均有一个符号位,分别分配四位指数三位尾数、五位指数两位尾数。该论文中 E4M3 最大有限值为 \(448\)、最小正规数为 \(2^{-6}\);E5M2 最大有限值为 \(57344\)、最小正规数为 \(2^{-14}\)。E4M3 通过减少特殊值编码扩展范围,不表示无穷大;E5M2 使用不同的特殊值规则。其他编码变体不能仅凭名称共享这些端点。
E4M3 在相似数值区间拥有更细尾数,E5M2 提供更大动态范围。具体训练不应机械地把全部张量转换为同一格式;梯度、权重、激活与归约具有不同数值需求。2
缩放、累加及更新
FP8 张量仍常需要外部尺度。例如令 \(\widehat x=s\,\operatorname{cast}_{\mathrm{FP8}}(\frac{x}{s})\),尺度把当前范围映射到有限编码区间。由当前张量估计尺度需要额外归约;用历史最大值延迟更新尺度会引入状态,并可能来不及覆盖分布突变。静态、动态和分块尺度必须绑定实际执行协议。
低精度乘法不意味着低精度累加。长内积可能在低位累加中丢失小贡献或溢出,因而通常需要更宽累加器、分段归约或其他受支持的数值策略。若优化器更新量小于权重所在格点间距,直接在粗格点中更新可能完全消失;高精度主参数或合适舍入方式可以缓解,但也增加状态成本。是否支持某种 FP8 乘法、累加和布局,由具体硬件与内核决定,不能由文件类型推出。
非均匀四比特码本 NF4 则面向另一种分布假设,第21章《参数高效微调》已经说明其在 QLoRA 中的职责。对非均匀码本,局部最近舍入误差由相邻码字间隔控制,不能把统一整数步长 \(\frac{s}{2}\) 直接套到所有区间。
整数计算及反量化融合
整数点积中的零点修正
设一个输出为 \(y=\sum_{j=1}^{d_i}w_jx_j\),权重与激活使用尺度 \(s_w,s_x\) 和零点 \(z_w,z_x\)。则恢复后的点积为
对称权重 \(z_w=0\) 可消除其中部分修正,但激活零点仍可能存在。偏置可在兼容尺度下加入累加器,输出若还要保持整数表示,则需要再量化(Requantization):按输出尺度重新舍入并裁剪。
例如 \(q_w=(2,-1)\)、\(z_w=0,s_w=0.5\),\(q_x=(5,1)\)、\(z_x=2,s_x=0.25\),恢复值为 \(w=(1,-0.5)\)、\(x=(0.75,-0.25)\)。整数修正和为 \(2(5-2)+(-1)(1-2)=7\),乘 \(0.125\) 得到 \(0.875\),与恢复实数点积一致。若省略激活零点修正,整数点积为 \(9\),将错误得到 \(1.125\)。
累加器必须覆盖和的动态范围。即使输入均为八比特,\(d_i\) 项乘积之和也未必适合八位或十六位累加。分组尺度若随 \(j\) 变化,尺度不能直接提出整个求和号外,需要逐组累加和缩放,这正是粒度影响内核设计的原因之一。
三种运行路径
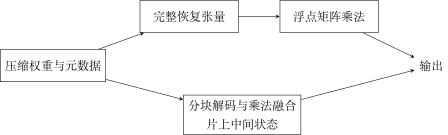
量化文件可以在加载时完整恢复成高精度权重,此时减少的是磁盘与传输体积,驻留权重可能没有减少。也可以在每次前向先恢复一个完整权重张量,再调用浮点矩阵乘法;此时额外读写高精度临时数组可能抵消带宽节省。第三种方式是融合反量化(Fused Dequantization):内核读取压缩块,在寄存器或片上工作区中恢复并立即参与计算,避免完整中间张量往返显存。
融合路径仍可能使用浮点乘法,而原生低精度矩阵乘法则直接消费硬件支持的低精度操作数。二者都可能有收益,但收益机制不同。比特打包、尺度加载、布局转置、尾块处理和线程组织共同决定性能,算法名称本身不保证某条路径被执行。
带宽、算力及端到端收益
若某层执行 \(F\) 次浮点等价操作、传输 \(B\) 字节,计算吞吐上界为 \(C\)、带宽为 \(\mathcal B\),一个简化下界是
量化主要减小 \(B\) 时,带宽受限的解码可能受益;高批量计算受限场景则更依赖可用乘法指令与内核效率。反量化、归约和调度增加的成本还未包含在这个下界里。
若原系统时间有比例 \(f\) 可以加速为 \(a\) 倍,其他部分不变,则总体加速比为 \(\frac{1}{[(1-f)+\frac{f}{a}]}\)。例如只有 \(60\%\) 时间受益,即使该部分快四倍,整体也仅约 \(1.82\) 倍。词元化、调度、缓存、通信和采样都可能成为剩余瓶颈。因此文件压缩率、层内加速和请求时延改善应分别报告。
键值误差及发布边界
缓存误差传播
设一个查询 \(q\) 的分数为 \(z_j=\frac{q^{\mathsf T}k_j}{\sqrt{d_k}}\),量化键误差为 \(e_{k,j}\),则分数误差为 \(\delta z_j=\frac{q^{\mathsf T}e_{k,j}}{\sqrt{d_k}}\)。一阶近似下,注意力概率变化为
若值误差矩阵为 \(E_V\)、原输出 \(o=V^{\mathsf T}p\),则一阶输出误差为 \(\delta o\approx V^{\mathsf T}\delta p+E_V^{\mathsf T}p\),另有二阶交叉项。键误差改变权重分配,值误差改变被聚合内容,二者不能只用一个平均缓存误差完全概括。
缓存范围还涉及不同层、头、位置与新旧词元的分布。保留近期高精度尾部或分块校准属于明确设计选择,不是低位缓存的必要定义。发布评估应包含长上下文、不同生成长度和实际缓存格式;短序列困惑度不足以验证全部缓存行为。
制品及证据
算法34.2 量化制品的形成
输入:固定模型、校准集、目标位宽与内核约束、质量预算。输出:量化制品及版本清单。状态:校准统计、候选尺度、局部与整模型误差记录。
先明确目标后端可消费的布局、粒度、零点和累加约定,固定高精度参考与输入协议。
采集校准统计,依据所选方法计算尺度、通道变换或二阶补偿,保存异常值与零通道处理规则。
按目标布局编码权重和元数据,使用与部署一致的恢复语义评估局部及整体质量;候选不满足预算时调整指定配置,而非隐藏回退。
固定制品身份,在目标硬件上确认实际内核与负载表现。只有质量与执行证据同时成立时,才形成可发布版本;保存原始基线以支持回滚。
不变量:编码与消费协议一致;每个性能结论绑定硬件、形状、批量、长度与精度条件。该流程是发布要求,本章没有执行这些测量。
清单应记录模型与词表身份、量化对象、码本、尺度粒度、零点、舍入、裁剪、校准版本、布局、后端和必要通道重排。剪枝或适配器合并改变权重后,原尺度与校准结论未必继续成立,需要形成新的制品。对不支持的内核发生高精度回退时,应直接报告实际路径。
首词元时延(Time to First Token,TTFT)、每输出词元时间(Time per Output Token,TPOT)、吞吐和峰值内存分别描述不同负载特征。测量需要预热、设备同步和固定输入分布;驻留权重、缓存与临时工作区也应分开计量。数学误差界、给定数值算例和目标设备实测构成不同证据,不能互相替代。
低精度计算的完整契约
量化方案由可表示值、映射规则、统计分布、张量布局和执行内核共同定义。位宽只是其中一项;同样的四比特文件可以对应不同误差和完全不同的计算路径。
34.3剪枝
剪枝及敏感度
幅值剪枝的最优性范围
剪枝(Pruning)通过删除权重或结构减少模型自由度。非结构化剪枝(Unstructured Pruning)使用逐元素掩码 \(M\in\{0,1\}^{m\times n}\),得到 \(\widehat W=M\odot W\)。若仅要求保留 \(k\) 个原有权重,且保留的数值不允许调整,则
因此保留绝对值最大的 \(k\) 个元素,使被删除的平方和最小。这是幅值剪枝(Magnitude Pruning)在特定权重重建目标下的依据;阈值处出现相同幅值时,应固定并列选择规则以得到可复现掩码。
最小权重误差不等于最小任务误差。若一个较小权重连接的输入幅度很大,或者该方向对输出损失极为敏感,删除它可能比删除较大权重更危险。不同层还可以通过尺度重参数化维持近似相同函数,直接跨层比较权重幅值因此可能受到表示尺度影响。
一阶和二阶近似
设损失为 \(\mathcal L(w)\),参数变化为 \(\Delta w\)。二阶展开为
其中 \(g=\nabla\mathcal L(w)\),海森矩阵(Hessian Matrix) \(H=\nabla^2\mathcal L(w)\) 描述局部二阶变化。只删除第 \(q\) 个权重时 \(\Delta w=-w_qe_q\),故
一阶量反映当前位置沿删除方向的变化,绝对值 \(|g_qw_q|\) 可作为影响幅度的启发式;它不保留变化方向。接近驻点时 \(g\approx0\),若采用对角曲率近似,可用 \(\frac{H_{qq}w_q^2}{2}\) 比较局部损失增量。经典 Optimal Brain Damage 使用二阶敏感度研究剪枝。(LeCun, Denker, 和 Solla 1989)
例如 \(w=(0.1,1)\)、\(g=0\)、\(H=\operatorname{diag}(1000,1)\)。删除第一个权重的二阶代价为 \(\frac{1000\cdot0.1^2}{2}=5\),删除第二个为 \(\frac{1}{2}\)。幅值排序会优先删除第一个,曲率排序却得出相反结论。这个例子说明敏感度需要同时考虑参数幅度与局部损失几何。
多个参数一起删除时,交叉项 \(H_{ij}\Delta w_i\Delta w_j\) 不再消失。因此逐个计算的对角分数之和一般不等于联合删除代价。神经网络真实 Hessian 也未必正定,局部近似还可能在大幅剪枝时失效;常见工程方法使用正半定重建曲率、阻尼或分块近似,以控制计算和数值问题。
允许其他权重补偿
若删除一个权重时允许其他参数调整,可以求解
假设 \(g=0\) 且 \(H\) 正定。拉格朗日函数为
驻点条件 \(H\Delta w+\mu e_q=0\) 给出 \(\Delta w=-\mu H^{-1}e_q\)。代入约束,得到
这表达了利用参数耦合补偿删除误差的思想,属于 Optimal Brain Surgeon 的核心二阶框架。(Hassibi 和 Stork 1992) 它并未说明在大模型中可以廉价形成完整逆 Hessian;\(P\times P\) 的存储和求解成本通常不可接受。
取 \(H=\begin{bmatrix}2&1\\1&2\end{bmatrix}\),\(w=(1,2)^\mathsf T\),删除第一个权重。\(H^{-1}=\frac13\begin{bmatrix}2&-1\\-1&2\end{bmatrix}\),因而
若只置零而不补偿,\(\Delta w=(-1,0)^\mathsf T\),代价为1。补偿利用第二个权重分担变化,但这一结论只对设定的局部二次模型成立。
对单个线性层,可在校准输入上改用重建目标
对任一输出行的参数,曲率为 \(\frac{2XX^\mathsf T}{N}\)。它可通过输入统计构造,但可能奇异,常需阻尼或稳定分解。SparseGPT 将可扩展的局部重建与补偿用于大模型剪枝,说明校准激活和执行约束可以共同进入压缩设计。(Frantar 和 Alistarh 2023) 校准目标仍不是全任务损失,分布外输入可能受到不同影响。
结构化剪枝的联动关系
结构化剪枝(Structured Pruning)删除完整通道、注意力头或层,使张量尺寸真正改变。对前馈网络
其中 \(W_u\in\mathbb R^{h\times d}\)、\(W_d\in\mathbb R^{d\times h}\)。保留中间索引集合 \(S\),令选择矩阵 \(P_S\in\{0,1\}^{k\times h}\),则压缩结构为
因此上投影删除对应行及偏置,下投影删除对应列,外部 \(d\) 维接口保持不变。门控前馈结构有两条上投影路径,两者都应保留相同中间索引,并同步缩减下投影;只调整一侧无法保持逐元素乘法的语义。
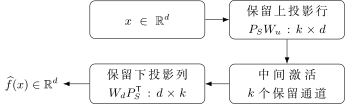
取 \(W_u=\begin{bmatrix}1&0\\0&1\\1&1\end{bmatrix}\)、\(W_d=\begin{bmatrix}1&0&0.1\\0&1&0.1\end{bmatrix}\),偏置为零,\(\phi\) 为 ReLU。输入 \(x=(1,2)^\mathsf T\) 时中间激活为 \((1,2,3)^\mathsf T\),输出为 \((1.3,2.3)^\mathsf T\)。删除第三通道后,输出为 \((1,2)^\mathsf T\),误差范数为 \(\sqrt{0.3^2+0.3^2}\approx0.4243\)。权重数从 \(3\cdot2+2\cdot3=12\) 降为8,减少三分之一,但是否值得仍取决于任务与输入分布。
注意力头删除同样需要调整查询、键、值和输出投影中对应的布局,并检查分组查询的共享关系。删除整层会改变残差路径的深度;删除残差主宽度则还涉及归一化、嵌入与共享权重。结构化压缩必须输出一致的模型配置、参数形状与序列化格式,不能只修改某个参数文件。
稀疏性何时产生执行收益
稀疏率(Sparsity)为零元素比例,但稀疏矩阵仍需要存储非零值和位置。设非零数量为 \(k\),数值每个 \(s\) 字节,索引每个 \(s_i\) 字节。以按行压缩的一种简化格式为例,存储约为
而稠密存储为 \(mns\)。忽略行指针时,只有 \(\frac{k}{mn}<\frac{s}{s+s_i}\) 才节省空间。例如两字节数值配四字节索引,需要非零比例低于三分之一,才能抵消逐元素索引开销。实际块稀疏或位图格式可改变这个阈值,因此不能把它当作所有稀疏格式的统一门槛。
半结构化稀疏(Semi-structured Sparsity)限制每个小组内的非零数量,例如常见的2:4模式在规定分组中保留两个非零值。固定模式降低索引和调度复杂度,却约束了哪些权重能够保留。同样50%的零元素,任意分布与满足2:4布局的分布,对硬件可能完全不同。专用库对数据类型、矩阵维度、布局和稀疏格式有具体要求,cuSPARSELt 就明确面向受支持的结构化稀疏矩阵运算。(NVIDIA 不详)
稠密内核通常仍按完整矩阵形状计算零元素。使用稀疏内核后,索引读取、不规则访存、负载不均与较低计算密度也可能抵消运算减少。块结构越规则,越容易形成可用执行路径,但其误差预算也更受约束。剪枝前就应确定后端可消费的形式,避免训练完任意掩码后才发现只能还原成稠密矩阵运行。
剪枝后的恢复训练必须明确掩码是否固定。如果置零后仍对完整参数自由更新,零权重可能重新生长;如果只对保留结构训练,应确保优化器状态与结构同步。恢复训练能够调整保留参数,却不能保证任何压缩率下都恢复原质量。
34.4低秩分解
低秩分解及最优近似
SVD 及谱尾误差
奇异值分解(Singular Value Decomposition,SVD)写成
左右奇异向量分别正交,奇异值描述对应输入方向到输出方向的放大程度。截断为秩 \(r\) 的矩阵
舍弃较小奇异方向。由秩一分量在 Frobenius 内积下正交,
前式给出总平方误差,后式给出最大方向放大误差;\(r=q\) 时尾项为零。截断 SVD 的最佳低秩近似性质由 Eckart–Young 定理刻画。(Eckart 和 Young 1936)
下面说明 Frobenius 最优性。对任意秩不超过 \(r\) 的候选 \(Z\),令 \(P\) 为其列空间上的正交投影,则 \((I-P)Z=0\)。投影分解使
另一方面,
在 \(WW^\mathsf T\) 的正交特征基中,令 \(a_i=u_i^\mathsf T P u_i\),则 \(0\leq a_i\leq1\) 且 \(\sum_i a_i=\operatorname{rank}(P)\leq r\),补零特征值后有
最后一个不等式来自把至多 \(r\) 单位权重分配给降序的最大系数。因此任意 \(Z\) 的误差至少为谱尾平方和,而 \(W_r\) 达到这一界,最优性得证。3
参数量及计算阈值
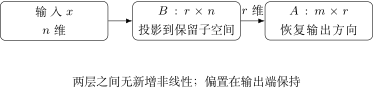
低秩分解(Low-rank Factorization)以两个较窄矩阵替换原矩阵。可将奇异值分配到两因子,例如
于是 \(y\approx A(Bx)+b\)。两个线性层之间不能插入新的非线性,否则不再表示同一个低秩矩阵。因子分配也非唯一,\(AD\) 与 \(D^{-1}B\) 对任意可逆 \(D\) 给出相同乘积,但它们的数值范围和后续量化误差可能不同。
原权重数为 \(mn\),因子权重数为 \(r(m+n)\),因此严格减少参数需要
对方阵 \(m=n=d\),阈值为 \(r<\frac{d}{2}\),不是简单的 \(r<d\)。若偏置只保留一次,前后偏置数量相同;若额外引入中间偏置,则应计入并说明它如何保持或改变函数。
对 \(N\) 个输入,原主要操作数约为 \(2Nmn\),两因子约为 \(2Nr(m+n)\)。这个计数忽略内核启动、中间张量和形状效率。真实实现还可能需要额外写入和读取 \(N\times r\) 的中间结果,因此参数与操作数阈值只是必要分析,不能直接推出相同比例加速。
例26.1
令 \(W=\operatorname{diag}(4,2,1,0)\)。它的平方 Frobenius 范数为 \(16+4+1=21\)。秩1近似为 \(W_1=\operatorname{diag}(4,0,0,0)\),误差平方为5,相对误差为 \(\sqrt{\frac{5}{21}}\approx0.4880\)。可取
以8个稠密存储参数替代16个参数。输入 \(x=(1,1,1,1)^\mathsf T\) 时,原输出为 \((4,2,1,0)^\mathsf T\),近似输出为 \((4,0,0,0)^\mathsf T\),实际误差范数为 \(\sqrt5\)。
秩2近似保留4和2,误差范数降为1,但因子参数为 \(2(4+4)=16\),已经没有参数节省;秩3完全恢复原矩阵,因子参数却为24。例题表明秩越大误差越小,并不意味着每个秩都属于压缩方案。实际模型若奇异值谱下降缓慢,低秩参数节省与质量预算之间可能根本没有共同可行区间。
输入加权的低秩目标
(选修) 权重范数把各输入方向视为同等重要。对真实输入,令 \(E=\widehat W-W\),则
这里 \(C_x=\mathbb E[xx^\mathsf T]\) 是二阶矩,不一定等于协方差;若输入均值非零,仍需保留均值贡献。称为激活加权低秩近似(Activation-weighted Low-rank Approximation),是因为常见校准输入就是前一层激活。
当 \(C_x\) 正定时,设 \(Z=WC_x^{\frac{1}{2}}\)、\(D=\widehat WC_x^{\frac{1}{2}}\)。右乘可逆矩阵不改变秩,故
对 \(Z\) 做截断 SVD 得 \(Z_r\),再变换回去,得到
这才是该输入分布与固定线性输出误差下的最优低秩解;一般不等于直接截断 \(W\)。
取 \(W=\operatorname{diag}(3,2)\)、\(C_x=\operatorname{diag}(1,9)\)。普通 SVD 秩1近似保留第一方向,输出误差为 \(2^2\cdot9=36\)。加权矩阵 \(Z=\operatorname{diag}(3,6)\) 则保留第二方向,回变换得到 \(\widehat W=\operatorname{diag}(0,2)\),输出误差为 \(3^2\cdot1=9\)。后者的权重 Frobenius 误差平方为9,比前者4更大,但在设定输入分布下输出误差更小。这是目标不同导致的合理差异。该二维例子用于解释加权,秩1因子不满足严格参数节省,不能作为压缩率证据。
有限校准集可估计 \(C_x\approx \frac{XX^\mathsf T}{N}\)。当样本不足或激活相关时,该矩阵可能奇异;未被样本覆盖的方向没有得到约束。可在有效支持子空间求解,或采用 \(C_x+\eta I\) 的阻尼形式,但后者相当于给未观测方向加入额外惩罚,改变了原目标。过小特征值的逆平方根还会放大数值误差,不能直接无条件求逆。
局部输出误差小也不保证最终任务误差小。后续层对不同输出方向具有不同敏感度,生成中的分布变化还会改变后续输入。恢复训练可以围绕压缩后激活重新调整,但必须使用与最终测试隔离的数据。
34.5知识蒸馏
知识蒸馏及温度
硬标签和软标签
硬标签(Hard Label)用单个类别或目标词元表示监督,软标签(Soft Label)给出完整概率分布。教师分布中不同错误类别的概率差异,可能表达相似性和不确定性;也可能包含教师偏差。蒸馏并不是宣称教师概率等于真实条件分布,而是让学生拟合一个具有额外结构的监督信号。温度软化与硬软目标组合由经典知识蒸馏工作系统阐述。(Hinton, Vinyals, 和 Dean 2015)
设教师和学生 logits 分别为 \(z_T,z_S\in\mathbb R^C\),温度 \(\tau>0\),则
增大温度通常使分布更平缓,减小温度使其更集中。类别排序不因共同正温度缩放改变,但类别间的概率差和优化权重会改变。蒸馏使用的训练温度不必等于部署采样温度,二者应分别记录。
若真实类别为 \(y\),常见混合目标为
这里硬标签项使用温度1,软标签项的教师与学生使用同一温度。教师熵相对于学生参数是常数,因而 KL 与教师为目标的交叉熵具有相同学生梯度,但数值不同。反转 KL 的方向会改变目标,不能因调用接口接受两组概率就随意交换。
温度平方因子的推导
教师冻结时,记 \(p_j=p_{T,j}^\tau\)、\(q_j=p_{S,j}^\tau\),则
对学生 logit \(z_{S,l}\) 求导,
代入 KL,利用 \(\sum_jp_j=1\),得到
一个 \(\frac{1}{\tau}\) 来自 logits 缩放;另一个近似尺度需要进一步分析概率差,不能从链式法则中直接凭空得到。
softmax 对公共平移不变,因此分别中心化师生 logits:\(\widetilde z_j=z_j-C^{-1}\sum_k z_k\)。在 \(\tau\) 相对所有中心化 logit 幅度足够大时,
故
未缩放 KL 梯度主项为中心化 logit 差除以 \(C\tau^2\)。乘以 \(\tau^2\) 后,
因此温度平方因子补偿的是高温近均匀区域的主要梯度尺度。它不保证所有温度、所有样本的梯度范数完全相等,也不证明温度越高越好。高温下不同类别近乎均匀,小概率信息与噪声都可能被放大到更显著的监督位置。
高温极限还给出 \(\tau^2D\approx\frac{\|\widetilde z_S-\widetilde z_T\|_2^2}{2C}\)。这里必须中心化:给教师全部 logits 加一个常数不改变分布,不应改变蒸馏目标,而未经中心化的平方误差会惩罚这个无意义平移。
蒸馏损失梯度
例26.2
考虑两个类别,\(\tau=2\),教师 logits 为 \((2\log4,0)\),学生 logits 为 \((0,0)\),硬标签是第一类,\(\lambda=\frac{1}{2}\)。温度化教师分布为 \((0.8,0.2)\),学生为 \((0.5,0.5)\)。软目标 KL 为
乘以 \(\tau^2=4\) 得0.770979。硬标签损失为 \(-\log0.5\approx0.693147\),最终混合损失约为
软目标对学生 logits 的梯度为
硬标签梯度为 \((-0.5,0.5)\),混合后为 \((-0.55,0.55)\)。梯度下降提高第一类 logit并降低第二类 logit。若忘记温度平方,软项梯度变成 \((-0.15,0.15)\),即使混合系数未变,硬软监督的相对强度也已改变。
教师若给出错误分布,学生仍会沿教师方向更新。混入硬标签可以提供另一信号,但效果受标签质量和权重影响,不能作为所有教师错误的自动修复。比较蒸馏收益必须保留同结构学生仅使用硬标签训练的基线,而不只与更大教师比较。
语言模型的蒸馏契约
词元分布及数据位置
词元级蒸馏(Token-level Distillation)在给定前缀上对齐师生下一词元分布。若有效掩码为 \(m_{bt}\),总有效位置数 \(N_t=\sum_{b,t}m_{bt}\),可写为
师生必须使用相同可见前缀和对应目标位置。填充、提示监督区域、因果移位和样本装箱边界若不同,分布列相同也不能得到正确监督。
词表对齐更是必要条件。两个分词器的第100列可能代表不同文本单位,不能逐列计算 KL。即使通过映射合并相近词元,也必须定义概率质量如何守恒、不同切分怎样对应位置。无法建立可靠映射时,可以选择文本级序列监督,代价是放弃完整词表分布信息。
完整 logits 缓存大小约为 \(N_tVs\) 字节,\(V\) 为词表大小、\(s\) 为每元素字节数。取最可能的若干类别可以降低存储,却会丢失尾部质量;截断后重新归一化得到的是另一个目标。缓存必须绑定样本标识、教师权重、分词器、模板、位置掩码和温度处理方式,避免内容正确但排列错位。
教师冻结包含参数不更新和目标生成方式稳定两个方面。训练模式下的随机失活仍可能改变教师分布;若有意使用随机教师集成,需要把这种随机性定义为目标的一部分。在线教师消耗额外算力,离线缓存消耗存储及版本管理成本,二者应按训练规模选择。
中间表示及注意力蒸馏
中间表示蒸馏(Intermediate Representation Distillation)对齐教师与学生的隐藏状态。设 \(H_S\in\mathbb R^{N_t\times d_S}\)、\(H_T\in\mathbb R^{N_t\times d_T}\),投影 \(P_h\in\mathbb R^{d_S\times d_T}\),一种目标为
记 \(E_h=H_SP_h-H_T\),则
投影只承担训练对齐时,可以在部署移除;若它被加入学生推理路径,则应计入最终成本。层数不同时需显式定义层映射,而不是比较同名层。隐藏表示还存在旋转和尺度的不唯一性,直接逐元素拟合会施加比输出一致更强的约束。
注意力蒸馏(Attention Distillation)可以比较对应层或头的注意力分布,但要求查询与键位置可对齐。教师多头与学生少头的映射、掩码与头聚合规则都会改变目标。注意力相似并不充分保证值路径和最终输出相似;因此中间目标通常作为任务或输出目标的补充。
序列级蒸馏
序列级蒸馏(Sequence-level Distillation)以教师生成的完整文本作为学生监督,早期序列到序列研究系统讨论了这一方法。(Kim 和 Rush 2016) 若教师序列分布为 \(p_T(y\mid x)\),理想交叉熵为
使用独立教师样本可以形成蒙特卡洛估计;若只保留贪心或束搜索选出的 \(y^*\),目标变成 \(-\log p_S(y^*\mid x)\),不再是整个教师分布交叉熵的无偏估计。它可能降低目标多样性,也可能让学生更容易学习集中的输出形式。
序列监督通过重新分词教师文本,可以允许师生使用不同词表,但内容质量、终止协议和数据分布仍需校验。第26章《可验证推理训练》讨论了验证器筛选与推理轨迹蒸馏;筛选会改变教师条件分布,不能把被接受文本视为无偏教师样本。
输出分布、序列与中间表示三类蒸馏可以组合,但每增加一个目标都增加对齐条件。教师的错误、偏见与不恰当置信度也可能被学生继承。蒸馏数据和教师选择应与最终测试隔离,报告学生对真实标签和任务的表现,而不只报告“与教师更相似”。
34.6组合压缩及误差传播
同一矩阵的组合误差
设第一次压缩得到 \(W^{(1)}=W+E_1\),第二次得到 \(W^{(2)}=W^{(1)}+E_2\)。总误差为 \(E_1+E_2\),因此
两种压缩各自误差小,不意味着总误差平方等于它们之和;误差方向可能抵消,也可能加强。若剪枝改变了激活分布,原来的加权低秩或量化校准统计也不再精确对应后续输入。
对因子量化,原低秩近似为 \(AB\),量化后为 \((A+\Delta A)(B+\Delta B)\),则
于是谱范数上界为
这说明因子尺度分配会影响后续误差:即使乘积相同,一个因子过大也可能放大另一个因子的扰动。
组合误差传播
例26.3
对无偏置的两层网络 \(f(x)=W_2\phi(W_1x)\),压缩后为 \(\widehat f(x)=(W_2+E_2)\phi((W_1+E_1)x)\)。若 \(\phi\) 为 \(L_\phi\)-Lipschitz 且 \(\phi(0)=0\),加减中间项得到
它揭示前层误差受到后层放大的机制,但可能很保守。残差、归一化和自回归反馈需要各自分析,不能把这个两层界直接当作整书所有模型的质量界。
用标量线性链展示组合项。原模型 \(f(x)=3(2x)=6x\),第一步将内层权重2近似为1.8,第二步将外层权重3近似为2.7。两者分别相对原模型单独使用时,输出误差均为 \(-0.6x\);组合后输出为 \(2.7\cdot1.8x=4.86x\),误差为 \(-1.14x\)。展开为
两个单独的相对误差均为10%,组合相对误差为19%,既不是简单相加20%,也不是平方和。真实网络中误差相关性更复杂,因此需要保留每个中间产物,才能解释后续变化。
组合顺序及恢复训练
压缩操作一般不可交换。先剪枝再分解,与先分解再剪枝因子,约束的是不同集合;先改变通道再量化,会改变每通道范围;蒸馏到另一结构则重新定义了后续可压缩对象。若目标是显著缩小架构,可先设计学生再蒸馏;若保留主体结构,可先做结构剪枝或低秩替换,再进行恢复和最终表示校准。这些是降低重复工作的策略,而不是唯一正确顺序。
恢复训练(Recovery Training)使用保留参数适应压缩结构,可结合真实标签、原模型输出或中间状态。它本身消耗数据与训练资源,也可能过拟合校准分布。每次结构变化后都应重新确认权重共享、嵌入与输出头绑定、配置形状、稀疏掩码以及优化器状态;保存完整基线与中间版本,才能定位质量损失来源。
算法34.3 按误差与执行约束构建压缩产物
输入:原模型、独立校准数据、恢复训练数据、质量预算与目标后端。输出:具有明确结构、表示及来源记录的候选压缩模型。
固定原模型和评估契约,列出各模块形状、共享关系与目标后端可执行的稀疏或低秩形式。
在校准输入上估计通道敏感度或输入二阶矩,按预算产生剪枝掩码、保留索引或低秩因子。记录目标函数与近似方法。
同步修改关联模块及配置,重建实际推理结构;不要仅把稠密参数置零后宣称结构已缩小。
按需要恢复训练或蒸馏。教师及其输出版本冻结,目标位置对齐,恢复数据与最终测试隔离。
结构稳定后按本章量化部分的方法确定量化表示和校准范围,保存每次组合前后的产物与误差证据。
在目标负载上评估最终任务质量及实际执行路径,超出预算时回退到对应中间版本。达到预定资源和质量要求后停止增加压缩操作。
不变量:每个参数形状与模型配置一致;输出接口和词表契约明确;后端实际消费所声明格式;最终测试不参与压缩阈值调优。
34.7真实硬件收益及统一比较
| 方法 | 直接改变的对象 | 收益必须满足的条件 |
|---|---|---|
| 非结构化剪枝 | 权重支持集 | 稀疏格式和内核能抵消索引及调度开销。 |
| 结构化剪枝 | 通道、头或层形状 | 关联结构一致,新形状仍能有效映射硬件。 |
| 低秩分解 | 矩阵秩与因子结构 | 秩满足参数阈值,双投影成本低于原运算。 |
| 知识蒸馏 | 学生训练目标与可选架构 | 学生在质量约束下确实具有更低执行成本。 |
| 量化 | 数值表示与位宽 | 格式、布局与低精度内核匹配,转换成本受控。 |
若可压缩部分占原端到端时间比例 \(f\),该部分加速 \(s_c\) 倍,其他部分不变,则理想加速比为
例如线性计算占60%,即便这部分加速两倍,端到端也只有 \(\frac{1}{0.4+0.3}\approx1.43\) 倍;这是时间分解的算例,并非设备测量。实际压缩还可能改变内存流量、通信和调度,需重新测量各部分,不能把此式作为固定预测。
模型制品大小、加载后权重内存、键值缓存、工作区和峰值内存应分别记录。减少权重未必同比减少长上下文 KV;增加中间低秩激活可能扩大工作区;结构化头删除可能影响缓存形状,但必须按具体结构重新计数。第28章《算力基础设施》说明了计算与带宽的约束,压缩收益应对应到这些实际路径。
同样的压缩结构在不同批量和序列长度下可能具有不同表现。小矩阵更容易受启动与带宽影响,大矩阵更可能受计算吞吐影响;稀疏布局打包的启动成本与稳态内核成本也应分开。必须记录数值精度、后端版本、实际内核、输入输出长度、冷暖状态和并发,避免用一次文件缩小或单层操作数下降宣称完整服务提速。
压缩的三个完成条件
数学近似必须在明确误差目标下成立,模型结构与制品格式必须能够恢复并执行,任务质量和系统成本必须在同一负载契约下满足要求。任何一个条件尚未建立,都不能由“参数更少”替代。