本章快速复习后续内容反复使用的数学对象。向量承载特征,矩阵实现批量线性变换,梯度描述标量目标对参数的局部变化;概率则规定语言模型输出的含义。读者只需重新建立符号、形状和概念之间的联系,不需要在此完成一门独立的数学课程。随后将这些对象用于推导最大似然估计(Maximum Likelihood Estimation,MLE)、熵(Entropy)、交叉熵(Cross-Entropy,CE)和库尔贝克—莱布勒散度(Kullback–Leibler Divergence,KL)。
假设与适用范围
词表取有限集合;除明确讨论连续情形外,概率均为离散质量。涉及条件概率的条件事件具有正概率;需要有限对数损失时,预测分布在目标支持集上严格为正。样本独立同分布只在相应估计推导中使用,不作为所有文本片段天然满足的事实。
2.1向量、矩阵及线性变换
向量的方向及尺度
向量可以看作一组有顺序的数,也可以看作空间中的点或方向。设 \(x={(x_1,\ldots,x_d)}^{\mathsf T}\in\Real^d\),其欧氏长度和两个向量的内积分别为
内积同时包含长度与夹角信息。余弦相似度 \(\frac{x^{\mathsf T}y}{\lVert x\rVert_2\lVert y\rVert_2}\) 去除了长度影响,但只有在向量非零时才有定义。在语言模型中,一个向量常表示某个词元或位置的特征;坐标本身通常没有独立的固定语义,向量之间的关系才是模型使用的信息。
向量相加要求维数相同。标量乘法改变长度并可能改变方向。逐元素乘法 \(x\odot y\) 与内积不同:前者仍是向量,后者将公共索引求和后得到标量。看到一个公式时,先写出输入和输出形状,往往比先代数化简更容易发现错误。
矩阵表示批量数据和线性映射
矩阵 \(A\in\Real^{m\times n}\) 有 \(m\) 行、\(n\) 列。矩阵乘法
把 \(n\) 维输入映射到 \(m\) 维输出。乘法成立的条件是相邻的公共维数相同;公共维被求和,外侧维被保留。若一批样本按行组成 \(X\in\Real^{B\times n}\),常将同一变换写为 \(Y=XW\),其中 \(W\in\Real^{n\times m}\)。这只是批处理约定不同,并不改变每个样本执行同一映射的事实。
线性变换满足 \(f(ax+by)=af(x)+bf(y)\)。神经网络常用的“线性层”实际计算
含偏置 \(b\) 时严格说是仿射变换(Affine Transformation)。连续堆叠多个仿射变换仍可合并为一个仿射变换,因此网络需要激活函数引入非线性。转置 \(A^{\mathsf T}\) 交换行列;逆矩阵只对可逆方阵存在。深度学习中通常直接计算线性方程或矩阵乘积,不应为了形式方便显式求逆。
2.2导数、梯度及链式法则
一元导数描述函数在某一点附近的变化率。多元标量函数 \(f:\Real^d\to\Real\) 的梯度为
梯度与输入同形,并指向欧氏空间中函数上升最快的局部方向;负梯度因此是局部下降方向。梯度为零只说明一阶变化消失,不保证该点是全局最小值。
复合函数通过链式法则求导。若 \(z=g(x)\)、\(f=h(z)\),则
计算图中的反向传播就是从标量损失出发,沿依赖关系反向应用这条规则。同一变量经多条路径影响损失时,各路径贡献必须相加。矩阵求导、广播和自动微分的具体规则将在第3章《神经网络基础》继续说明。
2.3概率基础
概率描述不确定事件,而统计推断利用有限样本认识其分布。离散样本空间中,概率质量函数满足
条件概率 \(p(x\mid y)\) 表示已知 \(y\) 后对 \(x\) 的重新分配;它与联合概率的关系为 \(p(x,y)=p(x\mid y)p(y)\)。语言模型正是反复估计“给定已有文本,下一个词元如何分布”。期望是按概率加权的平均,方差衡量随机变量围绕期望的离散程度。后续各节将在这些基本概念上展开最大似然、交叉熵和序列概率。
2.4随机变量及分布
概率质量函数
随机变量(Random Variable) \(X\) 是对不确定结果的数值或符号表示。大写 \(X\) 表示随机变量,小写 \(x\) 表示其一个可能取值。若 \(X\) 取值于有限集合 \(\mathcal X\),概率质量函数(Probability Mass Function,PMF)写为
在不会混淆对象时,下标 \(X\) 可以省略。模型中的一个词元编号是一次取值,而词表上的概率向量描述所有候选取值的不确定性。不能把某个编号的大小解释为该词元的概率。
例如,若 \(\mathcal X=\{a,b,c\}\) 且概率为 \((0.5,0.3,0.2)\),事件 \(X\in\{a,c\}\) 的概率是 \(0.7\)。概率具有可加性,是因为这些离散取值对应互斥事件。两个并非互斥的事件则不能直接将概率相加,否则交集会被重复计算。
本章主要使用有限分布,以便将概念直接连接到词表预测。连续随机变量用概率密度函数(Probability Density Function,PDF) \(f_X\) 描述区间概率:
密度值可以大于一,因为概率由区间积分而非单点密度给出。对具有密度的变量,单点事件的概率为零;这与离散词元概率不同。
记号及支持集
| 符号 | 含义 |
|---|---|
| \(X,Y\);\(x,y\) | 随机变量及其取值。 |
| \(p(x,y)\);\(p(y\mid x)\) | 联合概率及给定 \(x\) 后的条件概率。 |
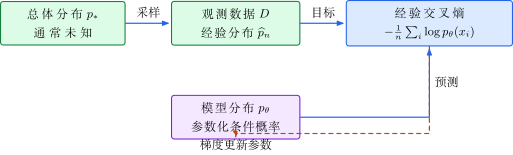
| \(p_*(x)\) | 讨论对象的真实分布,通常未知。 |
| \(p_\theta(x)\) | 参数为 \(\theta\) 的模型分布。 |
| \(\widehat p_n(x)\) | \(n\) 个观测形成的经验频率分布。 |
| \(\mathbb E_p[g(X)]\) | 函数 \(g(X)\) 在分布 \(p\) 下的期望。 |
| \(H(p)\);\(H(p,q)\) | 熵;以 \(p\) 为目标、\(q\) 为预测的交叉熵。 |
| \(D_{\mathrm{KL}}(p\|q)\) | 从目标分布 \(p\) 到分布 \(q\) 的 KL 散度。 |
支持集(Support)是分布赋予正概率的取值集合,记为 \(\operatorname{supp}(p)=\{x:p(x)>0\}\)。涉及 \(\log q(x)\) 的期望若在某个 \(p(x)>0\) 的位置遇到 \(q(x)=0\),就可能为无穷。这个边界不是公式上的小细节:一个模型若对真实可能出现的结果给出零概率,该结果一旦发生就会产生无穷大的负对数损失。
除特别说明外,本章使用自然对数,信息量单位为 nat。1
2.5联合概率、条件概率及链式分解
条件分布
若 \(p_X(x)>0\),条件概率定义为
条件化把样本空间限制到已知条件,并重新归一化。它不是删除条件变量,也不是默认条件与结果具有因果关系。网页内容与某个答案同时出现,可以形成统计相关;这并不证明网页内容导致答案所述事件发生。
将式(2.9)两边乘以 \(p_X(x)\),得到乘法规则
交换分解顺序可得贝叶斯公式
要求分母 \(p_Y(y)>0\)。分子衡量取值 \(x\) 与观测 \(y\) 的共同可能性,分母汇总全部候选解释,使结果归一化。
设一个验证器判断生成答案是否正确。候选答案的先验正确率为 \(0.2\);正确答案有 \(0.9\) 的概率通过,错误答案有 \(0.1\) 的概率误通过。记正确事件为 \(C\),通过事件为 \(A\)。联合概率为
因此
通过后的正确率高于原来的 \(0.2\),却并非 \(0.9\)。\(P(A\mid C)\) 表示正确答案被接受的概率,\(P(C\mid A)\) 表示接受结果中正确答案的比例,条件方向不同。基础正确率较低时,错误答案数量较多,即使误通过率较低也会形成不可忽略的污染。
这里的数值是用于说明条件概率的设定值,不是验证器性能实测。实际系统必须从合适样本中估计这些概率,并进一步考虑验证器与候选生成器的相关性和分布变化。
序列联合分布的分解
对三个随机变量,连续应用乘法规则有
对一般长度 \(T\),归纳得到
这个分解没有假定各位置独立。相反,右端保留了完整前缀条件。只有进一步假定 \(p(x_t\mid x_{<t})=p(x_t)\),才会退化为独立取值乘积。以固定窗口替代完整前缀同样是一项额外限制。
若每个条件分布均归一化,固定长度联合分布也归一化。证明从最后一个位置开始求和:
这解释了为何逐位置的词表分布能够定义完整序列概率。零概率前缀上的条件分布可以任意补成归一化分布,而不改变联合概率;除法定义只需用于具有正概率的前缀。
2.6期望、方差及经验分布
期望的概率加权
对有限分布,函数 \(g(X)\) 的期望为
期望不要求是变量的一种可能取值。例如公平二元变量取 \(0\) 或 \(1\),期望为 \(0.5\),但一次观测不必出现 \(0.5\)。对任意常数 \(a,b\),期望的线性性给出 \(\mathbb E[aU+bV]=a\mathbb E[U]+b\mathbb E[V]\),无须假定 \(U,V\) 独立。
记均值为 \(\mu=\mathbb E[X]\),方差为
最后一个等式由展开平方并使用 \(\mathbb E[X]=\mu\) 得到。若 \(U,V\) 相关,则
其中 \(\operatorname{Cov}(U,V)=\mathbb E[(U-\mathbb E U)(V-\mathbb E V)]\)。忽略协方差可能严重低估误差,例如同一文档的多个近重复片段并非新的独立证据。
有限样本估计
设 \(X_1,\ldots,X_n\) 独立同分布,均值为 \(\mu\)、有限方差为 \(\sigma^2\)。样本均值 \(\overline X=n^{-1}\sum_iX_i\) 满足
第一式来自线性性,第二式还使用了不同样本间协方差为零。标准差随 \(n^{-\frac{1}{2}}\) 缩小,而不是随 \(n^{-1}\) 缩小。将记录复制十次不会产生十倍独立信息。
对离散取值,经验分布为
于是对任意函数 \(g\),
经验平均可以严格写成经验分布下的期望。但经验分布并不等于真实分布:未观察到某个取值,不能证明它在总体中的概率为零。后续的训练目标正是由这个可计算的经验平均构成。
2.7最大似然及负对数损失
似然及概率的对象不同
假设观测 \(x^{(1)},\ldots,x^{(n)}\) 在给定参数后独立,模型给数据的似然为
数据固定时,这个表达式被视为参数 \(\theta\) 的函数,称为似然。它一般不在参数空间上积分为一,因此不应直接解释为“参数为真的概率”。参数后验还需要先验和相应归一化。
由于对数严格单调,最大化似然与最大化对数似然具有相同的最优解。再乘以负号,得到最小化问题
对数将连乘转为求和,既便于分析,也避免大量小概率连乘导致的数值下溢。除以固定的 \(n\) 不改变最优解,但改变梯度尺度;优化时仍需与学习率等设置共同考虑。
伯努利参数估计
设 \(X\in\{0,1\}\),\(p_\theta(X=1)=\theta\),\(0<\theta<1\)。在 \(n\) 次独立观测中出现 \(k\) 次一,负对数似然为
当 \(0<k<n\) 时,求导并令导数为零:
且 \(J''(\theta)=\frac{k}{\theta^2}+\frac{n-k}{(1-\theta)^2}>0\),所以该驻点是唯一最小值。例如十次中六次为一,估计值为 \(0.6\)。当 \(k=0\) 或 \(k=n\) 时,若参数域包含端点,最优解分别位于 \(0\) 或 \(1\);不能在这些情形机械套用内部驻点条件。
端点解也说明经验估计的局限。训练样本没有某个结果时,最大似然可能将其概率设为零。引入先验、平滑或更强的共享结构可以改变这一行为,但这些操作也改变了估计问题,需明确说明。
条件监督、回归及多标签
在分类任务中,通常给定输入 \(x_i\),拟合 \(p_\theta(y_i\mid x_i)\)。二分类令 \(p=\sigma(z)=(1+e^{-z})^{-1}\),则伯努利负对数似然为
第二行来自代入 Sigmoid,第三行分别对 \(z\ge0\) 与 \(z<0\) 提取指数中的较大项。最后一式中指数不大于一,避免了很大的正指数。这是损失稳定计算的数学依据。
例如 \(z=2\)、\(y=1\) 时,\(p\approx0.8808\),损失为 \(\log(1+e^{-2})\approx0.1269\);若标签改为零,损失为 \(2+\log(1+e^{-2})\approx2.1269\)。同一预测对不同真值应受到不同惩罚。2
对连续目标,若假定 \(Y\mid x\sim\mathcal N(f_\theta(x),\sigma^2)\) 且方差固定,则
去掉与参数无关的项,最小化负对数似然等价于最小化平方误差。若方差也需要学习,第一项便不能删除;离群值和异方差也可能要求不同的分布模型。
互斥多分类用一个总和为一的类别分布,多标签则允许多个标签同时成立。若将各标签建模为条件独立(Conditional Independence)的伯努利变量,其联合似然为各标签似然的乘积,损失为各自二元交叉熵之和。条件独立是所采用的分布结构,并非多标签数据天然满足的性质。
类别不平衡时,若仅把正类损失乘以 \(w>0\),总体条件目标变为 \(-wp_*\log q-(1-p_*)\log(1-q)\),其中 \(p_*=P(Y=1\mid x)\)。求导并令其为零,得到最优输出 \(q^*=\frac{wp_*}{wp_*+1-p_*}\)。除 \(w=1\) 或退化端点外,\(q^*\) 不再等于原始条件概率。加权目标改变了拟合对象,不能将其输出直接解释为已校准概率;决策阈值也应在独立验证中按错误代价选择。
2.8熵、交叉熵及 KL 散度
熵衡量分布内部的不确定性
信息熵(Information Entropy)源于对概率不确定性的定量研究(Shannon 1948)。以下用有限分布推导其性质,信息不确定性与文本语义价值须区分。
对概率 \(p(x)>0\) 的事件,定义自信息为 \(I(x)=-\log p(x)\)。较少见的结果具有较大的自信息;两个独立结果联合出现时,其自信息相加,因为 \(-\log[p(x)p(y)]=-\log p(x)-\log p(y)\)。按真实出现概率平均,得到熵
取 \(0\log0=0\),这与 \(u\log u\) 在 \(u\to0^+\) 时的极限一致。离散概率不大于一,故 \(H(p)\ge0\);确定性分布的熵为零。
熵描述一个分布自身的不确定性,并不评价模型是否正确。一个模型把错误答案的概率集中到接近一,也可以具有很低的预测熵。低熵表示确信,确信是否合理还需要与目标分布或观测结果比较。
交叉熵及散度的分解
设目标分布为 \(p\),模型或编码分布为 \(q\),交叉熵定义为
采样权重来自 \(p\),被取对数的预测来自 \(q\),两者不可交换。将 \(\log q(x)=\log p(x)-\log[\frac{p(x)}{q(x)}]\) 代入,在有限且支持相容时得到
第一项不随模型 \(q\) 改变,第二项衡量预测分布偏离目标分布所带来的额外平均对数损失。因此,对固定目标分布最小化交叉熵,等价于最小化这个方向的 KL 散度。
KL 散度的非负性可以由基本不等式 \(-\log u\ge1-u\) 推出。假设在 \(p\) 的支持上 \(q\) 为正,则
等号成立要求支持上的比值均为一,且 \(q\) 没有把额外概率放到支持之外,即 \(p=q\)。若 \(q\) 在 \(p\) 的某个正概率位置为零,散度为正无穷,非负性仍成立。由此可以进一步证明,在 \(C\) 个取值上,\(H(p)\le\log C\):令 \(u(x)=\frac{1}{C}\),则 \(D_{\mathrm{KL}}(p\|u)=\log C-H(p)\ge0\)。最大熵由均匀分布取得。
KL 散度方向性
令 \(p=(0.75,0.25)\),\(q=(0.5,0.5)\),逐项计算得到
因此 \(0.6931\approx0.5623+0.1308\),与式(2.38)一致。反向计算却得到
二者不同,说明 KL 散度一般不对称。它也不满足距离所需的三角不等式,因此本书不将其称为通常意义的距离。训练和蒸馏中的 KL 项必须说明哪个分布提供采样权重;改变方向便改变了目标。
2.9序列损失
独热目标及 Softmax
互斥 \(C\) 分类的目标类别为 \(y\),独热向量为 \(e_y\)。对预测分布 \(q\),
因此用整数类别编号索引正确类别,与显式构造独热向量再求交叉熵,在数学上给出同一标量。前者不需要分配整个独热数组。软标签则有多个非零权重,不能再简化为只读取一个类别。
令网络产生实数分数 \(z\in\Real^C\),归一化指数函数(Softmax)将其映射到概率单纯形:
对全部分数减去相同常数不会改变概率。令 \(a=\max_kz_k\),有
右端指数都不大于一。稳定实现应计算这种形式,而不是先计算可能溢出的指数再求对数。分数的绝对平移不可识别,真正决定概率的是分数差。具体梯度将在张量与自动微分章推导。
条件生成的最大似然
给定上下文 \(c\),长度为 \(T\) 的目标 \(y_{1:T}\) 满足
这里先按固定长度讨论;可变长度的完整生成事件还需包含终止词元,其概率处理见第8章《自回归语言建模》。分类是目标仅含一个类别的特例;翻译、问答和指令回答则把类别预测重复到整个目标序列。条件 \(c\) 可以进入每一步计算,却不一定属于损失监督区域。仅屏蔽条件位置的损失,并不会删除模型对条件信息的依赖。
序列归一化及样本权重
对文档 \(i\) 的有效预测位置集合 \(\mathcal T_i\),令 \(N_i=|\mathcal T_i|\)。序列链式分解给出损失和
总词元平均为 \(\mathcal L_{\mathrm{token}}=\frac{\sum_iS_i}{\sum_iN_i}\),文档等权平均则为 \(\mathcal L_{\mathrm{doc}}=n^{-1}\sum_i\frac{S_i}{N_i}\),这里要求被平均的文档均有 \(N_i>0\)。二者只有在特定条件下才相等。
例如两篇文档分别含两个和八个有效目标,平均词元损失分别为一和二,则 \(S_1=2\)、\(S_2=16\)。总词元平均是 \(\frac{18}{10}=1.8\),文档平均是 \(\frac{1+2}{2}=1.5\)。后者对短文档的每个词元赋予更大权重。损失归一化并非只影响显示格式,它直接改变不同样本对学习目标的贡献。
填充位置和不参与监督的提示位置应由明确的有效位置集合排除。注意力掩码规定信息可见性,损失掩码规定优化区域,概率公式不能将两者混为一谈。若全部监督位置都被屏蔽,应报告无有效目标,而不能计算除零的平均损失。
困惑度的含义及比较条件
若平均负对数损失使用自然对数,困惑度(Perplexity,PPL)定义为
它是正确目标逆概率的几何平均。若模型对每个正确目标都赋予 \(\frac{1}{K}\),困惑度为 \(K\);一般情况下,它不是每步实际候选数,也不是错误率。指数是单调的,所以在相同目标和归一化下,困惑度与平均负对数损失的排序相同。
跨模型比较时,需要固定语料、分词器、有效位置、上下文和边界处理。分词更粗的模型可能在更少位置上完成同一文本的编码,直接比较每词元损失会改变计量单位。改用每字节或每字符指标也必须明确文本的编码与归一化条件,不能据此忽略输入协议差异。