第4章《文本表示》先把文本记录变为词元编号和有效性掩码,再在第4章《文本表示》中的“从离散身份到连续表示”一节把离散符号变为形状明确的连续向量。至此,每个批次已经形成 \(X\in\Real^{B\times T\times d}\),但仅有逐位置的映射仍不能完成上下文交互,也不会单独提供顺序坐标。对于句子中同一个词元,其含义可能取决于前面的修饰语、远处的主语或另一段输入中的证据。注意力机制(Attention)通过输入相关的权重,在一组可访问位置之间汇总信息,使每个查询位置能够得到面向当前上下文的表示。顺序信息如何进入这一计算将在第7章《位置表示》讨论。
注意力并不是“选出最重要的词”的同义词。它首先是一个可微的向量到向量运算:计算匹配分数、在允许位置上归一化、对内容向量加权求和。只有把这三个步骤及其梯度写清楚,才能正确理解多头、因果掩码和键值共享,也才能区分数学结构与执行内核的优化。本章以原始 Transformer 的缩放点积形式为基础(Vaswani 等 2017),逐项建立这一计算过程。
5.1查询键值机制
位置相关信息汇总
设候选内容向量为 \(v_1,\ldots,v_S\in\Real^{d_v}\)。对第 \(i\) 个查询位置,先确定非负权重 \(a_{ij}\),且 \(\sum_j a_{ij}=1\),再得到
若所有权重相等,这只是平均汇总,不能根据当前查询区别候选内容;若只保留一个权重,则成为离散选择,通常无法直接通过所选索引传播梯度。注意力以连续权重实现内容相关的读取,同时保留端到端求导的可能。
查询(Query,Q)表达用于匹配的当前状态,键(Key,K)表达候选位置的匹配特征,值(Value,V)表达该位置被读取的内容。键和值拥有相同的位置索引,但承担不同的计算职责。某个位置能否匹配与匹配后提供什么信息,是可以分别学习的两个问题。1
输入来源及投影形状
先省略批量轴,采用每个位置占一行的约定。令查询侧输入为 \(X_q\in\Real^{T\times d_q}\),键值侧输入为 \(X_m\in\Real^{S\times d_m}\)。两侧特征宽度可以不同。单头投影定义为
其中 \(W_Q\in\Real^{d_q\times d_k}\),\(W_K\in\Real^{d_m\times d_k}\),\(W_V\in\Real^{d_m\times d_v}\)。查询和键必须投影到相同的 \(d_k\) 维空间才能计算点积;值的宽度 \(d_v\) 可以与 \(d_k\) 不同。为集中讨论主线,本章公式暂省略偏置;加入偏置时按位置广播,反向梯度对位置求和。
先给出本章随后逐项建立的完整单头运算。未使用掩码时,缩放点积注意力(Scaled Dot-Product Attention)定义为
Softmax 对每个查询沿键位置逐行计算。式(5.3)依次包含匹配分数、尺度控制、权重归一化和内容汇总;下面将分别说明每一步的含义、前提与形状。加入可见性掩码后,只需在归一化前向分数矩阵加入相应的加性掩码。
| 符号 | 含义 | 形状或范围 |
|---|---|---|
| \(B,T,S\) | 批量、查询长度、键值长度 | 正整数 |
| \(d_q,d_m\) | 查询与记忆侧特征宽度 | 正整数 |
| \(d_k,d_v\) | 单头匹配维数与内容维数 | 正整数 |
| \(Q,K,V\) | 投影后的查询、键与值 | \(T\times d_k,S\times d_k,S\times d_v\) |
| \(U,M,A\) | 分数、加性掩码、注意力权重 | \(T\times S\) |
| \(O\) | 单头输出 | \(T\times d_v\) |
| \(H_q,H_{kv}\) | 查询头数、键值头数 | 正整数 |
符号 \(V\) 在本章始终表示值矩阵;需要词表大小时另记为 \(V_{\mathrm{vocab}}\)。恢复批量轴后,各样本独立执行上述运算,输入通常写为 \([B,T,d_q]\) 和 \([B,S,d_m]\)。
自注意力(Self-Attention)令两侧输入来自同一序列,即 \(X_q=X_m=X\),因而 \(T=S\);这不意味着投影后的 \(Q=K=V\)。只要 \(W_Q,W_K,W_V\) 不同,三组向量就不同。交叉注意力(Cross-Attention)则允许输入来源不同,例如查询取自目标序列,键和值取自源序列的编码结果。算法名称描述信息来源,单头的计算公式保持相同。
5.2缩放点积及归一化
点积同时包含方向及长度
对查询行向量 \(q_i\) 和键行向量 \(k_j\),点积分数为 \(q_i k_j^\mathsf T\)。非零向量满足
因此点积不只是角度相似度,向量范数也影响分数。将两者分别归一化后计算余弦相似度,是另一种分数定义,不能不加说明地替换。学习到的投影可以调整匹配方向和尺度,并不要求向量各维预先具备可命名的语义。
点积分数缩放
平方根缩放的矩条件
查询和键的分量均值为零、二阶矩有限;两向量独立,各自坐标方差分别为 \(\sigma_q^2,\sigma_k^2\),不同坐标的乘积互不相关。该假设用于解释初始尺度,不视为训练后始终成立的不变量。
在这些条件下,对 \(s=\sum_{r=1}^{d_k}q_rk_r\),有
故缩放分数 \(u=\frac{s}{\sqrt{d_k}}\) 满足
特别地,两种分量方差均为一时,未经缩放的分数标准差为 \(\sqrt{d_k}\),缩放后为一。该设计抑制维数增长带来的尺度变化,并未把每个实际分数都限制在 \([-1,1]\) 内。
独立性是推导的条件,而非自注意力训练后的不变量。同一输入经过不同投影,可能产生相关的查询与键。即使 \(q,k\) 是独立零均值向量,若坐标之间相关、协方差为 \(C_q,C_k\),更一般的结果也是
只有在适当的各向同性条件下才退化为 \(d_k\sigma_q^2\sigma_k^2\)。位置旋转、归一化和训练中的参数变化都可能影响实际分数分布,应将平方根缩放理解为有明确假设的尺度设计。
Softmax 的行归一化
归一化指数函数(Softmax)把实数分数转成非负、总和为一的权重。对分数矩阵 \(U=\frac{QK^\mathsf T}{\sqrt{d_k}}\),每个查询独立归一化其键轴。没有屏蔽时,
行和为一表示一个查询的读取权重在所有键之间分配;列和一般不为一,同一个键可以同时被很多查询读取。因此注意力矩阵通常不是双随机矩阵,也不要求对称。即使 \(Q=K\) 使点积分数对称,各行归一化分母不同也可能破坏权重矩阵的对称性。
Softmax 对同一行的常数平移不变:对任意 \(c_i\),以 \(U_{ij}-c_i\) 代替 \(U_{ij}\),分子和分母同时乘以 \(e^{-c_i}\),结果不变。取 \(c_i=\max_j U_{ij}\),指数项不超过一,可避免大正分数的指数溢出。这个稳定形式保留了相同的数学函数。
如果某个分数比其他分数大很多,权重便接近独热。Softmax 的雅可比矩阵(Jacobian Matrix)汇总其全部一阶偏导数,其对角项为 \(a_j(1-a_j)\)、非对角项为 \(-a_ja_r\),在这种极度集中的情形下,多数分数梯度会变小。缩放有助于避免初始化附近无意造成的过早集中,但不能保证所有头都维持分散的权重,也不能把所有小梯度问题归因于 Softmax。
凸组合的范围及例外
在未使用随机失活(Dropout)的单头权重运算中,\(o_i\) 位于 \(\{v_j\}\) 的凸包内。任意线性投影 \(P\) 满足
所以二维投影可以保留加权组合关系,适合展示汇总机制;二维投影不能保留的距离和方向,则不能用于证明原空间中的语义关系。
若在权重上施加保留概率为 \(q\) 的 Dropout,实际使用 \(\widetilde A_{ij}=\frac{m_{ij}A_{ij}}{q}\),其行和在一次随机采样中一般不再等于一,甚至可能为零。期望满足 \(\mathbb E_m\widetilde A=A\),但每次输出不再必然处于同一个凸包。检查“概率行和为一”应针对 Dropout 之前的归一化权重;不能把这一性质要求施加到所有训练模式输出上。
5.3掩码规定可见性
在允许集合上定义 Softmax
为第 \(i\) 个查询定义允许读取的索引集合 \(\mathcal J_i\)。当其非空时,最清楚的定义是
用加性掩码表示时,\(M_{ij}=0\) 对应允许,\(M_{ij}=-\infty\) 对应禁止,可以简写为 \(A=\softmax(U+M)\)。数学上 \(e^{-\infty}=0\),但具体浮点程序仍须避免全屏蔽行或非有限输入导致的不定运算。
布尔掩码中的真值没有跨所有接口统一的含义:有的接口使用真表示允许,有的使用真表示禁止。正文用集合和加性形式消除这种歧义;实现时应在接口边界将外部约定转换为单一内部约定。不能依靠张量类型或名称猜测方向。2
填充掩码、因果掩码及文档边界
填充掩码屏蔽没有真实内容的键值位置。批量中的有效长度不同时,键掩码可由 \([B,S]\) 扩展到所有头和查询行。屏蔽填充键并不保证填充查询的输出为零:填充查询仍可能读取有效键。若这些查询应被忽略,需在损失或后续输出处理上明确实现;把嵌入的某一行固定为零不能替代注意力掩码。
因果注意力(Causal Attention)是在自注意力中采用因果可见性规则的注意力算子;因果掩码(Causal Mask)则是编码该规则的掩码。对于等长的自回归训练,因果允许集合为 \(\mathcal J_i=\{j:j\leq i\}\)。因此权重矩阵呈下三角结构,严格上三角被因果掩码屏蔽;因果注意力就是在这个允许集合上归一化并汇总值向量。这里“因果”指遵守生成顺序的信息限制,不是统计学中的干预因果推断。目标序列还必须正确右移:若位置 \(i\) 的输入已经含有它要预测的答案,那么允许读取自身也会泄漏目标,单靠三角掩码无法修复。
多种硬约束共同存在时,应取允许集合的交集。例如位置既需要满足 \(j\leq i\),又必须是有效词元、来自允许的文档。等价地,各种禁止条件取并集。将多篇文档拼接成一个序列时,分隔符本身不禁止跨文档读取;是否隔离仍取决于掩码。
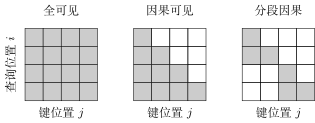
全屏蔽行的退化
若 \(\mathcal J_i=\varnothing\),式(5.11)的分母为零。将所有分数设为 \(-\infty\) 后再减行最大值,还会遇到 \(-\infty-(-\infty)\)。把所有分数换成同一个有限负数也不能解决语义问题:减去最大值后所有位置相等,Softmax 返回均匀分布,反而读取全部禁止内容。
应首先区分无效查询与合法查询。对于必须产生有效表示的合法查询,全屏蔽行通常表示数据或掩码构造错误,应使其显式失败。对于仅为批量补齐而存在的无效查询,可以约定该行输出恒为零,并在归一化之前分流处理;对应路径不对分数和值产生梯度。这个零输出是额外定义的算子扩展,不是空集合上的概率分布。
左填充的因果批量尤其容易产生早期无效查询行:它们不能访问未来真实词元,而自身及过去位置又全是填充。设置不同的 BOS 与 PAD 身份可以避免把真实起始位置误判为填充,但仍必须检查所有无效行。不能先产生 NaN,再指望与零相乘恢复为有限结果。
算法5.1 具有严格可见性的单头注意力
输入:\(Q\in\Real^{T\times d_k}\)、\(K\in\Real^{S\times d_k}\)、\(V\in\Real^{S\times d_v}\),每行允许集合 \(\mathcal J_i\),查询有效标记 \(b_i\)。输出:\(O\in\Real^{T\times d_v}\);需要诊断或显式反向时同时保留权重 \(A\)。本算法关闭权重 Dropout。
检查匹配宽度及键值位置数一致,所有数值输入有限;创建全零的 \(O\),需要保留权重时创建全零的 \(A\)。
对查询 \(i=1,\ldots,T\):若 \(b_i=0\),保持该行输出为零并进入下一行;若 \(b_i=1\) 但 \(\mathcal J_i\) 为空,报告非法可见性并停止。
对每个 \(j\in\mathcal J_i\) 计算 \(u_j=\frac{q_i k_j^\mathsf T}{\sqrt{d_k}}\)。若点积出现非有限值,报告数值异常;否则取 \(c=\max_{j\in\mathcal J_i}u_j\)。
计算 \(e_j=\exp(u_j-c)\) 及 \(z=\sum_{j\in\mathcal J_i}e_j\)。此时至少一项指数为一,分母严格为正。
对允许位置令 \(a_j=\frac{e_j}{z}\),累加 \(o_i\leftarrow o_i+a_jv_j\);禁止位置不参加归一化,也不参加汇总。需要权重时写入 \(A_{ij}=a_j\)。
全部查询完成后返回结果。有效行的权重非负、行和为一;无效行保持零,禁止位置的权重保持零。
显式逐行形式用于陈述完整定义,批量矩阵或融合实现可以更改执行次序,但必须保持允许集合、无效行约定与相同输入下的计算语义。
矩形因果注意力及前缀偏移
增量读取时,查询可能只包含最新的一个或几个位置,而键值包含全部已缓存前缀,此时 \(T\ne S\)。因果关系应由绝对位置给出
而不是盲目在 \(T\times S\) 矩阵上从左上角画下三角。例如键绝对位置为 \(0,1,2,3\),唯一查询的位置为 \(3\),它应能读取四个键;若把该查询当作行号零,只允许键零,就改变了函数。缓存的存储与调度在推理篇展开,本章保留的是偏移不能丢失这一数学条件。
5.4因果单头注意力
查询键值投影
取一个包含三个位置的自注意力问题,\(d_q=d_m=d_k=d_v=2\),无偏置、无 Dropout。给定
故 \(Q=K=X\),而
这里特意选择简单矩阵使每步可手算;真实投影一般不是单位矩阵。加入因果掩码,记 \(c=\frac{1}{\sqrt2}\approx0.707107\),得到
逐行归一化及汇总
第一行只有一个允许位置,所以权重为 \((1,0,0)\)。第二行除以 \(1+e^c\),第三行先减去 \(c\) 再归一化,可得到精确形式
每行沿键轴归一化。将它乘以同一组 \(V\),得到
第二行输出为 \(0.330238(1,0)+0.669762(0,2)\);第三行则位于三个值向量构成的三角形内。若误把 \(X\) 而不是 \(V\) 用于汇总,第二坐标会减半;这说明只把权重矩阵算对,仍不足以完成注意力计算。
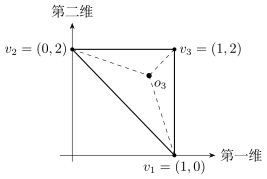
改变未来位置及检查信息边界
改变第三行输入,只会改变第三个键值及第三个查询。在因果掩码下,前两个查询对第三个键的权重严格为零,所以 \(o_1,o_2\) 保持不变;\(o_3\) 则一般改变。若去掉掩码,第一行原本对第三个键分配正权重,未来输入的变化便可以影响早期输出。
这一结论不仅针对给定数值成立,还可推广到多层网络:假设上一层位置 \(j\) 仅依赖输入前缀 \(x_{\leq j}\),本层位置 \(i\) 只读取 \(j\leq i\) 的状态,而其他运算均逐位置进行,那么本层位置 \(i\) 也只依赖 \(x_{\leq i}\)。由层数归纳即可证明整个堆叠的前缀隔离。位置编码必须使用相同位置定义,验证时还须固定随机运算,否则随机性本身会造成输出差异。
5.5多头注意力及输出投影
独立的匹配空间
多头注意力(Multi-Head Attention,MHA)对同一组输入使用 \(H_q\) 组投影。标准 MHA 中每个查询头有自己的键值头,即 \(H_{kv}=H_q=H\):
\(C\in\Real^{T\times Hd_v}\),\(W_O\in\Real^{Hd_v\times d_{\mathrm{out}}}\),所以最终输出为 \(T\times d_{\mathrm{out}}\)。用于残差连接时通常取 \(d_{\mathrm{out}}=d_q=d_m=d\)。常见配置为 \(d_k=d_v=\frac{d}{H}\);这是一个方便的结构选择,注意力定义本身不强制每个宽度都相同。
把 \(W_O\) 按行分成 \(H\) 个块 \(W_O^{(h)}\in\Real^{d_v\times d_{\mathrm{out}}}\),可将拼接投影改写为
每个头先按自己的权重读取内容,再将读出结果投影到共同输出空间并求和。这里一般不能先平均注意力矩阵,再乘一个共同值矩阵,因为各头的 \(V^{(h)}\) 与输出块可能不同。展示“平均注意力图”会隐藏头间差异,不等于网络实际执行了这个平均算子。
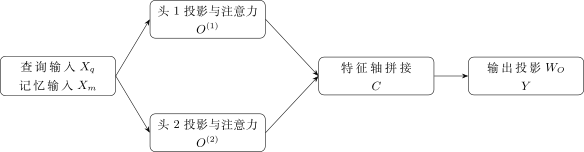
多头特征空间
恢复批量后,投影输出 \([B,T,Hd_k]\) 可以重排为 \([B,T,H,d_k]\),再交换中间两轴得到 \([B,H,T,d_k]\)。键和值同理。头维度与序列维度承担不同含义:分头划分投影特征,通常每个头仍能读取全部允许位置;它不是把前半句交给一个头、后半句交给另一个头。
不同头可以学习不同的读取模式,但结构没有要求它们自动承担固定的语法、指代或推理分工。随机初始化也会产生不同权重图,这只说明参数不同;如果要讨论某个头的具体功能,还需要训练后的干预、消融和跨样本证据。
投影打包及参数共享
自注意力中,三个投影读取同一个 \(X\),可以将参数沿输出特征轴拼接为
在 \(d_k=d_v=\frac{d}{H}\) 的标准 MHA 中,整体投影矩阵宽度为 \(3d\)。这只是矩阵布局的合并,三个参数区间仍相互独立,不会减少参数量,也不产生 \(Q=K=V\)。若框架线性层把权重存为“输出宽度乘输入宽度”,对应打包轴与正文约定相反,迁移时应先核对矩阵乘法方向。
对交叉注意力,\(Q\) 与 \(K,V\) 来自不同输入,不能使用一次 \(XW_{QKV}\) 代替全部投影。键和值可以在记忆侧打包,查询则在查询侧单独计算。参数文件可以打包存储,并不意味着执行时必须共用一个输入。
5.6交叉注意力及结构关系
查询长度及记忆长度
在源到目标的条件生成中,源表示 \(X_m\in\Real^{S\times d_m}\) 已由编码器得到,目标侧状态 \(X_q\in\Real^{T\times d_q}\) 发出查询。交叉权重为 \(T\times S\),输出长度保持为 \(T\)。因此它把源信息注入每个目标位置,不会把输出序列长度改成 \(S\)。
目标查询需要遵守自身生成顺序,但它通常可以读取全部已经可用的源序列。不能因为目标侧自注意力使用因果掩码,就在交叉权重矩阵上照搬目标三角形。若源信息也以流式方式到达,则应根据真实可用时点构造额外掩码;这是任务的信息约束,而非交叉注意力默认包含的性质。
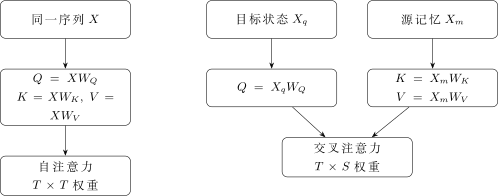
单头交叉注意力
设源侧只有两个值 \(v_1=(2,0)\)、\(v_2=(0,4)\),目标侧有三个查询,其缩放分数分别为 \((0,0)\)、\((\log3,0)\)、\((0,\log3)\)。逐行 Softmax 后的权重是
所有目标位置读取同一组源值,却依据不同查询得到不同汇总。输出仍有三行;第二行没有因行号超过源长度而失去定义。若第二个源位置是填充,屏蔽该列后,每一行都只能读取 \(v_1\)。
编码器结构通常采用双向自注意力,解码器自回归结构采用因果自注意力,编码器–解码器结构则额外采用交叉注意力。可见性与模块组成是两个维度,不能简单等同。完整 Transformer 还需逐位置前馈变换、残差和归一化,并通过输出头与训练目标定义预测问题;这些组成在第6章《Transformer 网络结构》中建立。
5.7注意力的反向传播
Softmax 雅可比的推导
固定一行分数 \(u\),记 \(Z=\sum_r e^{u_r}\)、\(a_j=\frac{e^{u_j}}{Z}\)。根据商法则,
因此雅可比为 \(J=\operatorname{diag}(a)-aa^\mathsf T\)。若上游梯度为 \(r=\frac{\partial\mathcal L}{\partial a}\),则
式中的 \(\sum_s a_sr_s=a^\mathsf Tr\) 是上游梯度按当前权重的平均。分数梯度行和为零,因为对整行加常数不改变 Softmax。这个零和性质是检查反向传播的有用不变量。
匹配分数梯度
令 \(G=\frac{\partial\mathcal L}{\partial O}\in\Real^{T\times d_v}\)。由 \(O=AV\),逐元素有 \(O_{ir}=\sum_j A_{ij}V_{jr}\),于是
其中上横线表示对应变量的损失梯度。逐行应用式(5.25),得到
硬掩码允许集合固定时,禁止位置的权重为零,其分数梯度也为零。对全屏蔽且定义为零输出的无效行,应沿定义的常量分支返回零梯度,而不是求一个不存在的空集合 Softmax 雅可比。
进一步对 \(U=\frac{QK^\mathsf T}{\sqrt{d_k}}\) 求导,得到
值路径直接改变被读取的内容,查询和键路径则改变读取权重。若一行只有一个可见键,其权重恒为一,该行所有分数梯度均为零,但对应值梯度可以非零。这并非梯度实现错误,而是该行没有可学习的匹配选择。
返回投影矩阵及输入
由式(5.2),
自注意力中 \(X_q=X_m=X\),三个路径必须相加,不能把它们当作彼此独立的输入:
多头输出 \(Y=CW_O\) 还需先计算 \(\overline W_O=C^\mathsf T\overline Y\) 与 \(\overline C=\overline YW_O^\mathsf T\),再按特征轴拆成各头上游梯度。如果启用了权重 Dropout,则在经过 Softmax 反向前,还要乘以同一次前向使用的 \(\frac{m}{q}\);不能重新随机采样掩码。
注意力局部梯度
仍取因果例题第二个查询,令损失 \(\mathcal L=o_{2,1}\),只取该行输出第一坐标。在其两个可见位置上,\(a=(\alpha,1-\alpha)\),其中 \(\alpha=\frac{1}{1+e^c}\approx0.330238\)。上游 \(G_2=(1,0)\),故 \(R_2=(1,0)\)。分数梯度为
值梯度分别在第一坐标得到 \(\alpha\) 和 \(1-\alpha\)。把 \(K_1=(1,0)\)、\(K_2=(0,1)\) 代入式(5.28),得到
例如沿 \(q_{2,1}\) 增大,会提高第一个键的分数,增加第一内容坐标;其导数应为正。导数符号、行和为零与有限差分数值共同形成比“程序能够反向运行”更强的局部证据。
5.8计算规模及键值共享
投影成本及位置交互成本
令标准 MHA 的输入输出宽度均为 \(d\)、\(H\) 个头且 \(d_k=d_v=\frac{d}{H}\)。若一次乘加计作两次浮点运算,不计偏置和低阶逐元素操作,查询投影约需 \(2BTd^2\) 次运算,两个键值投影合计约需 \(4BSd^2\),输出投影约需 \(2BTd^2\)。位置交互包括
因此自注意力 \(T=S\) 时,线性投影为 \(O(BTd^2)\),交互为 \(O(BT^2d)\)。说“注意力是二次复杂度”指的是随序列长度增长的位置交互项,并不表示全部成本只有这一项。短序列下投影和其他网络层仍可能占据主要开销。
显式保存注意力矩阵需要 \(BHTS\) 个元素。以 \(B=2,H=16,T=S=4096\)、每元素两字节为例,仅一份权重矩阵即需
这不含分数副本、反向中间量、参数或其他层。因果掩码令一半左右的条目数学上为零,但若仍分配方形稠密张量,存储并不会自动减半。避免完整物化权重矩阵的分块与融合方法将在高效推理章节讨论;它们改变内存访问和计算次序,不应被误写为一定改变注意力定义。
MHA、MQA 及 GQA
标准 MHA 为每个查询头配置独立键值投影。多查询注意力(Multi-Query Attention,MQA)让所有查询头共享一个键值头(Shazeer 2019)。分组查询注意力(Grouped-Query Attention,GQA)则使用介于一与查询头数之间的键值头数,每组查询共享一组键值(Ainslie 等 2023)。
设 \(H_q\) 个查询头、\(H_{kv}\) 个键值头,且 \(H_q\) 可被 \(H_{kv}\) 整除。令每组查询数为 \(r=\frac{H_q}{H_{kv}}\),查询头从零编号,映射 \(g(h)=\lfloor \frac{h}{r}\rfloor\),则
\(H_{kv}=H_q\) 对应 MHA,\(H_{kv}=1\) 对应 MQA,中间值对应分组结构。共享键和值并不使组内各头输出相同,因为查询投影仍不同,Softmax 权重一般也不同。3
| 结构 | 查询头 | 键值头 | KV相对规模 | 结构变化 |
|---|---|---|---|---|
| MHA | \(H_q\) | \(H_q\) | \(1\) | 每头独立匹配和内容投影。 |
| GQA | \(H_q\) | \(H_{kv}\) | \(\frac{H_{kv}}{H_q}\) | 多个查询共用一组键值投影。 |
| MQA | \(H_q\) | \(1\) | \(\frac{1}{H_q}\) | 所有查询共用一组键值投影。 |
键值共享的计算边界
假设键和值的单头宽度均为 \(d_h\),一个样本的 \(S\) 个历史位置需要存储 \(2SH_{kv}d_h\) 个键值元素。对于 \(H_q=32,H_{kv}=8\),相同长度和精度下的键值存储为标准 MHA 的四分之一;MQA 则为三十二分之一。输入宽度为 \(d\) 时,键值投影的参数数目由 \(2dH_qd_h\) 变为 \(2dH_{kv}d_h\)。
但是查询头仍有 \(H_q\) 个,每头仍需对允许位置计算权重。显式分数的形状仍是 \([B,H_q,T,S]\),核心匹配与汇总乘加数量不会仅因共享键值就按相同比例减少。性能收益取决于重复读取是否真正复用、内核布局和硬件瓶颈,不能把键值存储比例直接当作端到端加速比。
MHA 到 GQA 的改变也不是把张量重排一下:不同键值投影被约束为共享,会改变可表达的函数族。对既有权重进行合并后通常需要继续适配和重新评估,不能仅凭形状兼容声称输出保持不变。分组数、单头宽度和投影布局均属于模型结构的一部分,须与权重共同保存。
5.9注意力结构性质
排列等变性
没有位置表示、掩码也同步变换时,自注意力具有排列等变性。令 \(P\) 为位置置换矩阵,每行每列恰有一个一,并满足 \(P^{\mathsf T}P=I\)。考虑自注意力输入 \(X\) 变为 \(PX\) 的情形。
排列等变性证明的前提
各位置共享投影参数;不含显式位置输入;Softmax 逐行沿键轴计算;无随机算子。若存在掩码,可见性关系必须与内容同步置换,且每个查询至少有一个允许位置。
首先,线性投影与行置换可交换:
记缩放分数为 \(U=\frac{QK^{\mathsf T}}{\sqrt{d_k}}\),则
设置换后的第 \(i\) 行对应原第 \(\pi(i)\) 行。同步置换键轴只改变一行分数的排列,不改变归一化分母,因此
代入值矩阵并使用 \(P^{\mathsf T}P=I\),得到
输出随输入一起重排,而不是保持不变,所以这里的性质是排列等变性而非排列不变性。
若将带加性掩码 \(M\) 的自注意力记为 \(F(X;M)\),相应关系是
固定下三角因果掩码通常不满足 \(PMP^{\mathsf T}=M\);只置换词元却保留原掩码时,上述证明不再适用。位置表示与可见性共同使顺序具有作用,不能把“没有显式位置编码”直接等同于“网络不利用顺序”。
注意力权重的语义边界
同一个注意力权重乘以不同值向量,会产生不同输出;输出还经过投影、多头求和、残差和后续非线性变换。因此较大的某个 \(A_{ij}\) 只说明当前头在这一步汇总中给该值的系数较大,不能单独推出它对最终预测的贡献最大。
更直接地,若所有 \(v_j\) 都相同,那么无论注意力权重怎样改变,只要保持行和为一,输出就不变。这时权重图可以非常集中,也可以非常分散,而网络从此头得到的向量完全相同。若要研究因果影响,应明确干预对象和比较方式,并考虑干预后其他计算路径的变化。
局部性质及整体行为
一组有意义的结构验证应同时覆盖投影形状、允许集合、归一化行和、输出矩阵乘法及梯度。因果结构还应核对未来扰动不改变早期输出;共享键值结构需核对各查询头映射到正确的组。对框架实现做数值比较,应统一参数、偏置、缩放、位置表示、掩码语义和 Dropout 状态,随机初始化的两个模块没有逐值相等的理由。
浮点运算顺序不同可能使结果出现舍入差异,合理的相对与绝对误差容限应随精度、规模和数值范围确定。局部公式一致只能证明对应算子的正确性,不能证明模型已学会翻译、检索或推理。训练目标、数据与完整网络将进一步决定这些能力。
注意力计算的三个独立约束
投影决定匹配与内容的表示空间,掩码决定合法的信息来源,归一化决定允许位置之间的读取比例。输出和梯度必须同时遵守这三项约束。算法5.1落实单头定义;图5.3增加并行表示空间;共享键值则改变投影的共享关系。三者均不能由一张权重热力图完整证明。
习题参考结果
第1题依次为 \(5\times7\)、\(5\times7\)、\(5\times3\)。第2题方差为 \(16d_k\) 与 \(16\)。第5题在把 \(Q,K,V\) 当作独立输入求偏导时,\(\overline K_1=(0,\frac{\alpha(1-\alpha)}{\sqrt2})\),\(\overline K_2\) 为其相反数。第7题共 \(3,145,728\) 字节,即 \(3\ \text{MiB}\),为 MHA 的四分之一。第9题方差为 \((1-q)\sum_j \frac{A_{ij}^2}{q}\);该结论要求固定归一化权重并对独立掩码取期望。