一幅图像和描述它的句子可以指向同一场景,却具有不同的数据结构。图像由空间采样构成,文本由离散词元构成;音频具有密集时间采样,视频同时具有空间和时间维度。多模态模型必须先建立可计算的接口,再通过学习使这些接口保留任务所需的关系。两组向量具有相同维数,只说明能够相加或拼接,不能证明它们表达了相同含义。
矩阵反向传播承接第3章《神经网络基础》,空间与时间位置的作用承接第7章《位置表示》。本章围绕三个问题展开:感知数据如何成为序列;跨模态关系通过什么目标学习;模型如何在不泄漏答案的条件下利用这些序列。我们先讨论视觉与文本,再把相同的接口原则推广到音频和视频。图像生成所需的像素或潜变量解码目标与本章的条件文本生成不同,不能由“可以输入图像”推导出“可以输出图像”。
40.1模态、任务及表示接口
模态(Modality)是信息的观测或表达方式。视觉语言模型(Vision-Language Model,VLM)联合利用视觉和语言信息,可以实现匹配、分类、问答或条件生成,但具体能力由输入输出接口和训练目标决定。图文对比模型输出匹配分数,不必包含文本解码器;感知型生成模型读取图像并输出文本,也不必包含图像生成器。
本章的张量与学习约定
批量大小为 \(B\)。图像空间尺寸可被给定块大小整除,不能整除时的补齐和有效位置由处理器显式记录。视觉表示与文本表示均为实值张量;对比学习例题中每个图像和同批同序号文本构成一个正对,归一化前特征非零,温度 \(\tau>0\)。条件生成部分只对指定文本答案计损失,输入图像及提示是已知条件。构造数例用于数学说明,不代表模型性能测量。
表 40.1 本章主要符号。矩阵推导未写批量轴时,对每个样本分别应用。
| 符号 | 含义与形状 |
|---|---|
| \(I\) | 图像批量,\(\mathbb R^{B\times C_{\mathrm{img}}\times H\times W}\)。 |
| \(P_h,P_w,N_v\) | 块高、块宽和视觉词元数,\(N_v=(\frac{H}{P_h})(\frac{W}{P_w})\)。 |
| \(X_v,Z_v\) | 编码特征 \(B\times N_v\times d_v\),连接后特征 \(B\times M\times d\)。 |
| \(d_v,d,d_c\) | 视觉隐藏维、语言隐藏维和对比表示维,三者可不同。 |
| \(u_i,v_j\) | 第 \(i\) 幅图像和第 \(j\) 条文本的单位对比向量,均在 \(\mathbb R^{d_c}\)。 |
| \(S,R,C\) | 对比逻辑值、按行与按列归一化的概率矩阵,均为 \(B\times B\)。 |
| \(Q,K,V,A\) | 重采样查询 \(M\times d_k\)、键 \(N_v\times d_k\)、值 \(N_v\times d\)、权重 \(M\times N_v\)。 |
| \(m_j\) | 目标位置 \(j\) 是否参与损失的二值掩码,与可见性掩码不同。 |
| \(f_s,h,F\) | 音频采样率(样本/秒)、声学窗口步长(样本)、视频选取帧数。 |
视觉编码器通常产生局部特征序列;图文检索还会通过池化等操作得到全局向量。全局向量适合快速比较整幅图像与文本的关系,局部序列则保留供计数、位置和文字识别使用的空间信息。只保留一条全局表示,不等于原图全部细节都被可恢复地编码。
40.2视觉词元化
切块、投影及空间位置
补丁(Patch)是视觉序列中的局部输入单元。把每个 \(P_h\times P_w\) 块展平为 \(x_n\in\mathbb R^{C_{\mathrm{img}}P_hP_w}\),使用共享矩阵
映射到隐藏维。卷积核大小与步幅均为块大小、无重叠且采用相同展平顺序时,这与一次卷积后展平空间轴等价。块投影建立局部线性组合,后续编码器使各位置交互。视觉 Transformer(Vision Transformer,ViT)采用块序列进行图像建模,是这一表示路线的代表(Dosovitskiy 等 2021)。
二维位置必须以位置表示、相对偏置或结构化计算等方式进入模型;展平顺序本身只建立数组地址,并不会使无位置自注意力自动理解上下左右。多图输入还需区分图像编号与图内坐标。高分辨率分块处理时,局部裁剪坐标应能映射回全图,否则模型难以判断不同裁剪中的对象是否为同一对象。
若 \(H=W=224\)、\(P_h=P_w=16\),则 \(N_v=14\times14=196\)。将两边都增大到448而保持块大小,得到784个块,是原来的4倍。若编码器采用完整自注意力,其位置对数从 \(196^2\) 增至 \(784^2\),为原来的16倍;这是注意力矩阵规模比较,不是端到端运行时间的必然倍数。投影、前馈、内存访问和实现方式同样影响耗时。
分辨率及有效信息
提高分辨率可以保留小字和局部结构,但缩放插值不会创造原始图像没有的信息。固定缩放可能破坏长宽比;裁剪可能移除问题所需区域;把整页文档压到很小尺寸可能保留布局而丢掉数字。预处理应记录缩放、裁剪、补齐和坐标变换,使预测的区域能够正确返回原图。
动态分辨率(Dynamic Resolution)根据输入尺寸或内容调整视觉序列长度。它要求批量中的有效长度和补齐位置可追踪,并把视觉词元预算纳入请求限制。可变长度不是无上限长度;多图、多页和视频需要在空间细节与覆盖范围之间分配预算。对于需要精确读取局部内容的问题,保留相关高分辨率区域可能比均匀增加所有帧的细节更合适,但选择区域的错误也必须计入系统误差。
40.3视觉及文本的对比对齐
双向匹配目标
跨模态对齐(Cross-modal Alignment)通过训练使不同模态的相关表示在任务所需意义上对应。对齐可以表现为全局匹配、局部区域与词语对应,或使语言模型能够利用视觉条件生成;这些目标不能互相替代。
对比语言图像预训练(Contrastive Language-Image Pre-training,CLIP)学习图像和文本的共享匹配空间(Radford 等 2021)。下面给出其双向对比目标的一般形式。设编码器及投影输出非零向量 \(a_i,b_j\),归一化为
\(S_{ij}\) 是相似度经温度缩放后的逻辑值。对图像 \(i\) 在批内文本中分类,对文本 \(j\) 在批内图像中分类,分别得到
矩阵 \(R\) 各行和为1,矩阵 \(C\) 各列和为1;二者通常不同。单正对假设下,对角线为目标,平均损失为
两个方向分别约束“一幅图像应匹配哪条文本”和“一条文本应匹配哪幅图像”。仅优化一个方向,不会自动对另一个方向施加相同的列竞争关系。
编码器梯度
对一行的损失展开 \(-S_{ii}+\log\sum_k e^{S_{ik}}\),对 \(S_{ij}\) 求导得到 \(R_{ij}-\delta_{ij}\);按列展开同理得到 \(C_{ij}-\delta_{ij}\)。因此
将 \(U,V_c\in\mathbb R^{B\times d_c}\) 定义为各 \(u_i^{\mathsf T},v_i^{\mathsf T}\) 按行排列的矩阵,有 \(S=\frac{UV_c^{\mathsf T}}{\tau}\)。利用微分
代入 \(\mathrm d\mathcal L=\operatorname{tr}(G^{\mathsf T}\mathrm dS)\) 并整理迹,得到
每幅图像的梯度不仅来自其配对文本,还来自所有参与分母的候选;“负样本”是目标函数中的竞争关系,而不是只在正对损失之外额外添加一个惩罚项。
归一化还有一层雅可比。令 \(r=\|a\|_2\)、\(u=\frac{a}{r}\),则
它去除纯径向分量,使一阶更新作用于方向;范数很小时梯度可能很大。实现中使用带 \(\varepsilon\) 的稳定归一化时,应按实际定义理解分段或近似梯度,不能假定与非零范数公式处处相同。
若使用可学习缩放 \(\alpha=e^s=\frac{1}{\tau}\),则 \(S_{ij}=\alpha u_i^{\mathsf T}v_j\),因此
缩放增大会使分布更集中,但错误配对或近似重复样本也可能被更强地惩罚。温度影响优化几何,不能解释为模型已经校准的事实置信度。
双样本对比损失
取 \(B=2,d_c=2\),图像和文本单位向量均为 \(u_1=v_1=(1,0)^{\mathsf T}\)、\(u_2=v_2=(0,1)^{\mathsf T}\),取 \(\tau=1\)。则
两方向损失均为 \(-\log p=\log(1+e^{-1})\approx0.313262\),故平均损失不变。式40.7给出
由于 \(V_c\) 为单位矩阵,\(\nabla_U\mathcal L=G\)。若 \(a_1=u_1\),式40.12去掉第一坐标方向,得到 \(\nabla_{a_1}\mathcal L=(0,0.134471)^{\mathsf T}\)。梯度下降会让第一幅图像表示朝远离第二条文本的方向移动;这不是把所有分量机械地向正对增加。对数缩放梯度为两个对角项之和,即 \(-0.268942\),在此构造数据上下降更新会增大缩放。若批内都是错误标注,则这种扩大间隔也可能扩大错误。
负样本、多正对及语义边界
批内负例(In-Batch Negative)把同批其他配对的样本作为竞争候选,计算方便但依赖标签含义。两幅相同图像、同一场景的不同描述,或两条都正确的简短字幕,可能被误当负样本。这类假负例(False Negative)会使目标要求语义相近项彼此远离。简单扩大批量不保证监督更干净。
若图像 \(i\) 的合法文本集合为 \(\mathcal P_i\),可定义归一化多正对目标 \(T_{ij}=\frac{1}{|\mathcal P_i|}\)(\(j\in\mathcal P_i\)),使用 \(-\sum_jT_{ij}\log R_{ij}\);另一选择是 \(-\log\sum_{j\in\mathcal P_i}R_{ij}\)。前者鼓励所有正对按目标分布获得概率,后者只要求正对集合获得总质量,可能由某一个容易正对承担。两者不是相同目标,应根据标注语义选择。
困难负样本应在保持真实不匹配的前提下增加辨别难度,例如对象相同但关系不同。只利用背景、文件水印或文本模板区分配对,会形成捷径。图像增强也应保留文本所描述的事实:随机裁剪如果裁掉唯一红色物体,原字幕就可能不再成立。对比对齐能够组织全局匹配空间,却不保证精确计数、否定、空间关系或细粒度字符都已学会。
跨设备汇集表示扩大候选集合时,需明确远端表示是否参与梯度和损失如何归一化。将远端表示当常量与使用可微汇集产生不同梯度;不能仅因前向分数矩阵相同就声称训练等价。这里的分布式实现应与全局批量目标保持一致。
40.4多模态连接器
逐位置投影
连接器(Connector)把感知编码器输出转换为语言侧可用的表示。最简单的投影器(Projector)执行
对每个位置共享参数,将 \(N_v\times d_v\) 变为 \(N_v\times d\)。它改变特征维数,不改变位置数。非线性多层投影器可以增加表示变换能力,但只要逐位置应用,仍不直接完成跨位置压缩。
设 \(D_Z=\frac{\partial\mathcal L}{\partial Z}\),则
批量情况下对样本轴继续求和。若视觉编码器被冻结,可以不更新其参数;投影器仍需接收从语言损失传来的 \(D_Z\)。训练数据决定它学习什么视觉信息,而矩阵形状本身无法决定其语义。
查询重采样
重采样器(Resampler)使用较少输出位置汇聚较长视觉序列。对单个样本,一层查询读取可写为
\(Q\in\mathbb R^{M\times d_k}\) 为可训练查询,输出长度为 \(M\)。每一输出是值向量的加权组合,不是选择某一个原始块。固定查询也不意味着权重固定,因为 \(A\) 随输入键而改变。查询间可加入自注意力与前馈层;这些设计改变表达能力,但不改变“输出长度受控”的接口目的。
查询式连接器有不同具体实现。BLIP-2 的查询变换器(Querying Transformer,Q-Former)用可学习查询从冻结图像编码器提取特征,并通过表示学习与生成学习两个阶段连接语言模型(Li 等 2023);Flamingo 使用重采样与语言侧视觉读取模块(Alayrac 等 2022)。本章式40.20只抽取共有的单层读取原理,不把它冒充这些完整模型。1
对于固定注意力矩阵 \(A\),若 \(M<N_v\),其秩至多为 \(M\),存在非零方向 \(\Delta V\) 使 \(A\Delta V=0\)。所以仅从 \(AV\) 不能恢复任意 \(V\)。完整重采样器的 \(A\) 也依赖输入,这个固定矩阵论证不能直接穷尽其非线性行为,但已说明“较少查询输出”没有自动的无损保证。任务所需的局部信息是否保留,必须依靠训练目标和细粒度评估。
重采样梯度
取 \(N_v=2,M=1,d_k=1,d=2\),\(Q=[1]\),\(K=[0,\log3]^{\mathsf T}\),值为
由于缩放因子为1,权重 \(A=[\frac{1}{4},\frac{3}{4}]\),输出为 \(Z_v=[\frac{1}{2},3]\)。它既不是两个值的简单平均 \([1,2]\),也不是原始某一行。
为说明梯度,取 \(\mathcal L=\tfrac12\|Z_v-Z^*\|^2\),\(Z^*=[1,2]\),则 \(D_Z=[-\frac{1}{2},1]\)。首先
对注意力逻辑值 \(r=[0,\log3]\),Softmax 导数给出
加权和为 \(-\frac{1}{4}+3=\frac{11}{4}\),故 \(D_r=[-\frac{15}{16},\frac{15}{16}]\)。进一步有
损失通过值路径和键路径同时传回视觉表示。冻结视觉编码器只停止其参数更新,不代表连接器无需学习注意力分配。
40.5融合位置及计算代价
前缀拼接
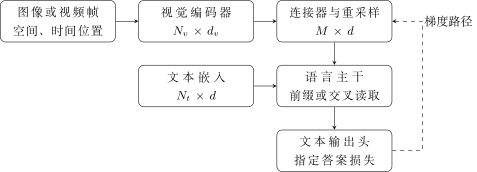
前缀融合(Prefix Fusion)把 \(M\) 个视觉向量与 \(N_t\) 个文本嵌入沿序列轴拼接,得到 \(B\times(M+N_t)\times d\)。视觉向量是连续条件,不要求具有文本词表 ID。视觉占位符可以指示插入位置,但插入后真实位置数必须由处理器和模型契约一致确定。
若所有位置进入密集自注意力,长度平方项相对纯文本增加
例如 \(N_t=512\),保留196个视觉位置时增加239120个位置对;压缩到32个视觉位置时增加33792个位置对。这里比较的是位置交互量,尚未计编码器和重采样开销,也不等于显存或延迟按同样比例下降。
交叉注意力及交错融合
交叉注意力融合(Cross-attention Fusion)让语言隐藏状态作为查询,独立视觉记忆作为键和值。单层交互量与 \(N_tM\) 成正比,文本自注意力仍有自身的 \(N_t^2\) 项。它保留模态边界,可在指定语言层读取视觉信息,但需要新增层、参数及相应推理实现。推理时视觉键值可以按层缓存;是否划算取决于读入层数、视觉长度和生成长度。
图文交错序列则还需明确每段文本可以读取哪些图像。全前缀方案允许后续文本读取全部已知视觉条件;含时间顺序的交错数据可以只开放此前可见媒体。所谓“早期”或“晚期”融合只有相对于具体网络边界才有意义:在两个独立编码器之后拼接,仍可能发生在语言主干的第一层之前。
统一序列建模进一步把多模态输入放入共同主干,但共享主干不意味着共享输出分布。生成离散声学或视觉词元需要相应词表与解码器;生成连续潜变量可能需要不同损失。架构应说明编码、融合与输出头三条边界,不能只画一个接收所有模态的方框。
40.6监督区域及分阶段训练
可见性掩码及监督掩码
注意力掩码(Attention Mask)决定一个位置可以读取哪些其他位置;损失掩码(Loss Mask)决定哪些目标参与优化。视觉与用户提示可以不承担预测标签,却仍是后续答案的有效条件。把“不监督”实现为“不可读取”,会移除模型完成任务所需的信息。
设拼接序列为 \(x_1,\ldots,x_L\),其中前 \(M\) 个是视觉向量,后面包含提示和答案。语言模型在位置 \(j-1\) 输出分布 \(q_{j-1}\),预测目标位置 \(j\) 的文本词元 \(y_j\)。令 \(m_j\in\{0,1\}\) 表示该目标是否受监督,\(N_s=\sum_{j=2}^Lm_j>0\),则
掩码附着于目标位置,再与前一位置的逻辑值配对。有的库在内部执行移位,有的接口要求外部移位;无论接口如何,数学含义都必须与式40.26一致。重复移位和完全没有移位都会使监督错位。
因果可见性的一种简单定义是 \(A_{ij}^{\mathrm{mask}}=0\) 当 \(j\le i\) 且位置有效,否则为 \(-\infty\)。它加到注意力逻辑值中,防止看到未来答案。视觉前缀内部也可以采用双向可见,但不能让它读取未来答案后再作为答案的条件,否则会形成绕过因果掩码的信息泄漏。
取 \(M=2\),随后是起始标记、一个提示词元、两个答案词元及结束标记。位置与标签关系如下:
表 40.2 目标掩码与上下文有效性的区别。位置5的标签由位置4的输出预测。
| 位置 | 内容 | 该位置作为上下文 | 该位置的目标标签 |
|---|---|---|---|
| 1 | \(V_1\) | 有效 | 忽略 |
| 2 | \(V_2\) | 有效 | 忽略 |
| 3 | 起始标记 | 有效 | 忽略 |
| 4 | 提示 \(P\) | 有效 | 忽略 |
| 5 | 答案 \(A_1\) | 有效 | \(A_1\) |
| 6 | 答案 \(A_2\) | 有效 | \(A_2\) |
| 7 | 结束标记 | 有效 | 结束标记 |
若三个目标的正确词元概率分别为0.5、0.25和0.8,则
起始位置、视觉位置和提示位置没有对应的直接目标损失;但是 \(A_1\) 的概率由提示位置4的输出预测,因此不能把位置4的输出也一并忽略。若将视觉向量加入后仍沿用原文本的绝对标签位置,答案标签就会错位两个位置。
对于批量中的不同回答长度,按所有受监督词元求平均与先按每样本求平均再对样本平均不同。前者给予长答案更大权重,后者使每个样本总权重相同。应在训练契约中明确选择;全掩码样本的 \(N_s=0\) 需要单独处理,不能产生未定义除法,也不能通过加入虚假标签凑数。
跨模态梯度传播
设视觉条件为 \(Z_v=f_\phi(I)\),语言模型为 \(g_\theta\),则
即使只在答案位置计算损失,答案仍可通过注意力依赖视觉条件,从而产生 \(\nabla_\phi\mathcal L\)。冻结语言参数 \(\theta\) 意味着不更新这些参数,不意味着把 \(g_\theta\) 当作对输入常量的无梯度过程。如果连接器仍需训练,必须保留对其输入输出所需的反向路径。相反,若视觉编码器冻结且其输入也不需要梯度,可以缓存或停止该编码器内部的反向计算,但连接器部分仍保留计算图。
冻结参数与停止梯度必须分开
参数是否更新、输入是否参与反向、位置是否被读取、目标是否计入损失,是四个不同问题。它们分别决定优化范围、梯度路径、信息流与监督区域;混用这四种控制,会使张量形状正确而学习机制错误。
指令学习接口
先冻结视觉编码器和语言模型、只训练连接器,可以利用已有表示并降低待优化参数规模。该阶段通常让视觉条件支持描述或其他明确文本目标。它不保证语言主干已经能完成复杂视觉推理,也不能补回冻结编码器从未保留的细节。
随后可用交错图文或多模态指令数据训练连接器与部分主干。视觉指令微调(Visual Instruction Tuning)以图像、问题和答案组织监督,使模型学习遵循视觉相关任务请求;LLaVA工作是这一训练路线的代表(Liu 等 2023)。联合解冻增强调整能力,但也会增加语言能力遗忘、视觉表示漂移及对合成描述偏差的拟合。是否解冻、解冻多少层和是否保留纯文本数据,应由目标能力与评估决定,而非固定套用阶段表。
不同目标可以组合为
其中匹配损失判断一对图文是否一致。各项的监督区域和梯度可达参数可能不同,系数只有在损失归一化方式已明确时才有可比较意义。若对比表示读取了其配对文本再参与匹配,就可能用标签捷径完成任务;若生成目标的视觉查询读取未来答案,也会产生泄漏。多任务训练需要为每个目标分别定义信息可见性。
训练与部署还必须绑定同一组处理器规则,包括图像归一化、裁剪与块序、视觉占位符、文本分词器、会话模板以及特殊标记。处理器不是可任意替换的文件读取工具,而是模型输入分布的一部分。编码器、连接器、语言主干和输出解码器分别具有版本及适用条件,组合制品应保存完整依赖关系。
算法40.1 多模态条件生成的训练步骤
输入为媒体、提示、答案及其长度和坐标元数据;输出为损失和本阶段允许更新的参数梯度。
依据固定版本处理器解码媒体,记录尺寸、裁剪、时间戳与有效位置;按预算选择媒体片段,保持答案所需监督与输入一致。
计算感知特征,经投影及可选重采样得到语言侧表示,保存每个媒体对象到输出位置区间的映射。
构造文本嵌入,并在约定位置插入媒体表示;生成独立的上下文有效性、因果可见性和目标损失掩码。
只执行一次目标移位,将目标位置 \(j\) 对齐到输出位置 \(j-1\);无有效目标的样本按契约跳过或报数据错误。
前向计算答案分布,按选定的词元或样本归一化计算损失;若有辅助对比目标,使用其单独的配对和可见性规则。
沿需要的输入梯度路径反向,只更新本阶段开放的参数。记录有效媒体与文本长度、监督词元数和各目标损失。
处理完当前批次后结束此步;按既定训练步数、数据轮次与独立验证准则控制整个训练过程。阶段切换时保存模型及处理器契约。
不变量是媒体位置映射与标签长度始终一致,所有受监督答案只依赖允许的条件,冻结语言权重不阻断连接器需要的梯度。
40.7音频表示及时间压缩
(选修)
波形、声学特征及文本
采样率(Sampling Rate)是单位时间的离散样本数。若单通道波形以 \(f_s\) 样本/秒记录 \(T_a\) 秒,样本数约为 \(f_sT_a\)。把长波形逐样本作为语言序列通常过长,因此声学编码器通过窗口特征或学习的下采样形成较短表示。
一种常见表示来自短时傅里叶变换(Short-Time Fourier Transform,STFT)。设窗口长 \(L_w\)、步长 \(h\)、窗函数 \(w[n]\),不补齐边界时
频率滤波和对数变换可形成对数梅尔谱等特征;这些操作聚合频谱信息,并不与原波形一一可逆。窗口宽度决定局部时间范围,步长决定帧密度。语音识别模型利用声学条件预测文本,Whisper工作展示了基于大规模语音文本监督的这一任务路线(Radford 等 2022);语音合成则需产生可解码的声学表示,二者的输出目标不同。
若 \(f_s=16000\)、时长2秒,则有32000个样本。取 \(L_w=400\)、\(h=160\),对应25毫秒窗口和10毫秒步长,不补齐时窗口数为
编码器若再以步幅2并按“奇数补齐一帧”的规则下采样一次,则输出99个声学位置。这里明确了边界规则;中心补齐或不同卷积核会得到不同长度,不能只用“每秒约100帧”替代精确形状契约。
离散声学词元及信息取舍
声学词元(Acoustic Token)可以指连续声学表示位置,也可以指音频编解码器产生的离散码。使用时应说明类型。离散码序列可由自回归模型预测,再由声学解码器恢复波形;码率、帧率和每帧码本数共同决定序列量与重建质量。语言文本只表示部分语音内容,通常不完整保留音色、韵律和环境声音。
因此,先转写再交给语言模型的级联系统便于复用文本能力,但会丢失非语言线索并传播转写错误;直接声学融合有机会保留这些信息,却要求相应训练数据与时间处理。对于语音理解,应分别评估语义、说话人、噪声和事件;对于语音输出,还需评估时延、可懂度、音色一致性及授权范围。多种输入模态并不自动赋予所有输出模态的能力。
40.8视频采样、同步及流式因果性
(选修)
帧预算及观测边界
视频可表示为带时间戳的图像序列 \(\{(I_f,t_f)\}_{f=1}^F\)。逐帧编码后,未压缩视觉长度约为 \(FN_v\);每帧重采样到 \(M\) 个位置时为 \(FM\),全视频联合重采样则可进一步限制总长度。不同策略分别保留空间与时间信息,不能只看输出形状相同就视为等价。
设均匀采样间隔为 \(\Delta t\)。在忽略端点、事件持续 \(\delta<\Delta t\) 且事件起点相位均匀分布的构造模型下,至少一个采样时刻落入事件的概率为
例如每秒取2帧,间隔0.5秒,持续0.1秒的事件命中概率仅为0.2。这是采样相位假设下的几何概率,不是视觉模型召回率;即使命中帧,模型仍可能识别错误。没有任何采样帧记录的短暂动作,后续更大语言模型也不能从缺失观测中可靠恢复。
周期采样还可能使快速重复动作混淆。任务驱动采样可以增加变化处的帧密度,但事件检测器会引入自己的漏检。需要长时间范围与局部细节时,可先粗采样定位候选区间,再保留原时间戳细采样;粗阶段没有覆盖的事件仍可能被遗漏。视频不是一组无序照片,帧顺序与间隔都是输入含义的一部分。
声画同步及时钟偏差
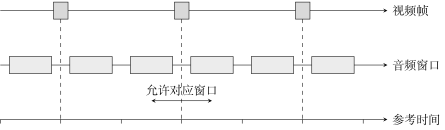
时间对齐(Temporal Alignment)把不同模态的观测映射到共同时间轴。数组下标不能直接互相比较:音频第100个窗口与视频第100帧通常发生在不同时间。可将某音频设备的时间 \(t_a\) 映射为参考时间
其中 \(\beta\) 表示起始偏移,\(\alpha\) 表示时钟尺度误差。恒定偏移只需平移;时钟漂移会随时长积累,不能仅在开头对齐一次。
例如假定音频时钟每秒多计 \(10^{-4}\) 秒,经过600秒会产生0.06秒偏差。若还有0.08秒起始偏移,末端未校正偏差为0.14秒。这个构造例子说明短片段可忽略的误差在长会话中可能改变事件对应关系。时间戳应说明是窗口起点、中心还是终点;窗口中心只能定位代表时间,不表示编码器从未读取其后的样本。
对视频帧 \(t_f\) 与音频窗口代表时间 \(t_m\),可按 \(|t_f-(\alpha t_m+\beta)|\le\epsilon_t\) 建立候选对应关系。容差 \(\epsilon_t\) 的选择取决于任务分辨率和采样精度;容差过宽会混合相邻事件,过窄则出现无匹配。对应关系可为多对多,不能强制每帧恰好配一个音频位置。
流式输入的可用时刻
流式因果性(Streaming Causality)要求某时刻输出只依赖当时已经到达并被允许使用的数据。若一个声学特征来自窗口 \([t,t+25\mathrm{ms}]\),它最早在窗口结束后才完整可用;使用中心时间戳不消除这12.5毫秒的未来等待。双向声学编码器还可能读取后续窗口,因此训练时的注意力范围决定真实前瞻量。
视频与音频具有不同到达抖动。融合层可以等待一个有限同步窗口,再对尚未到达模态标记缺失;无限等待则破坏服务时延,直接沿用旧帧则可能错误绑定到新语音。背压(Backpressure)让下游处理能力约束上游发送或缓存速度,避免媒体队列持续增长。丢帧、降采样或分段策略应保存时间空洞,不能把剩余序列重新编号后伪装成连续观测。
流式输出还需区分暂定转写与最终片段,处理用户打断、输出取消和语音文本同步。多模态模型输出操作建议时,感知置信度不能代替执行授权;对视觉界面或物理环境的理解错误应在受控执行边界被拦截。预测未来状态的模型也不能仅凭生成画面的逼真程度成为可靠控制器。
40.9模型能力及制品一致性
形状语义一致性
形状检查可证明编码器、连接器和语言模型能够连接;监督位置检查可证明学习目标没有明显错位;二者都不能证明视觉理解已学成。随机初始化模型随图像变化而改变逻辑值,只说明图像存在计算路径。输出变化是否与正确视觉事实对应,需要有标注、可控制的任务样本。
可构造只改变图像中一个属性而保持问题不变的样本对,检查答案是否按该属性改变;对计数任务改变对象数量,对空间任务交换对象位置,对文字读取任务替换局部字符。还应使用遮去图像、打乱帧序和错配音频的对照。如果去掉图像后仍答对,可能是问题本来不依赖图像,也可能是模型利用了语言先验;需要通过平衡样本区分这两种解释。
评估应分别覆盖文字识别、图表、细粒度属性、空间关系、多图指代、时间定位与声画对应。证据区域和时间区间有助于判断答案依据,但模型输出一个框并不能自动证明框内支持结论。图文对比匹配高分与条件生成流畅同样不能替代这些任务指标。
依赖及能力边界
模型制品应保存感知编码器、连接器、语言主干、输出解码器、预处理器、分词器、模板、精度与后端配置。多组件许可和使用条件也应逐一核对,不能把语言主干的许可自动推广到视觉编码器、训练数据和整个组合模型。本章不根据品牌名称给出开放程度或能力排序。
服务预算需同时记录分辨率、图像数、帧率、媒体时长、压缩前后视觉及声学长度、文本长度和生成长度。高分辨率、多页与长视频不是同一种压力来源;入口应在解码前后都控制资源,避免压缩文件体积小却解码后极大的输入耗尽服务资源。
媒体中的文字和声音仍属于外部数据,不能改变系统权限。跨模态提示注入、身份或声音冒用、来源不明素材与敏感元数据分别需要相应的数据和执行边界。输出图像、音频和视频的系统还需保留来源与生成记录,并明确允许的使用范围。感知理解、内容生成和行动执行具有不同的错误后果,应该分别验收。
投影、重采样与前缀是不同维度的设计选择:前两者描述表示变换,前缀描述语言模型如何接收结果。一个系统可以同时使用三者,因此不宜把它们列为互斥的三个模型类别。↩︎