模型的计算量描述必须完成的工作,基础设施决定这些工作怎样获得数据、执行运算并保存结果。即使参数和中间状态能够放入显存,训练仍可能因数据准备不及时、通信拥塞或检查点写入过慢而停顿。反过来,增加设备峰值算力,也不会自动缩短一个受显存带宽限制的解码步骤。
第27章《模型规模及资源预算》建立了工作负载的资源需求。本章建立供给侧的解释框架:先考察单个加速器内部,再沿主机、互连、存储与调度扩展到集群。分布式训练章进一步讨论张量和优化器状态怎样切分;本章主要分析这些算法所依赖的物理通路及其约束。所有数值例题均为明确设定输入的工程计算,不代表任何硬件型号的实测结果。
28.1系统边界及计量单位
性能模型的共同前提
计算工作量固定,数值精度与输出质量要求一致;一次乘法和一次加法合计两个浮点操作。带宽指指定路径上的有效数据字节率,不能把链路标称比特率直接代入。除特别说明外,计算模型忽略启动和排队,通信模型单独计入启动延迟;后文将说明这些近似在哪些条件下失效。
| 符号 | 含义与单位 |
|---|---|
| \(F,Q,I\) | 运算量(FLOP)、跨指定存储层传输字节数(byte)、算术强度 \(I=\frac{F}{Q}\)(FLOP/byte)。 |
| \(R_{\mathrm{peak}},R\) | 与精度和算子匹配的峰值操作率、实际操作率,单位 FLOP/s。 |
| \(\beta_{\mathrm{mem}},\beta_{\mathrm{net}},\beta_{\mathrm{io}}\) | 显存、网络和存储路径的有效带宽,单位 byte/s。 |
| \(\alpha,\beta_{\mathrm{inv}}\) | 通信启动时间(s)与每字节传输时间(s/byte);\(\beta_{\mathrm{inv}}=\frac{1}{\beta_{\mathrm{net}}}\)。 |
| \(p,m\) | 通信参与进程数与每进程初始消息长度(byte)。 |
| \(S_c,C,\tau,M,R_f\) | 检查点大小(byte)、写入暂停时间、有效计算间隔、作业平均故障间隔、恢复时间,时间均以秒计。 |
| \(B,d,k,n,s\) | 矩阵批量或矩阵维度,以及每元素存储字节数;含义由对应公式明确指定。 |
前章以 \(\beta\) 表示带宽,本章仍以带下标的 \(\beta\) 表示字节率。经典通信文献所谓“\(\alpha\)–\(\beta\) 模型”中的第二项通常表示带宽的倒数,因此本章专门写为 \(\beta_{\mathrm{inv}}\),避免同一个符号在两个模型中承担相反单位。
十进制 GB 与二进制 GiB 分别为 \(10^9\) 与 \(2^{30}\) 字节;GB/s 与 Gb/s 还相差每字节八比特。双向链路同时发送和接收的总标称值,也不等于某个单向传输能够使用的带宽。性能报告必须写明方向、协议开销、消息大小和并发条件。
28.2加速器计算模型
线程、线程束及计算单元
图形处理器(Graphics Processing Unit,GPU)通过大量并发线程执行可分解的计算。程序中的一个线程通常负责若干数据元素,若干线程组成线程块,线程块再分配到片上的计算单元。线程块是资源分配和局部协作的重要边界,不能把软件线程数直接解释为物理算术单元数。
以 NVIDIA CUDA 的抽象为例,单指令多线程(Single Instruction, Multiple Threads,SIMT)以线程束(Warp)组织线程,通常每束包含32个线程;流式多处理器(Streaming Multiprocessor,SM)承担线程束调度和执行。线程保有各自寄存器和控制状态,执行时由活跃线程掩码决定哪些通道参与当前指令。同一束内的数据相关分支可能需要分别执行不同路径,从而降低有效通道利用率。独立线程调度并不意味着分支分歧的代价消失。上述名称和束宽属于特定编程体系,其他加速器的线程组结构与调度粒度应按其架构定义理解。(NVIDIA 不详a)
线程束切换可以在一组线程等待内存时发射另一组就绪线程,但前提是仍有独立工作和可驻留资源。设一个 SM 的寄存器容量为 \(R_{\mathrm{SM}}\) 个寄存器,每线程使用 \(r\) 个寄存器,每块 \(t\) 个线程,每块共享存储需求为 \(h\) 字节,则忽略分配粒度时,驻留块数受到
约束。其中 \(H_{\mathrm{SM}}\) 是共享存储容量,\(T_{\mathrm{SM}}\) 是最大驻留线程数,\(n_{\mathrm{arch}}\) 是硬件块数上限;\(h=0\) 时去掉对应项。真实硬件还按分配粒度取整,因此这是解释资源约束的上界模型。
占用率(Occupancy)是活跃驻留线程束数与硬件允许的最大驻留线程束数之比。提高占用率可能改善延迟隐藏,但不保证提高性能。如果减少寄存器导致临时值溢出到较慢存储,或者更多线程争用相同带宽,较高占用率反而可能使运行时间增长。必须把占用率、发射效率、访存停顿和有效操作率放在一起解释。
矩阵单元及精度
大规模矩阵乘法具有规则的数据复用结构,专用矩阵乘加单元可用块状指令计算 \(D=AB+C\)。NVIDIA 将这类单元称为张量核心(Tensor Core);不同平台对输入形状、数据类型、累加精度和稀疏结构的要求不同。高峰值只有在运算被映射到相应指令、块形状能够有效填充且数据供应充分时才有意义。
以 \(A\in\mathbb R^{m\times k}\)、\(B\in\mathbb R^{k\times n}\) 为例,主要运算量约为 \(2mkn\)。若硬件块尺寸要求对维度补齐到 \(\widetilde m,\widetilde k,\widetilde n\),则实现可能执行约 \(2\widetilde m\widetilde k\widetilde n\) 个操作。报告以有效数学操作数为分子时,补齐部分不能算作任务吞吐;以硬件指令操作数为分子时,则必须说明它包含无效填充。
半精度浮点(Half Precision Floating Point,FP16)与脑浮点16(Brain Floating Point 16,BF16)均占两个字节,但指数和尾数分配不同。FP16具有更细的同量级表示精度,BF16具有更大的指数范围。低位宽格式改变的是表示范围、舍入误差、传输字节数和可用指令,不能只看“位数更少”。八位浮点(8-bit Floating Point,FP8)还包含不同指数和尾数组合,具体格式必须与缩放规则、累加类型一并记录。
例如,把权重从两字节压缩到半字节,理论上可减少四倍权重读取字节,但实际还需读取缩放因子,并执行解码或反量化。如果运行时先把整层权重展开成两字节矩阵再调用普通乘法,文件变小并不能保证关键路径上的带宽减少。另一方面,即便输入采用低精度,某些归约和累加仍应使用更高精度。数值方法与执行格式必须共同确认,不能以格式名称替代质量验证。
寄存器到显存的层次
高带宽内存(High Bandwidth Memory,HBM)为设备提供较大容量的外部存储,但线程每次从 HBM 取数,通常比复用片上数据付出更高的数据搬运成本。寄存器保存线程私有的热数据,共享存储供块内协作,片上缓存减少重复外部读取。容量逐层扩大时,访问成本通常也随之上升;这些层次不能视为等价的“大显存”。
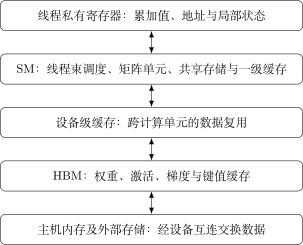
矩阵乘法的分块实现把输入片段载入片上存储,反复参与多个输出元素的计算,再写回结果;其目的首先是复用数据。相邻线程访问相邻地址有利于合并访存(Coalesced Memory Access),而离散访问可能把有效字节分散到多个事务中。共享存储中的访问也可能出现存储体冲突;加大分块一方面增加复用,另一方面消耗寄存器和共享存储,必须与驻留资源约束共同选择。
注意力中的大中间矩阵说明了这一层次的价值。将分数矩阵完整写入 HBM 再读回,会产生额外流量。分块与在线归一化可以避免这些中间写入,保持相同数学运算语义,而主要改变存储访问量。类似地,算子融合省去中间张量的往返,却可能增加寄存器压力。基础设施分析需要分别记录“减少了多少操作”和“减少了哪一层的多少字节”。
28.3Roofline 性能模型
性能上界推导
设一个算子执行 \(F\) 个浮点操作,并在 HBM 与计算芯片之间传输 \(Q\) 字节。即使计算单元没有停顿,运行时间也不能小于 \(\frac{F}{R_{\mathrm{peak}}}\);即使访存完全规则,也不能小于 \(\frac{Q}{\beta_{\mathrm{mem}}}\)。因此
其中 \(I=\frac{F}{Q}\) 称为算术强度(Arithmetic Intensity)。屋顶线模型(Roofline Model)将这两项上界画在同一坐标系中,区分带宽约束与计算约束。(Williams, Waterman, 和 Patterson 2009)
两项相等时的转折点为
当 \(I<I_*\) 时,提升峰值算力不会提高该模型中的上界;当 \(I>I_*\) 时,仅提升 HBM 带宽也不会抬高计算平台。实际算子可能远低于上界,因为依赖链、分支、同步、启动和不规则访存尚未计入。若计算与访存不能充分重叠,时间还会向两项之和靠近。
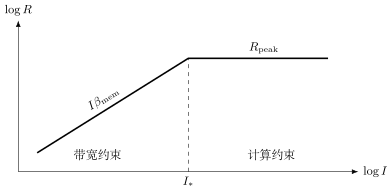
本模型必须注明字节跨越哪个层次。用 HBM 字节计算的强度,不能乘以寄存器带宽;缓存命中减少 HBM 流量后,相应强度会改变。峰值也必须匹配实际精度和稀疏条件。将结构化稀疏峰值与稠密算子的操作量混用,会得到没有可比性的利用率。1
矩阵乘法批量计算
例27.1
考虑 \(Y=XW\),其中 \(X\in\mathbb R^{B\times d}\)、\(W\in\mathbb R^{d\times n}\)、\(Y\in\mathbb R^{B\times n}\),每元素 \(s\) 字节。若输入与权重各从 HBM 读取一次,输出写入一次,则理想流量与操作量为
该流量是特定冷数据边界下的理想值;中间块重复读取会增加 \(Q\),权重已经在缓存中则会改变该边界。假设 \(d=n\) 且 \(d\) 远大于 \(B\),权重项主导,得到
这解释了小批量矩阵向量乘法与大批量矩阵乘法为何可能受到不同约束:同一份权重被更多行复用,单位搬运字节支持更多运算。
取 \(d=n=4096\)、\(s=2\),当 \(B=1\) 时,
当 \(B=64\) 时,
设一台抽象设备对该精度的峰值为 \(100\times10^{12}\) FLOP/s,有效 HBM 带宽为 \(2\times10^{12}\) byte/s,则 \(I_*=50\) FLOP/byte。第一个形状的上界约为 \(2\) TFLOP/s,第二个形状的上界达到计算平台 \(100\) TFLOP/s。这并未证明批量64能取得该性能,只说明在理想复用条件下,它已不再受到同一带宽上界限制。
自回归解码还读取随上下文增长的键值缓存,因此不能只按权重项计算强度。预填充常有更大的矩阵行维度,但长上下文注意力、掩码和实现方式也会改变流量。将所有预填充一概称为计算受限、所有解码一概称为带宽受限,均超出了上述推导的前提。
28.4主机及设备亲和性
CPU 及 NUMA
中央处理器(Central Processing Unit,CPU)承担解压、分词、样本整理、调度和网络控制等工作。CPU 核数并不能独立决定数据准备速度:线程可能竞争内存带宽,解压可能受单线程路径约束,过多加载进程还会增加上下文切换和缓存失效。
非一致内存访问(Non-Uniform Memory Access,NUMA)表示不同处理器访问不同内存节点具有不同距离与代价。一个工作进程即使绑定在靠近 GPU 的 CPU 上,其数据页仍可能位于另一 NUMA 节点,跨插槽访问因此仍会发生。处理器绑定、内存分配策略和已有页面位置必须同时考虑;改变分配策略也不等于自动迁移全部已有页面。(The Linux Kernel Documentation 不详)
高速串行计算机扩展总线(Peripheral Component Interconnect Express,PCIe)连接设备和主机。拓扑中的根复合体、交换芯片和上行链路决定哪些设备共享带宽。两个各自具有高标称带宽的设备,可能共同经过一条较窄上行链路;GPU、网卡和本地盘的“总数量”因此不能替代拓扑图。
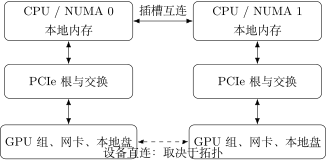
设备亲和性(Device Affinity)要求把频繁交换数据的进程、内存、GPU 和网络接口放在合适路径上。设备到设备的直接访问也需要硬件、地址映射、驱动和权限共同支持,不能从“同一台服务器”推定所有设备能够直接互访。GPU 与网卡之间的直接数据通路可以省去主机中转,但仍需建立映射、同步完成事件并遵守设备访问顺序。GPUDirect RDMA 的官方说明明确指出其平台和 PCIe 拓扑限制。(NVIDIA 不详b)
数据加载及重叠
页锁定内存(Pinned Memory)固定主机页的位置,便于设备通过直接内存访问(Direct Memory Access,DMA)传输数据。它可以支持适当条件下的异步拷贝,但并不自动让拷贝与计算重叠。程序还必须建立不同批次之间的流水,并确保当前计算使用的数据已经完成传输。
若读取、CPU 整理、主机到设备传输和计算分别耗时 \(t_r,t_p,t_h,t_g\),完全串行处理一批需要
在资源足够独立、缓冲充分且批次间无额外依赖时,稳定流水的批间隔至少为
首批仍须经过完整路径,末批仍存在排空时间。如果读盘与网络共同竞争 PCIe 上行,或者拷贝与算子共同竞争 HBM,独立性假设不成立,不能直接取最大值作为实际耗时。
设数据消费速度为 \(r_b\) 批/s,希望吸收最长 \(J\) 秒的短暂供给抖动,缓冲至少需要约 \(r_bJ\) 批。缓冲只吸收短时波动:当生产速率长期低于消费速率时,任何有限队列最终都会耗尽。过深预取也可能占用大量内存,并在取消、抢占或数据顺序变化时增加无效工作。
算法28.1 有界预取与双缓冲
输入:固定版本的数据分片、批次变换、缓冲上限 \(K\)。输出:按规定顺序交付设备的批次。状态:有界主机队列、两个设备缓冲区及各自的完成事件。
加载进程读取下一批,完成校验与 CPU 变换;队列满时等待,不继续无限预取。
传输进程等待空闲设备缓冲,将下一批从页锁定主机区异步传入,记录传输完成事件。
计算进程等待该事件后使用缓冲;计算结束记录消费完成事件,之后才允许覆盖。
在另一缓冲传输后继批次,使可独立的传输与当前计算重叠。源数据耗尽后排空队列;取消或错误时传播终止状态并回收未消费缓冲。
不变量:缓冲被消费前必须传输完成;计算完成前不可复用;队列长度不超过 \(K\);失败批次不可静默跳过而改变训练样本序列。
28.5互连及集群通信
节点内及节点间网络
节点内可以使用 PCIe 或专用加速器互连,例如 NVLink 体系中的链路与交换结构。专用互连的意义在于改变设备之间的可达路径、带宽和延迟,而不是把多卡变成无成本共享的一块显存。远端访问仍需要传输,某些共享地址空间也不意味着访问延迟一致。
节点间网络通常由网卡、接入交换和汇聚交换构成。InfiniBand 网络(InfiniBand,IB)和以太网是不同的网络体系;融合以太网远程直接内存访问(RDMA over Converged Ethernet,RoCE)在以太网络上提供 RDMA 传输。远程直接内存访问(Remote Direct Memory Access,RDMA)允许设备在预先授权和注册的内存区域之间传输数据,减少常规数据路径上的 CPU 参与,但连接管理、内存注册、完成处理与错误恢复仍然存在。
链路带宽决定持续搬运能力,延迟决定小消息启动成本。超售比(Oversubscription Ratio)可在指定交换层定义为下行总带宽与上行总带宽之比;大于1意味着所有下行不能同时按线速通过上行。割带宽(Bisection Bandwidth)衡量将网络分成两组时跨割能够通过的带宽。讨论双向割带宽时必须说明是两个方向的和还是每方向值,不能用全网端口带宽总和代替跨组吞吐。
相同端口速率下,邻近设备通信、跨交换层通信与全体同时交换可能表现完全不同。专家路由还可能产生多对一突发:平均字节率低于链路容量,并不能排除某一接收队列瞬时溢出。拓扑、路由、消息分布和其他租户负载因此属于通信模型的输入。
拥塞控制及故障域
显式拥塞通知(Explicit Congestion Notification,ECN)通过网络标记让端点感知拥塞并调整发送。基于优先级的流量控制(Priority-based Flow Control,PFC)可对指定优先级暂停上游发送。二者职责不同:前者试图调整负载,后者在链路上施加反压。暂停可能把拥塞向上游传播,并影响共享优先级的其他流。RoCE 部署应结合网卡能力、交换缓冲、端到端拥塞算法和具体拓扑设计,不能将“开启 PFC”视为完整方案。是否采用无损配置及其参数应以锁定环境的官方资料为准。(NVIDIA 不详d)
故障域是一次失效能够共同影响的资源集合。一个网络端口、交换机、机架供电或共享存储都可能构成不同故障域。把一个同步训练作业跨越更多设备,可提高资源规模,也扩大了任何单点失效中断整个作业的范围。在线推理的多个完整副本则可以分布于不同故障域,使单组故障不同时影响全部流量;单个张量并行组仍需要组内协作完成请求。
集合通信的时间模型
集合通信(Collective Communication)是一个进程组共同完成的数据交换操作。全归约(All-Reduce)让所有参与者得到逐元素归约结果;归约散播(Reduce-Scatter)将归约结果分片交给各参与者;全收集(All-Gather)将各自分片组成完整结果;全互换(All-to-All)允许每个参与者向其他参与者发送不同分片。这些是数据语义,不指定唯一网络算法。参与进程的调用次序、数据类型与长度必须满足通信接口约定,否则可能发生挂起或错误。(NVIDIA 不详c)
先考虑一条有效链路传输 \(m\) 字节。将不可随消息长度摊薄的启动成本记为 \(\alpha\),持续传输每字节成本记为 \(\beta_{\mathrm{inv}}\),得到
小消息满足 \(m\ll\alpha\beta_{\mathrm{net}}\) 时受延迟主导,大消息反之。该线性模型不包含排队和拥塞,参数须从相同路径与消息范围估计,不能把空闲网络的带宽直接用于拥塞时段。
对 \(p\) 个进程的环形全归约,每个进程初始有 \(m\) 字节,把消息均分为 \(p\) 块。归约散播经过 \(p-1\) 轮,每轮发送约 \(\frac{m}{p}\) 字节;全收集再经过 \(p-1\) 轮。若各链路同时工作,忽略本地归约与拥塞成本,则
式中第二项对应每进程发送量,不是全网总字节数。若归约每字节消耗 \(\gamma\) 秒,还可加入约 \(\frac{(p-1)m\gamma}{p}\),但计算与网络是否重叠需要进一步分析。
作为对照,考虑不分块的二叉树归约加广播,且 \(p\) 为2的幂。每阶段高度为 \(\log_2p\),每层在关键路径上传送完整消息,粗略成本为
它的启动轮数更少,完整消息传输项却可能更大。分块树、双树与分层实现会改变该模型;这里的比较只能用于解释为何小消息与大消息可能选择不同算法,不能据此宣布树或环普遍更快。
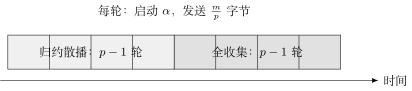
例如令 \(p=8\)、\(m=256\) MiB、\(\alpha=5\) 微秒、有效单向带宽 \(25\) GiB/s。每轮数据为32 MiB,传输时间为 \(\frac{32}{25\cdot1024}=0.00125\) s。于是
其中启动只占70微秒。若消息缩为8 KiB,则每轮仅1 KiB,全部传输项约0.534微秒,70微秒启动项成为主导。这是同一参数模型内的构造比较;真实小消息协议可能具有不同参数。
把通信隐藏在反向计算后面,只能隐藏数据已就绪且不阻塞后继计算的部分。若计算耗时 \(t_c\)、通信耗时 \(t_n\)、实际重叠时间为 \(t_o\),则
最后一个梯度分片的通信往往处于关键路径,不能被已经结束的计算隐藏。通信内核还可能占用计算资源或显存带宽,因此重叠本身也可能改变 \(t_c\) 与 \(t_n\)。
28.6存储系统及数据通路
容量、带宽、请求率及元数据
非易失性存储器快速接口(Non-Volatile Memory Express,NVMe)为高速非易失存储访问定义接口体系。(NVM Express 不详)本地 NVMe 存储常用于数据缓存、权重预热和暂存;它靠近计算节点,但节点失效后未必仍可访问。分布式文件系统提供路径与文件操作语义,便于共享数据;对象存储以键和对象为基本操作单位,适合不可变数据分片与模型制品。不同实现的并发、缓存和一致性条件不同,不能把三者仅按容量大小排序。
每秒输入输出操作数(Input/Output Operations Per Second,IOPS)衡量完成请求的速率,带宽衡量完成字节的速率。若每请求有效负载为 \(q\) 字节,设备持续处理能力为 \(a\) 次/s,则
例如,吞吐上限为2 GiB/s的路径,若只能完成每秒10000次4 KiB读取,有效吞吐上限为约39.06 MiB/s。这里的两个数字是设定条件,说明高顺序带宽不能保证高随机小读吞吐。
元数据(Metadata)包括名称、目录项、权限、大小和分片索引等描述信息。若每个训练样本都需要打开一个文件,即使样本字节很少,目录查找与打开操作仍可能首先饱和。将样本组织成可索引的大分片,可以摊薄请求和元数据成本,但也会改变随机访问、恢复位置与负载均衡方式。全局随机性不必通过“每个样本一次完全随机远程读”实现,可在分片调度与分片内缓冲之间建立可复现的打乱策略。
队列深度也影响并发。若平均完成延迟为 \(l\) 秒,稳定请求率为 \(a\) 次/s,则平均在途请求数近似为 \(al\)。为了取得更高吞吐,需要足够在途工作,但无限增大队列会增加尾延迟和内存占用。对同步训练,某个节点数据读取的长尾可能让整个进程组在下一次集合通信处等待,所以平均吞吐之外还需关注高分位延迟。
数据集、权重和检查点的不同负载
训练数据通常持续读取,权重分发往往集中在启动时,检查点则周期性产生大写入。三种流量共享存储或网络时,不能只计算各自平均值。权重加载还可能形成启动风暴(Startup Storm):大量实例同时请求相同制品,把对象存储出口、节点网络或解压 CPU 推到极限。
分层缓存将权威不可变制品与节点热副本分开。模型文件先按版本和内容摘要确认,再进行有界并发分发、本地预热及设备加载。只有校验、加载与必要初始化完成,实例才能进入就绪状态。缓存命中降低远程读取,但不会消除本地盘到主机、主机到设备的传输时间;预先加载也会消耗容量和带宽,因此需要与任务计划协调。
检查点包含恢复训练所需的模型、优化器、调度器、随机状态和数据位置等信息。保存权重文件不一定等于保存可恢复的训练状态。对于分片训练,各文件必须对应同一个逻辑步骤;部分进程写入新步骤、部分仍停在旧步骤,会生成彼此不一致的状态集合。
一致性(Consistency)说明读写的可见性与顺序,持久性(Durability)说明确认数据能承受哪些失效,完整性校验则用于发现内容损坏。这些保证彼此不能替代。以 Amazon S3 文档为例,单键更新的原子性与强读后写一致性并不提供跨多个键的原子事务。(Amazon Web Services 不详) 因此,多分片检查点仍需应用层提交协议,不能因底层对象写入成功就认为整个检查点已经提交。
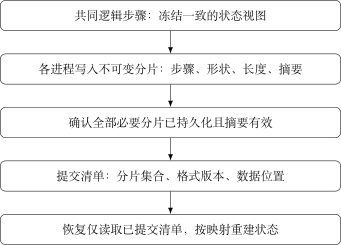
异步检查点减少训练等待的前提,是先获得稳定快照,再在后台传输。若后台读取的张量仍被优化器修改,得到的可能是不同时间状态的混合。快照复制、写时复制或等价的一致性机制都会消耗内存和带宽。暂存到本地盘可以缩短前台暂停,但在远端持久化之前,不能宣称具有远端存储对应的容灾能力。
存储吞吐量测算
例27.2
考虑8个节点、每节点8个加速器的训练作业,共64个设备。设每设备有效处理20000词元/s,每词元编号4字节。为隔离不同成本,先只计算已经分词后的编号读取,不包含掩码、索引和原始多模态数据。总词元率为
对应最小编号读取带宽
如果每次远程请求仅获取4096个编号,则有效负载16 KiB,理想请求率为 \(\frac{1.28\times10^6}{4096}=312.5\) 次/s。改为64 MiB的连续分片读取时,按相同长期字节率平均约每13.11秒读取一个分片。实际8节点并发、预取与缓存使短时请求率不同,但可以看到请求组织与有效字节率是独立决策。
进一步设训练所需全局检查点为2 TiB,每30分钟产生一次,要求120秒内完成持久化。它的长期平均写带宽为
而写入窗口内所需带宽为
两者相差15倍。均匀分片时每节点写256 GiB,窗口内每节点至少需要约2.133 GiB/s;若64个进程均匀分担,每进程为32 GiB。以上只计算有效状态字节,不含重试、校验和冗余编码在后端产生的额外流量。
假设所选共享存储路径在相应读写混合条件下的总有效能力被设定为40 GiB/s,其他作业在该窗口已经占用24 GiB/s,剩余能力只有16 GiB/s。即使检查点长期平均带宽远小于剩余能力,120秒目标仍不能满足:
训练编号读取约占0.00477 GiB/s,计入后下界还会略高;元数据和提交时间也尚未计入。可行调整包括错开共享写入窗口、为检查点预留更高带宽,或者在恢复目标允许时放宽窗口。仅扩大预取缓冲无法改变这项持续传输下界。
如果每个存储请求携带64 MiB,17.067 GiB/s约对应273.07次/s;如果拆成1 MiB,则约需17476.27次/s。单次检查点的数据对象数量分别为32768与2097152。后者还显著增加清单、校验和元数据操作数量。较大对象可以摊薄请求成本,但过大的不可分割请求也可能增加重试成本,必须保留分块校验与可恢复传输能力。
最后考察恢复。若同一2 TiB检查点的存储读取能力为32 GiB/s,恢复网络路径为16 GiB/s,聚合设备加载能力为24 GiB/s,理想充分流水的时间下界为
若三个阶段必须完全串行,则仅传输约需 \(64+128+85.33=277.33\) 秒。真实恢复还包括资源重新分配、进程组建立、反序列化、状态映射和校验,故不能直接把128秒作为恢复承诺。这一算例表明,训练数据读取、检查点窗口与故障恢复可能对应完全不同的主瓶颈。
28.7训练及推理集群的组织
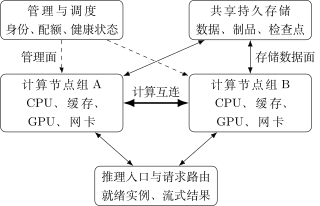
训练集群中的同步组要求多进程共同前进,数据供给和检查点也与训练步骤相关;推理集群需要进一步处理请求到达、排队、取消、输出长度差异和流式返回。两者可以共享硬件资源池,但不应因此共享无约束的调度和带宽策略。长时间训练吞吐目标与在线服务尾延迟目标可能相互冲突。
控制面(Control Plane)负责准入、版本、资源分配和恢复决策,数据面(Data Plane)执行模型计算与数据传输。管理网络故障可能使调度信息暂时不可用,而计算网络故障可能直接打断集合通信;共享同一物理网络时,应识别这种故障相关性。分离逻辑职责不一定要求每类流量使用独立硬件,但必须有容量与隔离依据。
推理状态还具有不同的寿命。权重通常按模型版本共享,键值缓存属于具体请求或可严格标识的前缀。键值缓存(Key-Value Cache,KV Cache)外置到主机、磁盘或远端存储后,容量增加但访问路径变长。若迁移 \(S_{\mathrm{KV}}\) 字节,单纯传输下界为 \(\frac{S_{\mathrm{KV}}}{\beta_{\mathrm{net}}}\),还需加排队、序列化和同步。只有节省的重算或排队成本超过新增成本,迁移才可能改善服务目标。
预填充与解码分离(Prefill/Decode Disaggregation,P/D 分离)把前缀计算与逐词元生成分配到不同资源池,可以隔离长提示干扰,但同时增加 KV 传输和跨池协调。分页缓存减少分配碎片,不消除有效 KV 字节;跨实例共享也必须绑定模型、适配器、位置配置、精度、完整前缀与租户权限。基础设施不能仅凭“缓存命中”绕过这些语义条件。
28.8资源调度、兼容性及隔离
运行兼容矩阵
加速器程序依赖设备指令集、固件、驱动、运行时、通信库、编译器、框架和算子库的共同支持。容器封装用户态依赖,却不自动替换主机驱动,也不保证目标设备具有对应指令。一个模型能够导入框架,并不证明其低精度矩阵核、注意力后端和跨卡通信均已可用。
| 层次 | 必须明确的条件 | 不满足时的后果 |
|---|---|---|
| 设备与固件 | 指令、精度、内存、互连能力 | 运算不支持或资源不足 |
| 驱动与运行时 | 锁定版本及相容范围 | 初始化失败或路径不可用 |
| 通信库与网卡 | 传输后端、拓扑、权限、协议 | 回退到较慢路径或挂起 |
| 框架与算子 | 形状、布局、精度、掩码支持 | 图断裂、重编译或低效回退 |
| 模型制品 | 分片布局、量化元数据、版本 | 加载失败或数值语义改变 |
国产与国外加速器的迁移都应按照这张依赖关系表进行。源代码层可移植,不等于执行内核和通信库可直接复用;仅替换设备字符串尤其不能证明等价。迁移成本来自算子覆盖、编译后端、数值格式、分布式通信、诊断工具和维护周期。应先建立模型所需运算及张量形状清单,再逐项确认正确性和目标路径性能,而不是按品牌推断成熟度。版本升级应形成新的兼容矩阵与回退制品,避免一次性更换所有层后无法定位回归来源。
国产加速软件栈
以 Ascend Extension for PyTorch 官方历史标签 v2.5.1-7.1.0 的兼容矩阵为例,其中一行将 PyTorch 2.5.1、扩展 torch_npu 2.5.1.post1 与 CANN 8.2.RC1 对应起来(Ascend 2025)。这是一组可核对的历史版本关系,不代表任意新旧版本可以混装,也不是对当前部署版本的推荐。
这里 PyTorch 表达模型与自动微分图,设备扩展承接设备与算子调用,CANN 提供底层加速软件能力;分布式运行还必须确认适用的集合通信后端。迁移检查应沿这条调用链展开:框架成功导入,只能证明基础加载路径;目标数据类型与形状下的前向、反向和掩码行为正确,才支持算子等价;实际张量并行配置下的集合通信完成,才支持协同执行。出现未覆盖算子、主机回退或隐式格式转换时,单算子正确也可能伴随严重吞吐损失。兼容矩阵因而应记录设备型号、驱动、扩展、底层运行时、通信后端及模型运算范围,并分别记录正确性与性能证据。
成组调度及拓扑放置
成组调度(Gang Scheduling)要求协作任务达到共同启动的最小资源条件后才分配运行,避免部分进程长期占有设备却只能等待其他进程。固定规模同步训练通常要求整个进程组齐备;允许弹性的算法可以定义其他最小规模,但改变成员后还需重新建立状态与通信关系。Volcano 的 Gang 插件以作业最小可用任务数表达这种准入约束。(Volcano Authors 不详)
调度对象应是资源向量和拓扑约束,而不只是 GPU 数。一个作业同时要求设备容量、CPU、主机内存、网络路径、临时存储和可用软件栈。即使全局空闲设备数足够,设备分散在不满足互连要求的节点上,也可能无法满足性能目标。异构设备共同执行同步任务时,最慢参与者与最弱通信路径可能决定步骤时间;异构分配应与任务分解方式相匹配。
抢占(Preemption)把资源从低优先级作业转交给高优先级作业,但其成本包括检查点保存、后续恢复和丢失计算。调度器若频繁抢占同一长作业,设备忙碌时间很高,有效训练进度却可能很低。配额约束资源份额,拓扑放置控制物理路径,抢占策略控制资源转移,三者应共同设计。
算法28.2 协作作业的资源准入
输入:资源向量、协作规模、兼容矩阵、优先级与恢复策略。输出:可启动的放置方案,或保留在等待队列中的作业。
过滤不兼容、不健康或无租户访问权限的节点。
在剩余节点中搜索满足设备、主机内存、网络与临时存储约束的完整资源组,并估计跨节点关键路径。
检查配额和优先级;若必须抢占,确认被抢占作业的保存窗口与恢复成本符合策略。
以组为单位预留资源,完成进程启动与通信就绪确认。部分启动失败时释放本次预留并报告原因,不能无限占有剩余设备。
作业运行期间观察进度与健康;完成时释放资源,失效时按通信组边界终止或进入已定义的弹性恢复流程。
不变量:未经完整准入的资源组不进入协作计算;预留具有超时;恢复不会把旧成员的完成消息误认为新进程组的状态。
租户隔离及观测
多租户隔离(Multi-tenant Isolation)同时包含身份权限、数据边界和资源干扰控制。访问控制决定租户能读写哪些模型、数据和检查点;资源配额约束容量;调度与限流约束带宽和执行份额。共享缓存、日志、设备内存和性能指标还可能跨越数据边界,因此隔离不能只依赖容器名称。
整卡分配、硬件资源分区和时间共享具有不同的容量与干扰特征。可用的硬件分区能力必须按设备和运行时确认;时间共享通常不能提供等同于独占硬件的尾延迟隔离。观测需要将作业进度与设备、CPU、网络队列、存储请求和错误事件关联起来,并保留租户范围。单一“GPU 利用率”指标不能说明设备是在做有效计算、等待通信,还是频繁执行短小内核。
28.9可靠性、供电及散热
(选修)
作业故障传播
设备失效、网络分区和存储不可用可能通过同步关系放大。一个参与进程停止,其他进程可能阻塞在下一次集合通信;如果应用只重试其中一个进程,却没有重建共同步骤与进程组,旧请求与新请求可能发生次序不一致。故障处理必须区分局部可重试操作与需要整组恢复的状态变化。
检查点恢复也需要处理格式和并行布局。如果恢复设备数不同,原分片可能需要重排;模型权重能够重分片,不代表优化器状态、随机状态和数据位置已经正确恢复。可恢复性应通过完整恢复路径定义,而不是通过“文件写入成功”定义。2
检查点间隔的简化推导
假设作业故障近似服从均匀稳定的泊松过程,平均故障间隔为 \(M\);每进行 \(\tau\) 秒有效计算暂停 \(C\) 秒保存检查点,恢复耗时 \(R_f\)。若 \(C,R_f,\tau\) 相对 \(M\) 较小,忽略保存与恢复期间再故障等高阶项,每单位有效时间的损失比例近似为
第一项是周期性暂停;故障在两次保存之间近似均匀出现,平均丢失 \(\frac{\tau}{2}\) 的计算,给出第二项;第三项是故障恢复本身。对 \(\tau\) 求导,
二阶导数 \(\frac{2C}{\tau^3}>0\),故为该近似模型中的极小值。它说明保存越昂贵,适宜间隔越长;作业越容易故障,适宜间隔越短。它不是复杂真实系统的通用精确公式。
例如,若暂停保存需要60秒,作业平均故障间隔为24小时,则
约53.7分钟。在该间隔处,保存损失与丢失计算两项分别约为1.86%。恢复项仍需另算。若检查点异步写入,\(C\) 应表示前台有效暂停,并另分析后台资源竞争;不能把整个远端传输时间机械地代入暂停项。
若 \(p\) 个节点独立且具有相同失效率 \(\lambda\),任何一个失效都会使作业停止,则作业失效率为 \(p\lambda\),平均故障间隔为 \(\frac{1}{p\lambda}\)。共享供电、网络或软件缺陷会破坏独立性假设,因此不能从单机平均间隔简单外推所有集群。维护窗口、预告式抢占与突发相关故障也需要不同的保存策略。
功率、温度及有效工作
机架的供电与散热容量限制可持续部署密度。加速器峰值功率之和之外,还包括 CPU、内存、网卡、存储、交换设备和电源转换损失。若热量不能及时带走,设备可能降低频率,可持续操作率因此低于短时峰值。功率封顶也会同时改变能耗和完成时间,不能只比较瞬时瓦数。
设系统运行时间为 \(T\)、实际功率为 \(P(t)\),总用电量为
电能使用效率(Power Usage Effectiveness,PUE)是设施总能耗与 IT 设备能耗之比。(U.S. Department of Energy 2024)使用同一统计周期的 PUE 可估计冷却等设施开销,但不能直接表示模型能效。任务能效更应报告完成每单位有效训练词元或合格输出所消耗的能量,并包含失败、重算和空闲分摊。
总拥有成本(Total Cost of Ownership,TCO)包含资源获得、能源、网络存储、运维和停机等成本。对固定任务,单位有效工作成本可以写成总分摊成本除以合格完成量。利用率提升通常改善固定成本摊薄,但若它来自过度共享、提高错误率或增加重算,分母不会按设备忙碌时间同比增长。敏感性分析应分别改变有效吞吐、能源价格、恢复频率和资源占用时间,避免将某个采购单价作为系统经济性的唯一指标。
备用资源、维护窗口和故障演练也是容量设计的一部分。没有恢复位置的备用检查点,或者没有可用设备的快速重启机制,都不能独立满足恢复目标。供电、散热、网络和存储的冗余应按共同故障域分析,而不是逐项计数后假定整体已经冗余。
同一集群的期限、容量及费用
(选修) 例27.3
继续使用存储算例的8节点、每节点8设备。设目标为 \(1.28\times10^{12}\) 个有效词元,每设备端到端有效速率为每秒20000词元,则64设备的完成时间为
若期限为12天,连续设备数下界为61.73,向上取整为62,再按完整8设备节点放置得到64。这里有效速率假定已计入既定通信、检查点及故障损失,不能再次乘同一损失因子。该速率假设的可行性仍受前述存储约束:必须先修复120秒检查点窗口;若为检查点单独保障20 GiB/s,2 TiB纯写入时间为102.4秒,其余约17.6秒供提交等开销,训练读取另行保障。否则不能将不满足窗口的系统视为已达到假定速率。
假设每节点实际运行功率8 kW,网络和存储合计20 kW,则IT功率为84 kW;PUE为1.2时设施功率为100.8 kW,运行耗电为28000 kWh。电价按每千瓦时0.8个货币单位计算,电费22400;设备折旧及维护若按每设备小时5个货币单位分摊,则为88888.89,二者合计111288.89。这里没有另计融资、闲置期与人员费用,故不能称为采购总成本。若有效速率降至16000,运行时间增至347.22小时,64设备不再满足期限;期限约束给出78设备,按节点取整需80设备。新增节点也会改变网络、功率与存储负载,不能只修改分母。
同一物理集群用于服务时需重新给定服务阶段证据。例如构造8个各占8设备的副本,假设每副本稳定输出800词元/秒、平均回答400词元,算术吞吐上界为每副本2请求/秒。目标12请求/秒且允许负载率不超过0.75时,需要 \(\lceil\frac{12}{2\times0.75}\rceil=8\) 个副本。若每副本可用于缓存的容量为20 GiB、每活动请求的缓存上界为0.5 GiB,容量另限制为40条活动请求。以上速率、长度和缓存均为构造输入;它们不能由训练速率推得,也不单独保证尾时延。排队与调度的联合约束见第31章《批处理调度》中的推理调度与容量管理。
28.10系统性能诊断
测量应按层次回答不同问题。峰值规格界定硬件上限;算子基准说明特定形状、精度和后端的执行能力;端到端训练或推理结果才反映数据准备、通信、排队与恢复等共同成本。三种结果可以相互解释,不能相互替代。
对同一个工作负载,首先固定模型、输入长度、有效批量、精度、并行规模和质量要求,再观察计算内核、HBM 流量、主机准备、网络通信、存储读写和空闲时间。若算子本身接近 Roofline 上界而步骤仍慢,应继续查找算子之间的同步与数据供给;若网络小消息时间占比高,增加链路带宽未必有明显收益;若仅在保存检查点时波动,则应检查窗口资源竞争和快照成本。
瓶颈是路径约束
一次任务能够达到的吞吐受到其必要数据路径共同约束。容量决定状态能否驻留,带宽决定字节能否及时到达,延迟决定细粒度依赖何时推进,可靠性决定已经完成的工作能否保留。只有明确工作量、路径和时间窗口,增加资源才有可推导的作用对象。
推理测量还需区分首词元时延(Time to First Token,TTFT)和每输出词元时间(Time per Output Token,TPOT),声明是否包含请求排队、分词和网络返回。冷启动、首次编译与稳定执行应分别记录。缓存命中率需结合节省的有效工作量,吞吐需结合错误率和尾延迟。训练则应报告有效词元率、步骤分布、通信暴露时间、检查点暂停与恢复损失,不能用补齐词元或反复重算增加的操作量冒充训练进度。
一次可解释的记录至少包括设备与节点拓扑、驱动和库版本、实际算子后端、精度与累加规则、批量和长度分布、数据路径、并行配置、冷热状态与同时运行的负载。容量公式和状态机可以说明机制;只有在目标环境中取得相应测量,才能把结论提升为该配置的性能证据。
扩展阅读
Wafer AI, GPU Performance Engineering Resources:按 GPU 基础、CUDA 与 PTX、内核优化、性能分析、推理引擎和分布式推理组织的学习资源目录;适合在掌握本章的性能模型后,按实际优化任务继续深入。