检索系统需要在规模庞大且不断变化的语料中,找到与当前信息需求有关、可访问并且版本有效的材料。词语是否相同、向量是否接近、排名是否靠前,分别只是相关性的不同近似。系统必须同时回答两个问题:怎样表示并排序候选,以及怎样在有限时间和内存内找到它们。
信息检索(Information Retrieval,IR)输出的是有序材料集合。本章讨论词法评分、表示学习、近似索引与检索评估;下游如何将材料组织为生成上下文、如何核对回答与引用,属于检索增强生成的架构问题。高召回可以提供必要材料,却不自动证明答案正确。
12.1检索对象及语料结构
文档、片段及相关性
令查询为 \(q\),检索对象集合为 \(\mathcal D\),相关性等级为 \(r(q,d)\)。这里的对象 \(d\) 可以是整篇文档、段落或表格片段,必须与标注和评估一致。一个系统用片段排序、另一个系统按文档统计命中时,直接比较数字可能掩盖重复片段占据前列的问题。
语义切分(Semantic Chunking)依据标题、段落、句子、代码或表格结构形成边界,再结合长度限制组织片段。较短片段有利于定位,但可能丢失否定条件、表头和适用范围;较长片段提供上下文,却可能稀释主题并增加编码成本。重叠窗口减少边界遗漏,也增加重复和索引体积,因此应同时计量召回与重复率。
解析阶段应保留标题层级、页码或源偏移、版本、生效时间、语言与访问条件。表格单元脱离表头常失去意义,扫描文档的文字识别错误又会影响精确词匹配。语料质量问题不能一律通过更复杂的编码器补救。原始文档、派生片段与索引条目之间的血缘关系,遵循第18章《训练数据工程基础》所述原则。
表 12.1 主要符号与形状。
| 符号 | 含义 |
|---|---|
| \(N,n_t,f(t,d)\) | 检索对象总数、包含词项 \(t\) 的对象数、对象内词频 |
| \(|d|,\bar\ell\) | 对象的分析器词项长度与平均长度 |
| \(k_1,b\) | BM25 饱和参数与长度归一化参数 |
| \(u,v_d\in\Real^h\) | 查询与文档的 \(h\) 维表示 |
| \(\tau,s(q,d)\) | 对比学习温度与检索分数 |
| \(K,R_q^{(K)},G_q\) | 截断长度、前 \(K\) 个结果、相关对象集合 |
| \(M,m,c\) | 图邻接预算、PQ 子空间数、RRF 平滑常数 |
词法分析及匹配对象
词项(Term)是检索分析器生成的匹配单位,不一定等于语言模型词元。中文分词、大小写、字符规范化、数字编号、同义词与停用词规则都会改变词项集合。查询与文档应使用兼容的分析规则;变更规则一般需要重新构建相应索引。
过度规范化可能破坏型号、错误码和带连字符的标识。对精确编号和普通自然语言,可以使用不同字段及匹配策略,而非强迫所有内容共享同一种切分。字段权重也应作为评分配置,不能在解释分数时忽略。
12.2倒排索引及概率排序
词项候选定位
倒排索引(Inverted Index)为每个词项保存包含它的对象列表,即倒排列表(Posting List)。每个条目可含文档标识、词频、位置和字段信息。查询不再扫描全部文本,而是读取命中词项的列表,合并候选并计算分数。词项位置可支持短语与邻近关系,只有文档标识和词频则不能直接恢复这些约束。
设查询词项集合为 \(T_q\),若完整遍历相关列表,处理量与 \(\sum_{t\in T_q}|P_t|\) 有关;常见高频词会产生长列表。跳跃结构和基于分数上界的剪枝可以减少计算,但必须使用有效上界,才能保持指定评分下的精确前 \(K\) 名。压缩列表减少内存与读取量,也增加解码代价。
概率动机及独立性近似
概率排序思想是在给定查询和固定损失条件下,优先返回相关概率更高的对象。为说明稀有词为何重要,考虑二元相关变量 \(R\) 和词项出现指标 \(x_t\in\{0,1\}\)。假设给定 \(R\) 后词项条件独立,记 \(p_t=P(x_t=1\mid R=1)\)、\(u_t=P(x_t=1\mid R=0)\),则贝叶斯对数比为
忽略与候选无关的常数后,词项提供可加的对数证据。缺少相关性标注时,对 \(p_t,u_t\) 作近似并使用文档频率估计,会得到与逆文档频率相关的权重。真实词项并不独立,此模型是排序近似;BM25 的词频与长度处理还引入进一步建模,不能只用上述二元公式一步推出全部 BM25(Robertson 和 Zaragoza 2009)。
BM25 的饱和及长度归一化
最佳匹配评分(Best Matching 25,BM25)的一种常用形式为
其中逆文档频率(Inverse Document Frequency,IDF)取非负变体
本章用自然对数,并将查询重复词去重;其他实现可能保留查询词频因子、采用允许负值的 IDF 或按字段计算长度。公式版本必须固定,不能把不同实现的分数直接比较。
固定长度项 \(c_d=k_1(1-b+\frac{b|d|}{\bar\ell})>0\),令 \(g(f)=\frac{(k_1+1)f}{f+c_d}\),有
词频贡献递增但增益递减,且 \(f\to\infty\) 时趋于 \(k_1+1\)。在固定 \(f>0,b>0\) 时,长度增大提高分母,使分数下降;\(b=0\) 不作长度归一化,\(b=1\) 使用完整长度比例。它们校正篇幅带来的机会差异,却不意味着长文档内容必然不重要。
BM25 的数值解释
统计对象与评分对象一致,\(N>0,\bar\ell>0,k_1>0,0\le b\le1\)。长度使用同一分析器词项数,语料统计绑定一个索引快照。空对象不参与平均长度的异常除法,查询词项规则已固定。
双文档评分
设 \(N=100\),词项甲出现在 \(10\) 个对象,乙出现在 \(50\) 个对象。则 \(\operatorname{IDF}(\text{甲})=\log(1+\frac{90.5}{10.5})\approx2.2637\),\(\operatorname{IDF}(\text{乙})=\log2\approx0.6931\)。取 \(k_1=1.2,b=0.75,\bar\ell=100\)。
文档 A 长 \(100\),甲、乙词频为 \((2,1)\),长度项为 \(1.2\),两个词频因子为 \(\frac{4.4}{3.2}=1.375\) 和 \(\frac{2.2}{2.2}=1\),总分约为 \(2.2637\times1.375+0.6931=3.8057\)。文档 B 长 \(200\),词频为 \((3,2)\),长度项为 \(2.1\),因子为 \(\frac{6.6}{5.1}\approx1.2941\) 和 \(\frac{4.4}{4.1}\approx1.0732\),总分约为 \(3.6735\)。B 词频更高,却因更长而排名稍低。
此分数是排序量,不是“答案存在概率”。语料增量会改变 \(N,n_t,\bar\ell\);同一个固定阈值在不同快照或不同字段上可能失去原意义。阈值应在目标任务的开发集上校准,并与无答案情况一起评估。
12.3双编码器及对比学习
独立编码实现离线索引
稠密检索(Dense Retrieval)使用低维连续表示进行匹配。双编码器(Dual Encoder)分别计算查询向量 \(u=f_\theta(q)\in\Real^h\) 和文档向量 \(v_d=g_\phi(d)\in\Real^h\),以 \(s(q,d)=u^{\mathsf T}v_d\) 等方式评分。文档向量可以离线生成,在线仅编码查询并搜索;稠密段落检索是这一设计的典型研究实例(Karpukhin 等 2020)。
查询与文档编码器可以共享或不共享参数,还可能使用不同任务前缀。维度相同不保证空间兼容;两个独立版本的向量不能仅因为都是 \(h\) 维就混入同一个索引。归一化、池化、截断和编码模板均属于表示协议。
对比损失及梯度方向
给定查询 \(q_i\)、正例 \(d_i^+\) 和候选文档集合 \(\mathcal C_i\),对比学习(Contrastive Learning)可采用
令候选概率为 \(p_{ij}\)、正例指示为 \(y_{ij}\),则
梯度提高正例相对分数,并压低有较大当前概率的负例。温度改变概率集中度和梯度尺度,因此它不是无影响的显示参数。
例如三个候选的相似度除温度后为 \((\log4,\log2,0)\),第一项为正例,归一化概率与损失为
对这些缩放后分数的梯度为 \((-\frac{3}{7},\frac{2}{7},\frac{1}{7})\),当前更像正例的第二项获得更大负向学习压力。该算例只计算损失,不代表训练效果。
负例构造及假负例
批内负例(In-Batch Negative)把其他查询对应文档用作当前查询负例,减少额外编码。难负例(Hard Negative)由词法或现有稠密检索器找出分数高但确实不相关的文档,可以形成更有区分度的学习信号。随机负例通常较容易,过度依赖某一种难例又可能使模型只适应当前检索器的错误。
假负例(False Negative)是真实相关却被标成负例的对象。开放语料中一题往往有多个支持文档,批内文档也可能相互相关;强行推开这些向量会损害召回。可以依据已知相关集合屏蔽冲突、使用多正例损失或对疑似负例复核,但不能把“未标为正”自动理解为“确实不相关”。多正例求和形式还应明确是希望任一正例得高分,还是所有正例都被拉近。
训练与评估应按查询家族、文档版本和必要时间边界隔离。文档原文可以作为开放检索库存在,相关性标注却不能泄漏进查询编码或示例选择。相似文本的近重复治理见第18章《训练数据工程基础》。
12.4向量相似度及精确搜索
余弦、内积及欧氏距离
对非零向量 \(u,v\),余弦相似度(Cosine Similarity)为 \(\frac{u^{\mathsf T}v}{\|u\|_2\|v\|_2}\)。最大内积搜索(Maximum Inner Product Search,MIPS)寻找内积最大的向量;欧氏距离(Euclidean Distance)满足
当文档向量范数固定时,对固定查询最大内积与最小欧氏距离排名一致;若查询和文档均归一化为单位向量,则
此时三种排名等价。零向量不能作单位归一化,应隔离或采用明确规则。
未归一化时,范数会改变结果。令 \(u=(1,0)\),\(v_1=(0.8,0.6)\),\(v_2=(2,2)\)。余弦分别为 \(0.8\) 和 \(\frac{1}{\sqrt2}\approx0.7071\),余弦选择 \(v_1\);内积分别为 \(0.8\) 和 \(2\),MIPS 选择 \(v_2\)。若训练的打分利用范数信息,部署时擅自归一化就改变了目标函数。
精确排名基线
精确最近邻搜索(Exact Nearest Neighbor Search)对所有向量计算指定度量。\(N\) 个 \(h\) 维向量需要 \(O(Nh)\) 评分工作,存储原始单精度向量约 \(4Nh\) 字节,尚不含标识和元数据。矩阵批处理可利用高效硬件,但总扫描量仍随 \(N\) 增长。
精确搜索给出的是该表示和度量下的最近对象,并非相关性真值。可以将稠密系统误差分成表示误差与索引近似误差:若相关文档在精确前列也不存在,需要改进表示或语料;若精确搜索可以找到但近似索引遗漏,需要调整索引搜索。两者采用不同诊断证据。
12.5近似索引的两条路线
(选修)
HNSW 的分层图导航
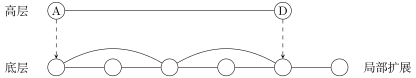
近似最近邻搜索(Approximate Nearest Neighbor Search,ANN)牺牲部分精确邻居召回,以降低搜索成本。分层可导航小世界图(Hierarchical Navigable Small World,HNSW)为向量构建多层邻近图,高层包含较少节点,底层覆盖全部节点(Malkov 和 Yashunin 2018)。查询从稀疏高层快速靠近目标区域,再向下扩展候选;底层保留比贪心单路径更多的搜索状态。
图构建时的邻居预算 \(M\)、构建搜索宽度与查询搜索宽度影响内存、构建时间和召回。更多边通常提高可导航性,也增加邻接表内存;更宽查询探索更多节点,增加距离计算。启发式邻居选择需要保持方向多样性,若只连接同一局部密簇,图可能难以跨区域导航。
不能对任意数据分布承诺严格对数查询复杂度;实际工作量由图结构、度量、数据簇和过滤条件决定。增量插入使图结构受构建顺序与随机层级影响,删除或大量墓碑也可能降低导航质量。对高选择性权限过滤,需要考虑合法节点的可达性,不能把过滤后的召回退化归咎于编码器。
倒排文件及乘积量化
倒排文件向量索引(Inverted File Index,IVF)先用粗聚类把向量分到若干单元,再将每个单元中的向量标识组织为列表。查询选择有限个最接近的粗中心,只扫描对应列表。它与词法倒排都使用“键到列表”的组织,但键的含义不同:前者是向量单元,后者是词项。
访问更多单元提高候选覆盖,也增加扫描量。若最近向量被分到未访问单元,后续精确重排无法挽回遗漏。粗聚类若在过时或偏移的数据上训练,单元可能失衡,一些查询扫描大量向量而另一些查询漏掉边界邻居。
乘积量化(Product Quantization,PQ)把 \(h\) 维向量拆成 \(m\) 个子向量,每个子空间训练一个含 \(k\) 个中心的码本,用 \(m\) 个码字索引表示向量(Jégou, Douze, 和 Schmid 2011)。若 \(k=256\),每个子码占一字节,向量码为 \(m\) 字节,码本及原始精排向量的额外存储另计。
非对称距离计算(Asymmetric Distance Computation,ADC)保留查询为高精度,文档用码字中心近似:
查询可先建立每个子空间的距离表,再对每条压缩向量查表求和。组合 IVF 与 PQ 时,还可对向量减去粗中心后的残差编码,查询距离必须计入同一个中心,不能把不同单元的残差当成同一原始坐标。
若 \(v=\widehat v+e\),反三角不等式给出 \(|\|u-v\|_2-\|u-\widehat v\|_2|\le\|e\|_2\)。平方距离误差满足
小距离间隔的候选更易因近似误差交换名次。IVF 的单元漏检与 PQ 的距离失真是两种误差;扩大扫描单元不能直接消除后者,精排压缩候选也不能恢复前者。
索引资源的比较
HNSW 主要增加图导航结构,IVF 限制访问区域,PQ 压缩表示及距离计算。它们不是互斥产品标签,也可以组合。选择时应比较同一表示、同一授权语料和相同精确搜索参照下的 ANN 召回、尾时延、内存、构建成本与更新行为,而非只比较一次查询的平均耗时。
12.6混合检索及学习排序
分数融合的尺度问题
混合检索(Hybrid Retrieval)结合词法和稠密候选。前者对精确术语、数字标识和罕见字符串有明确匹配依据,后者能够利用训练得到的语义关系;但两者均有失败场景。简单分数和 \(\lambda s_{\mathrm{lex}}+(1-\lambda)s_{\mathrm{dense}}\) 只有在尺度处理明确后才有意义。BM25 与余弦的数值范围和分布不同,逐查询最小最大归一化又受异常候选和截断深度影响。
倒数排名融合(Reciprocal Rank Fusion,RRF)直接使用排名(Cormack, Clarke, 和 Büttcher 2009):
未进入某路截断列表的文档在该路贡献为零。\(c\) 控制顶部名次差异的影响,\(w_j\) 为预先确定的路权重。RRF 不需要跨路原分数可比,却丢失了分数间隔信息;两路高度重复或错误高度相关时,不保证优于单路。
取词法排名 \((A,B,C)\)、向量排名 \((B,D,A)\),\(c=10,w_j=1\)。得到
融合顺序为 \(B,A,D,C\)。这里用 \(c=10\) 便于算例,不是通用最佳设置。相同文档的多个重复块若被当作独立对象,融合也不会自动识别其冗余,必须先明确对象身份与文档聚合规则。
重排及候选集上界
重排序(Reranking)在有限候选集上使用更精细的评分。交叉编码器(Cross Encoder)联合输入查询与文档,允许细粒度交互,代价是不能像双编码器那样为每篇文档独立预计算最终相关性。学习排序(Learning to Rank,LTR)可以组合词法分数、稠密分数、结构和其他合法特征。
例如已标注正负文档对可使用成对损失 \(\log(1+\exp[-(s^+-s^-)])\),推动正例高于负例。训练样本来自旧排序器时,需要注意曝光和位置偏差,点击也不等同于完全相关。无论重排器多强,若正确文档不在候选并集中,它都无法将其排到前列;应把召回深度与重排预算共同评价。
12.7权限、版本及增量更新
检索过滤约束
元数据过滤(Metadata Filtering)约束租户、文档类型、语言、生效时间与访问权限。一个授权查询的检索集合应是当前用户可访问的 \(\mathcal D_u\),不是全库评分后让生成器自行忽略秘密。查询时过滤、返回前再次授权检查和缓存隔离应共同保证撤销后的对象不被消费。
只取全库前 \(K\) 再删除无权结果,可能返回少于 \(K\) 条且漏掉合法相关对象。增加预取深度只能缓解,不提供严格召回保证。ANN 图导航还可能需要经过不符合过滤条件的节点,其标识与内容的内部使用边界应由可信检索服务定义;绝不能向调用方暴露未授权结果。高选择性过滤场景应单独测量授权集合上的召回与时延。
索引增量更新
每条索引对象应绑定稳定文档身份、源版本、片段边界、内容摘要、编码器版本、分析器和索引构建配置。文档编辑可能使后续切分边界整体变化,不能仅按旧片段序号覆盖而保留失效片段。编码器更新则通常要求重编码,并在完整新索引就绪后切换查询编码器与文档空间。
增量处理可记录变更日志,采用幂等写入和不可变版本。删除标记(Tombstone)可先阻止旧条目返回,后续通过物理压缩清理图节点、倒排条目、向量和存储。删除还需传播到片段缓存、检索缓存与派生索引;清理内容不等于自动消除所有统计或旧快照,需要分别规定保留边界。
索引快照(Index Snapshot)将语料版本、编码器、分析器、统计及物理索引绑定为一致消费单位。新版本采用原子可见切换,回滚时恢复匹配的查询配置。权限撤销属于即时约束时,不能因为回滚索引而重新授权已经撤销的内容。
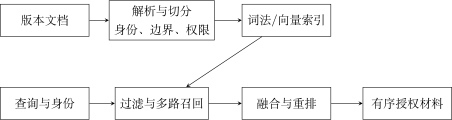
算法12.1 具有版本边界的混合检索
输入:查询、已认证身份、一致索引快照、候选深度与排序配置。输出:有序可访问对象及来源。状态:合法过滤条件、各路候选、融合结果。
解析访问条件与时间范围,选择匹配的分析器和查询编码器;拒绝不兼容版本。
在授权过滤语义下分别执行词法与向量检索,记录真实候选深度及超时状态。
按稳定对象身份合并候选,使用预定分数融合或 RRF,按预算重排并处理同文档冗余。
返回前再次核对当前授权与删除状态,输出实际材料身份、版本、排序分数和诊断状态;资源预算耗尽时按预定规则结束。
不变量:返回内容经过授权,表示与索引版本一致,召回失败或回退不被伪装为正常完整结果。
12.8检索评价指标
覆盖、首条命中及分级排序
召回率(Recall)衡量相关集合被覆盖的比例:
命中率(Hit Rate,Hit@K)则是 \(\mathbf1[G_q\cap R_q^{(K)}\ne\varnothing]\)。存在三篇相关文档、只取回一篇时,前者为 \(\frac{1}{3}\),后者为 \(1\);二者不能混称。没有相关对象的查询分母为零,应单独评价无答案检出或拒绝,而不是擅自记为满分。
平均倒数排名(Mean Reciprocal Rank,MRR)关注第一条相关结果。若其位置为 \(j_q\),单查询倒数排名为 \(\frac{1}{j_q}\),未在规定截断内命中则为零,再对查询平均。它不奖励第一条之后更多相关材料,因此与多证据任务的覆盖目标不同。
折损累计增益(Discounted Cumulative Gain,DCG)按等级与位置计算价值,归一化折损累计增益(Normalized Discounted Cumulative Gain,nDCG)用理想排序归一化。累积增益评价的基础见 Järvelin 与 Kekäläinen(Järvelin 和 Kekäläinen 2002)。本章明确采用一种常见变体:
理想分母由该查询全部已知相关对象按等级排序取前 \(K\) 得到,不能只重排系统已返回对象。若分母为零,应规定无增益查询的独立口径。1
同一结果的三种指标
某查询已知相关对象为 \(A,B,C\),等级分别为 \(3,2,1\),其余对象等级为零。系统前五名为 \((D,B,E,A,F)\),前四名相关等级为 \((0,2,0,3)\)。因此
DCG 为 \(\frac{3}{\log_2 3}+\frac{7}{\log_2 5}\approx1.8928+3.0147=4.9075\)。理想等级为 \((3,2,1,0)\),IDCG 为 \(7+\frac{3}{\log_2 3}+\frac{1}{\log_2 4}\approx9.3928\),所以 nDCG@4 约为 \(0.5225\)。相关对象 A 虽然已召回,却位于第四位,折损反映其排名损失。
若第二个可回答查询的第一条相关结果在第三位,则两查询 MRR@4 为 \(\frac{\frac{1}{2}+\frac{1}{3}}{2}=\frac{5}{12}\approx0.4167\)。另有无答案查询时,应单列是否错误返回被当作证据的材料,而不混入上述需要相关集合的分母。这些是构造标注上的完整计算,不代表实际系统质量。
ANN 召回及相关性召回分开
给定精确向量前 \(K\) 集合 \(E_q^{(K)}\),可定义 ANN 召回为 \(\frac{|E_q^{(K)}\cap A_q^{(K)}|}{K}\),用于衡量近似索引对向量排名的保持。它与基于 \(G_q\) 的任务召回不同。一个索引可以完美复现不相关的向量排名,也可以因为近似扰动偶然取得更高任务分数;不能据此认为其表示一定更好。
标注不完整时,未标注文档不一定不相关,召回分母与 nDCG 理想排序均只反映当前已知集合。应保存标注来源,进行多路候选池复核,并按精确实体、语义改写、跨语言、长文档、时效、权限过滤和无答案查询等难例切片报告。宏平均让每个查询等权,按相关对象数加权则回答不同问题。
检索故障的定位顺序
先确认解析与权限范围,再检查相关材料是否进入精确候选,随后检查近似索引与融合是否遗漏,最后检查重排是否把有效材料移出前列。召回、排名与下游答案质量承担不同职责,不能用某一个总分代替全部链路证据。
DCG 有线性与指数增益、不同折损位置等约定。比较报告前必须固定公式、相关等级含义和无相关查询处理,不能仅凭相同指标名称认定可比。↩︎