自回归生成每次只增加少量词元,但新的词元需要读取已经形成的上下文。如果每一步重新执行整个前缀,模型会反复计算相同的位置表示。键值缓存利用因果结构保留这些中间结果,把后续计算集中于新增位置;与此同时,缓存随序列增长,成为并发、显存与状态一致性的核心约束。
本章先证明缓存复用的数学条件,再讨论不同注意力结构的容量、分页寻址和前缀共享。第6章《Transformer 网络结构》定义网络层,第37章《长上下文建模》讨论长距离能力。本章侧重执行状态;算子优化和投机生成由第33章《推理计算优化》展开,服务调度由第31章《批处理调度》展开。
30.1预填充及增量解码
两个阶段的输入输出
预填充(Prefill)对已知提示的全部位置执行因果前向,形成各层键和值。增量解码(Incremental Decoding)随后只处理新加入的词元,通过历史缓存读取前缀信息。它改变执行方式,不改变自回归概率分解。
提示包含 \(P\) 个词元,编号 \(0,\ldots,P-1\)。预填充最后位置的输出分布预测第一个生成词元 \(y_0\);采样出 \(y_0\) 后,才把它送入位置 \(P\) 的增量前向,得到预测 \(y_1\) 的分布。因而输出 \(G\) 个词元通常需要一次预填充与 \(G-1\) 次后续单词元前向,而不必为最后一个输出再执行一次模型。1
张量形状
设批次大小 \(B\),隐藏维数 \(d\),层数 \(N\),查询头数 \(h_q\),键值头数 \(h_{kv}\),键维数 \(d_k\),值维数 \(d_v\)。预填充一层有
若已经缓存 \(L\) 个词元,新加入 \(q\) 个词元,则 \(Q_{\mathrm{new}}\) 的序列轴为 \(q\),\(K,V\) 的可读取序列轴为 \(L+q\)。单词元解码时 \(q=1\),每个查询头的注意力分数形状为 \([B,1,L+1]\)。实际运行时可采用不同轴顺序或打包布局,逻辑维度不变。
设 \(g(i)\) 将查询头 \(i\) 映射到其键值头,新增位置 \(r\in\{0,\ldots,q-1\}\) 的注意力为
\(b\) 表示合法的位置偏置,旋转位置编码则通常已经作用于查询与键。新块内部仍需因果约束 \(j\le L+r\),不能因为使用缓存而让较早新词元读取较晚新词元。
符号及一致性假设
| 符号 | 含义 |
|---|---|
| \(P,G,L,q\) | 提示长度、输出词元数、已缓存长度、新增位置数。 |
| \(N,d,h_q,h_{kv},d_k,d_v\) | 网络层数、隐藏维数及注意力维度。 |
| \(b_k,b_v\) | 单个键或值元素占用的字节数。 |
| \(\mathcal C^{(\ell)}\) | 第 \(\ell\) 层的键值缓存及其位置元数据。 |
| \(p_b,\mathcal B\) | 每个物理块容纳的词元数与逻辑块到物理块的映射。 |
| \(r_c,d_C,d_R\) | 潜变量缓存维数、内容查询/键维数与解耦位置分量维数。 |
缓存等价的条件
模型参数、适配器、位置规则和可见性规则固定;网络处于推理模式,旧位置的计算不依赖未来词元。层归一化和前馈变换按位置进行,不以不断扩展的整段序列重新计算全局统计。缓存没有被有损修改,并保留与参考全量前向一致的逻辑位置和输入条件。
30.2键值缓存等价性
层级因果性证明
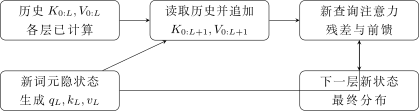
键值缓存(Key-Value Cache,KV Cache)保存各层历史位置的 \(K,V\)。设在长度 \(L\) 的前向中,第 \(\ell\) 层历史位置 \(j<L\) 的隐状态为 \(h_j^{(\ell,L)}\)。现在追加词元扩展为 \(L+q\),需要证明
第一层之前,旧词元及位置编号相同,嵌入相同。假设某层输入的历史状态相同,则其历史 \(Q,K,V\) 相同;因果掩码保证旧位置 \(j\) 只读取 \(0,\ldots,j\),新增位置不进入求和。于是注意力输出相同,逐位置残差、归一化和前馈结果也相同。对层数归纳,式(30.3)成立。
计算新增位置时,使用缓存的历史键值与重新计算整个前缀所得到的历史键值相同,新位置本身按同一公式计算,故新增隐状态与输出分布也相同。这是缓存等价的依据,不是因为历史文本“通常不变”而作出的近似。
历史查询通常不必保存,因为以后只需要新位置发出的查询;历史键和值仍将被后续查询读取。跨层不能只保存最后一层缓存:第 \(\ell\) 层新查询需要第 \(\ell\) 层的历史键值,其表示与其他层不同。
等价性条件
双向编码器旧位置会读取新增文本,通常不能直接沿用这套追加证明。对编码器—解码器模型,如果编码器输出固定,则交叉注意力的编码器键值可以预先计算;若源文本改变,则这些缓存失效。
推理时仍启用随机丢弃、随长度改变位置缩放、修改适配器或依赖全序列统计的操作,都会破坏旧状态不变的前提。量化缓存、选择性淘汰或近似压缩也会引入额外误差,应作为不同执行模式说明。
数学等价不要求不同内核逐位相同。浮点求和顺序、精度与归约布局可能带来误差;输出概率接近时,贪心最大值也可能发生离散分叉。验证应先比较同一输入下的分数或概率,再区分数值误差与掩码、位置错误,不能只凭生成文本相同或不同判断缓存正确性。
例24.1
考虑单层单头、\(d_k=1,d_v=2\) 的构造。前两个位置的缓存为
第三个新位置的查询 \(q_2=1\),新键 \(k_2=\log3\),新值 \(v_2=(3,3)\)。无位置偏置时,分数为 \(0,\log2,\log3\),指数为 \(1,2,3\),归一化权重为 \(\frac{1}{6},\frac{2}{6},\frac{3}{6}\)。所以
全量前向会为第三行生成完全相同的分数;缓存前向复用前两行键值即可。它不需要重新计算前两行注意力输出。若错误漏掉新键值,得到 \((\frac{1}{3},\frac{4}{3})\),这不是数值精度差异,而是可见集合改变。
30.3复杂度及带宽
重复前缀及缓存执行
忽略层数等固定系数,以密集网络常见维度关系计,长度 \(L\) 的全量前向约为 \(O(Ld^2+L^2d)\)。如果生成每个词元都重算整个前缀,\(G\) 次预测消耗约
使用缓存后,预填充一次,后续 \(G-1\) 次单词元前向各为 \(O(d^2+(P+g)d)\),总量为
因此无初始长提示时,朴素重复前缀的注意力累计量可达三次方,而缓存把它降到二次方;单步解码的密集注意力仍随上下文线性增长,不能称为常数时间。
例如提示4个词元、输出3个词元。全量方案分别处理长度4、5、6,累计线性变换位置15个;缓存方案处理4个提示与2个新增位置,共6个。按因果合法分数对计,前者为 \(10+15+21=46\),后者为 \(10+5+6=21\)。这是运算对象计数,不是端到端时间加速比。
缓存容量及计算量
单步解码需要读取历史键值。若主要限制是显存带宽,减少缓存元素有助于降低读取成本;但查询头数不变时,注意力分数与输出仍按查询头计算。预填充可以对许多查询并行执行,单词元解码更容易受参数与缓存读取影响,二者不能共用一个固定吞吐常数。
缓存只避免重算,不会消除新词元的网络层计算,也不会消除全上下文注意力读取。实际耗时还取决于批次、内核复用、页布局、并行通信和工作区;第33章《推理计算优化》讨论算子,第31章《批处理调度》讨论调度。本章容量式不替代实际负载下的延迟分析。
30.4MHA、GQA 及 MQA 的缓存
头共享结构
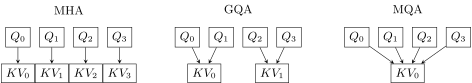
多头注意力(Multi-Head Attention,MHA)为每个查询头提供独立键值头,\(h_{kv}=h_q\)。多查询注意力(Multi-Query Attention,MQA)让所有查询头共享一个键值头,\(h_{kv}=1\)(Shazeer 2019)。分组查询注意力(Grouped-Query Attention,GQA)在两者之间按组共享键值(Ainslie 等 2023)。
若 \(h_q\) 能被 \(h_{kv}\) 整除,每组有 \(\frac{h_q}{h_{kv}}\) 个查询头。共享键值并不意味着查询头输出相同,因为各查询向量仍不同,从而产生不同注意力权重。这些是不同参数化结构;不能把已有 MHA 键值头直接丢弃后声称数学等价。转换需要与模型训练方式及质量评估结合。
统一容量公式
若请求 \(b\) 缓存长度为 \(L_b\),各层同形状,则裸缓存容量为
当 \(d_k=d_v=d_h,b_k=b_v=b_e\)、所有请求长度 \(L\) 相同时,退化为 \(2NBLh_{kv}d_hb_e\)。它不包含页表、分配碎片、量化比例、临时空间和模型权重。分层采用滑窗或不同头数时,应分别求和。
取 \(N=32,h_q=32,d_h=128,b_e=2,L=8192,B=1\)。每词元 MHA 缓存为 \(2\times32\times32\times128\times2=524288\) 字节,即512 KiB。GQA 取8个键值头,每词元128 KiB;MQA 每词元16 KiB。于是
| 结构 | 键值头数 | 单请求裸缓存 | 四请求裸缓存 |
|---|---|---|---|
| MHA | 32 | 4 GiB | 16 GiB |
| GQA | 8 | 1 GiB | 4 GiB |
| MQA | 1 | 128 MiB | 512 MiB |
这里 GiB 为 \(2^{30}\) 字节。相同比例描述缓存容量,不代表模型总显存或吞吐按同样比例变化。
张量并行下,若键值头均匀分片,每卡缓存可相应减少;若键值头少于并行设备数而运行时复制,则不能直接除以并行度。例如 MQA 的一个头可能在多个设备上分别驻留。容量规划需使用实际每卡存储头数,并与模型及内核布局一致。
30.5低秩键值及潜变量缓存
(选修)
联合表示及矩阵吸收
键值头共享减少独立头数,另一种思路是让键和值由低维共同变量生成。对单位置列向量 \(h_t\in\mathbb R^d\),设
其中 \(U_{K,i}\in\mathbb R^{d_k\times r_c}\),\(U_{V,i}\in\mathbb R^{d_v\times r_c}\)。不含位置旋转时
可以先把当前查询投到潜空间,再与缓存 \(c_j\) 点积,不必为每个历史位置展开完整键。输出也有
若第 \(i\) 头输出投影块为 \(O_i\),可进一步合并 \(O_iU_{V,i}\)。这种矩阵吸收(Matrix Absorption)利用线性结合与矩阵乘法结合律,改变计算顺序而保留所定义低秩结构的数学结果。
低秩约束本身不等于任意原始 MHA 的无损压缩。模型若按该结构训练,可以精确执行自身的潜变量形式;若对已有高秩权重作事后低秩近似,则还需分析近似误差。缓存变小也可能增加某些潜空间计算,必须结合维度与执行阶段权衡。
位置旋转的非交换约束
若对完整键加入旋转 \(R_j\),查询也按位置 \(t\) 旋转,则点积为
中间旋转依赖历史位置 \(j\),一般不能用一个与 \(j\) 无关的固定矩阵吸收到当前查询投影中。矩阵通常不交换次序;忽略这一点会把缓存压缩推导变成错误等式。
多头潜在注意力(Multi-Head Latent Attention,MLA)在 DeepSeek-V2 中采用联合键值压缩与解耦位置分量(DeepSeek-AI 2024)。概念上可把分数写为内容项和位置项之和:
内容项采用矩阵吸收,旋转位置项单独保留。分母与该结构的查询、键总维度和训练尺度一致,不能任意换成潜变量维数。这里只给出缓存相关关系,具体查询压缩与模型规格应遵循对应架构。
若每层每位置保存一个 \(r_c\) 维潜变量和一个共享 \(d_R\) 维位置键,统一元素字节数 \(b_e\) 时,裸容量为
例如取 \(r_c=512,d_R=64,N=32,b_e=2,L=8192\),得到288 MiB。该构造不能直接与不同模型的性能比较;这里只说明缓存由哪些维度决定。
30.6逻辑位置及物理分页
页表不改变注意力位置
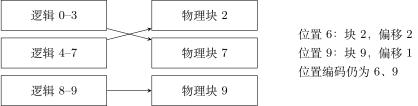
分页键值缓存(Paged KV Cache)把序列的连续逻辑位置映射到可不连续的物理块。PagedAttention 将此思路用于模型服务中的缓存管理(Kwon 等 2023)。若每块容纳 \(p_b\) 个词元,逻辑位置 \(t\) 对应
\(j\) 为逻辑块编号,\(o\) 为块内偏移,\(\mathcal B\) 是请求页表。位置编码仍使用逻辑位置 \(t\),不能使用物理块编号。搬迁一个块只需更新映射与数据位置,不应重新解释序列顺序。
设块大小4、逻辑长度10,页表为 \((7,2,9)\)。位置6映射到物理块2的偏移2,位置9映射到物理块9的偏移1。三个物理块共有12个槽位,最后两位无效,注意力必须根据逻辑长度排除它们。
碎片及容量预留
没有共享时,请求长度 \(L_b\) 需要 \(\lceil \frac{L_b}{p_b}\rceil\) 个块,分配槽位与有效长度之差小于 \(p_b\)。对 \(B\) 条请求,尾部内部碎片少于 \(Bp_b\) 个词元槽位。块太大增加尾部浪费,块太小增加页表和寻址开销,选择应结合内核与长度分布。
缓存按需增长减少一次预留最大输出长度的浪费,但不能消除后续增长风险。接纳请求时应考虑未来输出预算及可用块;正在执行的内核读取旧映射期间,块不能被提前回收。页表修改、数据拷贝与设备执行之间需要明确顺序和完成边界。
批内变长
对长度分别为 \(L_1,\ldots,L_B\) 的请求,每个新查询仅能读取自身有效前缀。连续批次中的行号只是当前执行槽位,不能代替稳定请求身份。请求完成后压缩批次、交换行或加入新请求时,缓存映射必须跟随请求,而不能默认沿用原行对应的物理块。
填充到批内最大长度的实现与分页变长实现可以表达同一逻辑计算;前者需要屏蔽无效位置,后者需要正确页表与长度。它们的缓存分配量和算子效率不同,但语义不应改变。
30.7前缀共享及缓存生命周期
计算前缀共享
前缀缓存(Prefix Cache)复用多个请求相同前缀产生的键值。因为旧状态只依赖前面的内容,相同模型、相同逻辑位置与相同条件下的精确词元前缀可以共享。相同的一段后缀若前文不同,深层键值通常不同,不能仅按局部文本重复复用。
共享通常从完整块边界开始。前缀块的身份应绑定前一块身份与本块词元内容,使同一局部块出现在不同前缀后时不被误判为相同计算状态。内容摘要是索引手段,仍需要足够可靠的身份方案与兼容性元数据。
完整命中提示缓存时,若仅保存 \(K,V\),可能没有可直接产生首个新词元的最后隐状态或输出分数。实现可以保留相应输出状态,或重新处理最后一个提示位置并精确控制缓存截断与追加。不能将最后词元再追加一次而造成重复位置,也不能把“所有 KV 已存在”误解为“首词元分布必然已保存”。
引用计数及写时复制
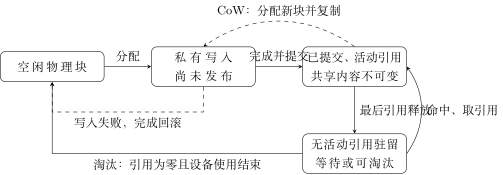
共享块在被多个请求引用时应保持不可变。引用计数(Reference Counting)记录有多少活动使用者持有该物理块;释放一个请求只减少其引用,计数归零后才具备回收条件。若块仍被设备内核读取,还需等待相关执行完成。
当多个分支共享未满块又要追加不同词元时,需要写时复制(Copy-on-Write,CoW):为修改分支分配新块,复制有效前缀,再追加。否则一个请求会覆盖另一个请求的缓存。已满共享块无需复制,后续分支直接分配各自的新块即可。
例如每块4个词元,三条请求共享8个前缀词元,各自拥有3个后续词元。独立存储需要 \(3\times\lceil\frac{11}{4}\rceil=9\) 块;共享后需要2个公共块加3个私有尾块,共5块。有效独特缓存词元为 \(8+3\times3=17\),分配20槽位;节省的是重复前缀,并未减少私有后缀的计算内容。
缓存驻留及淘汰
活动请求使用的缓存不能因“最近没访问”就直接删除。缓存淘汰(Cache Eviction)通常针对没有活动引用但为未来复用保留的块;若要抢占活动请求,应保存可恢复映射并换出,或释放后按同一输入重新计算。前者消耗传输,后者消耗计算,两者的语义与普通缓存命中不同。
缓存可经历空闲、分配写入、可共享驻留、活动引用、无引用可淘汰、回收等状态。取消与超时也必须走释放路径,并以请求资源所有权防止重复递减。前缀复用率高但长期占满显存时,驻留策略会挤压活动解码;如何在任务之间分配资源由调度章节展开。
算法30.1 前缀缓存的引用与追加
输入为计算身份、词元前缀、请求身份及所需新增容量;输出为请求页表和可继续执行的私有尾部。
在允许共享的命名空间内查找最长兼容完整前缀,逐块验证计算身份与有效范围,取得引用后固定映射。
为未命中部分分配块,执行预填充并提交有效长度;只有计算完成的内容可发布为可共享状态。
每次追加前判断尾块是否有空位及是否被共享;共享且需要修改时先复制有效内容到私有块。
写入各层新键值,在成功完成后推进逻辑长度;失败时回滚未提交分配,不发布部分完成状态。
请求终止后按所有权恰好释放一次引用;待无引用且设备使用结束后,块可保留驻留或由淘汰策略回收。
不变量是任何活动页表只能指向兼容且已完成的有效数据,共享块不被原地覆盖,逻辑长度只描述已提交状态。
30.8滑窗、淘汰及位置编码约束
历史状态淘汰条件
模型若原本采用包含当前位置的窗口 \(w\),未来查询只读取最近 \(w\) 个键值,则窗口之外的历史键值不再作为该层的直接输入,可在保持必要元数据的条件下回收。删除全注意力模型的旧键值,则改变式(30.2)的求和集合,是近似策略而非精确缓存管理。
滑窗模型的高层新状态可能包含通过中间位置传递的更早信息。缓存中仅保留最近键值,不等于从原始文本只取最近 \(w\) 个词元重新运行整网:后者可能失去这些键值形成时曾使用的上下文。精确性应相对于相同逐步滑窗计算定义。
混合全局层与滑窗层时,缓存保留范围按层不同。用于前缀匹配的累计逻辑长度也不等于当前驻留位置数,应同时保存历史进度和各层可见范围。
环形存储的逻辑位置
环形缓存(Ring Buffer)用位置 \(t\bmod w\) 复用物理槽位。槽位编号是存储坐标,位置编码仍应使用模型定义的逻辑位置 \(t\)。把槽位0当成绝对位置0,会改变旋转相位或绝对嵌入。
如果缓存保存已经旋转的键,移动物理块不需要重新旋转;若改变逻辑位置,情况不同。纯相对旋转在特定条件下可以通过一致变换分析重定位,但普通网络还包含深层上下文状态,不能只改键相位就宣称任意裁剪与拼接等价。
长度扩展方案若根据当前长度动态修改旋转频率,旧键以及形成旧键的深层状态可能不再对应新规则。最稳妥的缓存复用前提是一次请求内固定位置配置;需要动态改变时应明确重建范围,而不能仅更新配置数字。
30.9缓存身份及隔离
缓存失效依赖
缓存是给定计算条件的中间结果。其身份至少应覆盖权重及结构修订、适配器组合、精度与缓存格式、位置配置、注意力规则、精确前缀和外部条件。对多模态或交叉注意力模型,还需绑定媒体特征、处理器和编码器状态;同样文本标记不保证图像条件相同。
分词器与模板决定如何得到词元前缀,适合在制品身份中统一绑定。温度与采样阈值若仅作用于输出分布而不改变前向,本身不改变已有前缀 KV;但它们影响后续采样结果及恢复随机轨迹,因此仍属于请求生成状态。区分这两类依赖可以避免缓存键过宽或过窄。
模型名称、可变分支名和目录路径不是充分身份。更新模型而继续使用旧缓存会得到混合版本计算;同一个请求在解码中切换修订也不具有普通续算语义。无损搬迁到相同制品通常只改变位置,跨不同缓存布局则需要明确定义格式转换。
多租户共享边界
缓存包含由用户内容计算出的状态,应受请求或授权共享域控制。即使两个租户碰巧拥有相同词元前缀,也不意味着系统已获准共享其私有计算状态。命名空间、前缀来源和授权域应进入查找边界;公共固定前缀可以在明确规则下共享,私有内容不应被摘要命中自动扩大访问范围。
引用计数只保证内存生命周期,不提供权限隔离。缓存命中造成的时间差、日志或错误信息也可能泄露前缀存在性,应避免向无权请求暴露可查询的私有前缀信息。物理块重新分配后,旧内容必须在访问与有效长度上不可见,不能依赖“下次大概会覆盖”。
缓存正确性的三个层次
数学层保证保存的状态等价于相同前缀计算;存储层保证页表、有效长度与生命周期一致;隔离层保证只有授权请求能够复用状态。三者缺一不可,较高命中率不能替代任何一层的正确性。
30.10增量执行过程
算法30.2 带缓存的自回归生成
输入为非空提示、冻结模型、生成上限 \(G>0\)、停止规则与空或兼容前缀缓存;输出为最多 \(G\) 个词元及最终缓存进度。
确定提示词元、逻辑位置和缓存身份,复用合法前缀并处理未缓存部分,取得提示末位置的输出分布。
根据生成策略选择下一个词元并记录输出;若达到结束条件或输出上限,终止生成。
为该新词元分配可写位置,按层计算新查询、键和值,查询所有合法历史位置并完成残差与前馈;提交缓存及逻辑长度。
从最终层取得下一词元分布,返回步骤2;批内其他请求使用各自页表、长度及终止状态。
正常结束、取消或失败时释放请求持有的资源;若保留续聊状态,明确缓存是否已经覆盖最后输出词元。
每次循环至多增加一个已输出词元,缓存只覆盖已经执行前向的位置;不把“已采样”误认为“已写入各层 KV”。
时间指标也应遵循阶段语义。首词元延迟从约定入口到首个可见输出,通常包含排队与预填充;后续词元间隔描述增量阶段及其排队、传输影响。若 TTFT 已含排队,端到端时间写为 \(\mathrm{TTFT}+(G-1)\mathrm{TPOT}\),不能重复加排队。缓存命中减少某些预填充计算,但不保证所有请求的首词元延迟同比下降。
30.11缓存计量及服务边界
缓存增长、头共享和容量计数描述状态存储的成本;内核分块、编译与并行效率在后续章节展开。请求身份、模型修订、取消和资源释放决定缓存生命周期与隔离边界。容量算例用于推导字节数,不能称为实测显存或吞吐。
若服务需要把完整最终回答状态留下用于续聊,可能额外处理最后输出词元。请求返回了多少词元与缓存实际覆盖到哪个位置应分别记录。↩︎