理解一段已给定文本时,当前位置的意义往往同时依赖左右两侧。例如,“苹果发布了新产品”与“苹果已经成熟”中的同一词语,需要后文帮助消除歧义。自回归模型为了生成必须限制未来信息,理解任务却可以利用完整观测。本章讨论如何在保留双向可见性的同时,构造有意义的自监督目标,以及如何把得到的上下文表示用于分类和抽取。
基于 Transformer 的双向编码表示(Bidirectional Encoder Representations from Transformers,BERT)以双向编码器作为共享主干,并在预训练与下游任务中配置不同输出头(Devlin 等 2019)。它的代表性贡献是训练目标与表示结构的配合,而不只是某个特殊分类词元。本章先说明输入和信息流,再推导损坏输入上的恢复目标,最后讨论任务适配与评估边界。
假设与适用范围
输入是已知的有限词元序列,普通文本与控制词元的编号固定。填充位置不作为有效键,不参与目标统计。损坏输入由明确的随机通道产生,监督标签来自损坏前的原序列。以下 BERT 配方描述原始设计;不将其视为所有双向编码模型的统一常数。
35.1双向编码输入
三类嵌入及其不同职责
对于句对 \(A,B\),经典输入组织为
词元编码与特殊符号的规则见第4章《文本表示》。设批量大小为 \(B_0\),填充后长度为 \(T\),隐藏宽度为 \(d\)。使用 \(B_0\) 区别于句对中的第二个句段 \(B\)。三类编号分别选择词元、位置和句段嵌入:
其中 \(E\in\Real^{V\times d}\) 为词元嵌入,\(P\in\Real^{T_{\mathrm{pos}}\times d}\) 为可学习绝对位置表,\(S\in\Real^{2\times d}\) 为经典句对的句段表。所有加数均为 \(d\) 维向量。位置上限约束实际使用的位置编号;仅把调用参数中的最大长度改大,并不会自动产生训练过的新位置向量。
词元编号说明“出现了什么”,位置编号说明“位于何处”,句段编号说明“属于哪一段”。句段编号不是自然语言句子数量的计数器,也不等于注意力隔离边界。句对中的 \(A\)、\(B\) 虽具有不同句段编号,仍可通过双向自注意力互相读取。若任务要求隔离两个片段,需要另行定义注意力允许关系。
| 符号 | 含义 | 形状或范围 |
|---|---|---|
| \(x,\widetilde x\) | 原词元及损坏后的输入编号 | \(B_0\times T\) |
| \(m_{bt}\) | 输入有效性标记 | \(\{0,1\}\) |
| \(\mathcal M_b\) | 第 \(b\) 条序列被选中监督的位置集 | 有效非控制位置的子集 |
| \(H^{(\ell)}\) | 第 \(\ell\) 层上下文表示 | \(B_0\times T\times d\) |
| \(U,q\) | MLM 词表分数及概率 | \(B_0\times T\times V\) |
| \(r_b\) | 句对是否连续的二元目标 | \(\{0,1\}\) |
| \(C\) | 下游类别数 | 正整数 |
双向可见性及编码层
对于一个有效查询位置 \(i\),双向注意力允许读取所有有效键 \(j\)。定义加性掩码
它没有 \(j\le i\) 的约束。用第35章《注意力机制》中的缩放点积注意力计算后,原始 BERT 的编码层采用注意力和前馈网络两条 Post-LN 残差子层:
前馈网络使用 GELU,原始配置中隐藏层通常扩展为 \(4d\)。这与原始 Transformer 的 ReLU 配置、以及许多自回归模型的 Pre-LN 配置应分别陈述;各结构的归一化和梯度机制见第6章《Transformer 网络结构》。
多层双向传播使每个有效位置都可聚合整段观测。填充查询行虽然可能得到一个非零输出,但它不应进入任务损失或池化统计。是否把该行输出清零属于实现约定;如果将其所有键都屏蔽,则必须单独处理全屏蔽行的归一化,不能对全为负无穷的行直接求 Softmax。
掩码机制对照
为隔离可见性的作用,固定同一查询行的原始分数为 \((0,\log2,\log3)\),三个键都有效。位于第2个位置的查询在双向情形下得到
因果情形屏蔽第3个键,并对剩余两项重新归一化,得到
若值向量在此简化为标量 \((1,4,10)\),两种输出分别为 \(6.5\) 和 \(3\)。区别不仅在于未来项变为零,原来可见项的权重也因分母变化而改变。若第3个位置实际上是填充,则双向模型同样得到 \((\frac{1}{3},\frac{2}{3},0)\),说明“右侧”与“有效”是两个不同判断。
这个例题没有改变参数,不依赖训练,因而能把差异归因于掩码;它不证明双向模型的任务质量更高,也不把注意力权重直接解释为因果重要性。
35.2损坏通道及掩码语言建模
掩码重建目标
如果一个双向编码器在每个位置读取原词元,又以原词元作为同位置监督,模型可能依赖输入查表形成近似恒等映射,而不必学习上下文。掩码语言建模(Masked Language Modeling,MLM)通过改变输入的一部分,再要求恢复原词元,降低这一捷径的作用。
设原序列为 \(x\),先从允许的位置中抽取监督集合 \(\mathcal M\),再用随机损坏通道 \(c(\widetilde x\mid x,\mathcal M)\) 产生观察输入。目标写为
模型读到的是 \(\widetilde x\),标签仍是 \(x_t\)。它一般不是只读取“删除 \(\mathcal M\) 后的文本”:被选中位置可能被替换为随机词元,也可能保留原值。显式写出损坏通道才能准确描述训练分布。
经典损坏配方及概率含义
原始 BERT 从可候选位置中选择约 \(15\%\) 作为预测位置;条件于一个位置已被选中,约 \(80\%\) 替换为 MASK,\(10\%\) 随机替换,\(10\%\) 保留原词元(Devlin 等 2019)。按这些理想概率计算,全部候选位置中约 \(12\%\) 进入 MASK 分支,\(1.5\%\) 进入随机替换分支,\(1.5\%\) 进入保留分支。
监督集合与 MASK 出现位置并不相同。只对输入中实际等于 MASK 的位置计算损失,会漏掉随机替换和保留分支。随机替换也可能恰好抽到原词元;上述 \(1.5\%\) 是进入该分支的比例,不是保证实际改变内容的比例。1
保留与随机替换使模型不能仅靠输入是否为 MASK 判断一个位置是否参与目标,也减轻了预训练时总在特殊符号处预测而下游输入没有 MASK 的不一致。它们并不完全消除复制捷径:保留分支确实提供原值,训练目标只是让多种损坏条件共同贡献梯度。
候选位置的抽取方式还需说明。逐位置伯努利抽样在短序列上可能产生空集合;固定个数抽样则引入位置之间的依赖。整词遮盖或连续片段遮盖改变条件信息和任务难度,不能认为它们只改变了数据读取速度。
动态损坏及评估口径
每次访问文本重新抽取损坏,会让同一原文在不同轮次产生不同条件;预先固化损坏则形成有限的训练样例集合。两种做法在有限预算下的监督覆盖不同。验证时可固定原文、位置和替换结果,以比较参数变化;也可在多次独立损坏上求平均,但需报告抽样方式和不确定性。
对批量监督位置总数 \(N_M=\sum_b|\mathcal M_b|>0\),按词元加权的损失是
这不总等于式(35.8)中先对每条序列求均值再平均的经验版本。序列被选中位置数不同时,两种归一化赋予文本不同权重。只有明确目标后,才能判断梯度累积和分布式归约的分母是否正确。
算法35.1 构造一个 MLM 训练批次
输入:原序列、有效性标记、控制词元位置、损坏规则、随机状态。输出:损坏输入、原值标签、监督集合及有效监督数。
从有效且允许监督的位置构造候选集合;禁止用填充编号的相等比较替代位置来源判断。
按给定抽样方式选取 \(\mathcal M_b\),复制原输入得到 \(\widetilde x_b\);先保存每个选中位置的原词元标签。
对每个选中位置抽取分支:替换 MASK、从规定集合随机替换,或保留原值。标签在三种情况下均不改变。
构造只读取有效键的双向掩码,并统计 \(N_M\)。若 \(N_M=0\),按预定策略重新采样或跳过批次,不除以零。
编码损坏输入,计算选中位置的词表损失,按式(35.9)归一化;反向完成后更新参数。
不变量:监督标签来自损坏前的文本;参与监督的位置由集合决定,而非由损坏后的词元值决定。构造过程线性扫描批量位置,编码器计算成本另计。
35.3词元预测损失
词表分布映射
设共享主干输出为 \(H\in\Real^{B_0\times T\times d}\)。MLM 头先对每个位置施加非线性变换,再映射到词表:
\(W_h\in\Real^{d\times d}\),\(b_h\in\Real^d\),\(b_V\in\Real^V\);输入词元表 \(E\) 同时作为输出投影权重。共享不省去全词表分类计算,但减少独立参数,并使查表路径与预测路径的梯度相加。其一般机制见第4章《文本表示》。
训练只需要选中位置的分数时,可先从 \(H\) 收集 \(N_M\) 行再执行输出头,将输出张量从 \(B_0T\times V\) 缩小为 \(N_M\times V\)。由于这里的变换逐位置独立,这不改变选中位置的数学结果;主干仍必须编码完整损坏上下文,不能只保留待预测的几个词元。
考虑三条序列各贡献一个监督位置:第一处进入 MASK 分支,第二处随机替换,第三处保留原值。为便于核对,假设目标词表仅有三类,原标签依次为第1、2、3类,预测分布为
三个位置全部计入损失,因此
根据第3章《神经网络基础》中的交叉熵求导,分数梯度为
每行梯度和为零。若只保留 MASK 行,所得损失变成 \(-\log .6\approx0.510826\),数值可能看似相近,却删除了另两行的全部监督,并改变归一化后的梯度尺度。损失数字接近不能证明目标等价。
输出权重共享时,预测路径产生 \(\overline E_{\mathrm{out}}=\overline U^{\mathsf T}G\);输入路径还产生按损坏后词元编号聚合的 \(\overline E_{\mathrm{in}}\)。最终梯度为两者之和。这里输入编号可能是 MASK 或随机词元,而输出目标仍是原词元,它们参与同一参数表的不同路径。
35.4句对目标及共享主干
(选修)
下一句预测目标
下一句预测(Next Sentence Prediction,NSP)使用句对标签 \(r\in\{0,1\}\) 区分构造的连续句段与随机负句段。经典正例来自语料中的后续片段,负例由随机选择另一片段形成,配方约为一半正例、一半负例。它预测的是样例构造关系,不等于判断两个句子的逻辑蕴含,也不证明模型掌握时间因果关系。
取 CLS 位置的最终向量 \(h_c\),经池化变换 \(z=\tanh(h_cW_p+b_p)\) 后,二元分数为 \(a=w^\mathsf Tz+b\)。以 \(\sigma(a)\) 表示正例概率,损失为
NSP两样本损失
(选修) 若正例预测概率为 \(.8\),负例被预测为正例的概率为 \(.3\),两例平均损失为 \(-\frac{\log .8+\log .7}{2}\approx0.289909\)。训练用稳定的分数形式计算,不先取极小概率再取对数。
随机负例若与正例有明显文体或来源差异,模型可能依靠这些线索完成分类。句对目标的难度和有效性取决于负例构造,不能由正负数量平衡推出。
多任务损失及梯度汇合
设句对平均损失为 \(\mathcal L_{\mathrm{NSP}}\),联合目标可写为
对共享主干参数 \(\theta_e\),有
两任务的梯度可能协同,也可能冲突。MLM 按监督词元数归一化,NSP 按句对数归一化,即使 \(\lambda=1\),也不意味着两者对主干的影响同样大。比较损失权重时应同时考虑归一化口径和梯度尺度。
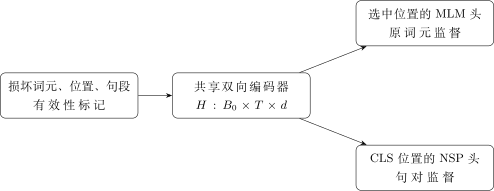
35.5分类、标注及抽取任务
(选修)
序列级分类及池化
对 \(C\) 类互斥标签,可令 \(u=zW_c+b_c\in\Real^C\),最小化序列交叉熵。预训练头与下游标签空间通常不同,下游分类头需要新的参数和标签映射。CLS 向量是一个具有完整上下文的指定位置,其任务能力来自训练,不是该字面名称自动保证的。
还可以对有效位置取平均,得到
若只池化普通文本,应进一步排除控制词元,并使用相应分母。平均池化与 CLS 池化是不同的读出函数,应在任务数据上比较,而不是假定两者等价。直接把预训练隐藏向量用于余弦检索,也不能自动获得适合语义相似度的度量空间;可能需要相应对比训练。
词元级标注及子词对齐
命名实体识别(Named Entity Recognition,NER)等任务对每个文本位置预测类别,分数形状为 \(B_0\times T\times C\)。原始标注若以词或字符为单位,而模型输入为子词,就必须建立对齐规则。一个原词拆成三个子词时,可只监督首子词,也可按标注语义传播标签;两种策略的有效位置数和损失权重不同。
特殊词元与填充通常不接受实体标签。若采用带边界语义的标签体系,不能简单复制一个词首标签到所有续接子词;解码后还需恢复合法片段并映射到原文偏移。独立位置分类不保证全局标签序列合法,是否增加结构化解码应由任务约束决定。
抽取式问答的起止分布
给定问题与包含答案的文段,编码器输出每个位置的向量。两组参数分别给出起点和终点分数:
只在允许作为答案的文段位置上归一化。真值为 \((i^*,j^*)\) 时,可以使用
独立起止分布可能把最高概率终点放在起点之前,因此推断时需在 \(i\le j\)、最大长度及允许位置约束下选择片段,例如最大化 \(a_i+b_j\)。这是带约束的解码,而非直接分别取两个最大值。无答案样例还需要明确的拒答位置或额外分类目标。
长文段切窗时,要保存窗口到原文的偏移、答案是否完整落入窗口以及重叠窗口的合并规则。切窗只改变输入覆盖,不会自动保证每个样本仍包含正确答案;对不含答案的窗口错误复制原标签会制造训练噪声。
35.6双向目标同自回归目标的差异
条件预测及联合概率
自回归目标利用链式法则定义 \(p(x)=\prod_t p(x_t\mid x_{<t})\)。MLM 则在损坏输入条件下恢复部分位置,并不直接给出这个有序生成分解。若同时遮盖多个位置,常见输出头分别预测各位置,并未在这些待恢复变量之间建立逐步生成条件。
例如,两处缺失内容在真实条件下只能取 \((a,a)\) 或 \((b,b)\),两种组合各占一半。两个位置的边缘分布均为 \((.5,.5)\)。若独立从两个边缘抽样,将以总概率 \(.5\) 产生不合法的 \((a,b)\) 或 \((b,a)\)。边缘预测准确不意味着联合恢复准确。
伪似然归一化反例
还可以对每个位置单独遮盖并把条件概率相乘,得到类似伪似然的分数。但它通常不在所有序列上归一化。以二元变量 \(x_1,x_2\) 为例,若两个条件均赋予“相同”为 \(.9\)、“不同”为 \(.1\),两个同值序列的乘积各为 \(.81\),两个异值序列各为 \(.01\),总和为 \(1.64\) 而非一。把该乘积直接称为整句概率就是错误的。
目标与结构必须配合
双向编码器可以在给定观测中读取左右上下文;掩码目标通过损坏输入建立恢复任务。它们并不自动提供严格自回归生成协议。若采用迭代填空生成,还必须定义更新次序、采样规则、终止条件和质量评估。
比较模型时保持任务单位一致
MLM 损失取决于损坏率、损坏方式、位置抽样和有效监督数。它不能直接与因果语言模型的每词元困惑度比较,甚至两个不同损坏配方下的 MLM 损失也不具有自动一致的难度。比较表示能力应在相同下游任务、数据隔离、适配预算和指标条件下进行。
部署时必须同时恢复分词器、配置、主干、任务头和标签映射。仅恢复主干而让分类头随机初始化,会得到形状正确但语义无效的预测。训练模式下的随机失活、位置上限、句段编号与填充掩码均属于预测函数的组成部分,需纳入一致性检查。保存与重载的正确性证明的是制品一致,不能代替独立任务评估。
若从含原词元的 \(V\) 个候选中均匀抽样,随机替换分支实际改变内容的概率为 \(1-\frac{1}{V}\)。若候选集合排除特殊词元或原词元,则需按实际抽样集合重新计算。↩︎