L大语言模型从理论到实践
阅读 PDF ↗
CHAPTER 42

条件视觉生成

条件生成要求模型在多样的视觉分布中满足指定信息:文本描述、参考图像、空间布局或时间条件。它既涉及概率路径,也涉及表示压缩、网络结构和求解器。第41章《扩散模型的概率原理》推导了加噪与反向过程;本章解释条件如何进入网络、引导如何改变预测,以及潜空间和视频扩展如何改变成本与误差。

离散视觉词元还可以采用自回归分解逐项生成,再由相应解码器恢复图像;该路线与反向扩散不同,表示接口见第40章《多模态建模》。因此,视觉输出并不必然意味着去噪过程。

42.1条件生成的对象及符号

本章主要符号见表42.1

表 42.1 条件视觉生成的主要符号。

符号 含义
\(x,z,c\) 像素样本、潜变量和条件表示。
\(H,W,C_x,f,C_z\) 图像高宽、像素通道数、空间压缩因子与潜通道数。
\(N,M,d,d_c\) 视觉位置数、条件位置数、视觉与条件特征宽度。
\(a_t,b_t\) 扰动路径中的信号系数与噪声系数。
\(s_t,\epsilon_\theta,w\) 得分函数、噪声预测与本章 CFG 引导系数。
\(\tau,u_\theta\) 从噪声走向数据的连续时间与速度场。
\(F,F',p_t,p_h,p_w\) 原始及潜空间帧数与时空补丁尺寸。

文本生成图像关注条件遵循与分布质量,图像编辑还要求保留未编辑区域,视频生成进一步要求跨帧身份、运动与时间一致性。条件可以作为序列、空间张量或全局向量进入网络,不必都转换成一段文本。训练时必须明确每种条件的缺失表示、对齐关系和可见范围。

42.2时间条件及去噪主干

U-Net 的多尺度路径

U形网络(U-Net)由下采样路径、瓶颈与上采样路径构成。下采样减少空间位置数,扩大后续局部算子的有效感受野;跳跃连接将较高分辨率特征传给对应上采样层。它并不自动保证全局建模,感受野仍取决于层数、卷积与注意力配置。

时间编码可采用

\[ e_{2j}(t)=\sin(\omega_j t),\qquad e_{2j+1}(t)=\cos(\omega_j t), \tag{42.1}\]

再经多层感知机形成调制向量。对特征 \(h\),常见条件调制为

\[ h'=\gamma(e_t,c)\odot\operatorname{Norm}(h)+\beta(e_t,c). \tag{42.2}\]

\(\gamma,\beta\) 沿空间维广播;其形状必须与通道一致。离散步编号、归一化时间与对数信噪比不是同一输入,替换时间编码时必须保持训练契约。
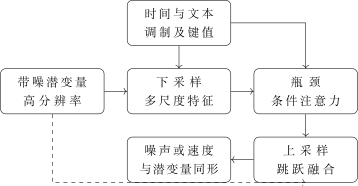
条件 U-Net 的结构关系;跳跃连接传递特征,不绕过去噪任务。
图 42.1 条件 U-Net 的结构关系;跳跃连接传递特征,不绕过去噪任务。

42.1中的时间与语义条件在不同尺度影响预测,跳跃特征仍需经过上采样分支的可训练计算。

交叉注意力及联合注意力

视觉特征 \(X\in\mathbb R^{N\times d}\) 和条件特征 \(C\in\mathbb R^{M\times d_c}\) 通过

\[ Q=XW_Q,\quad K=CW_K,\quad V=CW_V,\qquad A=\operatorname{softmax}\left(\frac{QK^\top}{\sqrt{d_h}}+B\right)V \tag{42.3}\]

建立交叉注意力。这里 \(W_Q\in\mathbb R^{d\times d_h}\)\(W_K\in\mathbb R^{d_c\times d_h}\)\(W_V\in\mathbb R^{d_c\times d_v}\),输出 \(A\in\mathbb R^{N\times d_v}\)\(B\) 排除条件填充等不可见位置。单头打分成本随 \(NMd_h\) 增长,而非视觉自注意力的 \(N^2d_h\)

把视觉与文本映射到兼容宽度后联合处理,可以让两种表示相互更新,但会产生约 \((N+M)^2\) 的注意力配对数。是否双向更新、是否使用独立投影和调制,是具体架构选择。文本编码器、分词器、截断规则和空条件表示都属于制品,不可只替换编码器名称。

Transformer 主干及目标相互独立

扩散 Transformer(Diffusion Transformer,DiT)把潜变量切分为补丁并使用 Transformer 预测去噪目标(Peebles 和 Xie 2023)。若潜图为 \(H_z\times W_z\times C_z\)、补丁边长为 \(p\),则位置数为 \(N=\frac{H_zW_z}{p^2}\),每补丁输入宽度为 \(p^2C_z\)。输出投影恢复每补丁所需通道,再重排为潜图。

时间或类别可调制归一化与残差门控。补丁变小会增加位置数;边长减半使 \(N\) 增至4倍,完整自注意力配对数增至16倍。主干为 Transformer 并不意味着训练目标必为流匹配:噪声预测、速度参数化和路径速度回归都可以由不同主干实现。

42.3无分类器引导的推导及边界

噪声外推

得分函数(Score Function)在本节指输入密度的梯度 \(s_t(x)=\nabla_x\log p_t(x)\),不是分类分数。给定条件 \(c\),贝叶斯关系给出

\[ \nabla_x\log p_t(c\mid x)=s_t(x\mid c)-s_t(x). \tag{42.4}\]

将条件信息梯度乘以 \(w\) 加到无条件得分上,得到

\[ \widehat s_t=(1-w)s_t(x)+w s_t(x\mid c). \tag{42.5}\]

对同一高斯扰动 \(x_t=a_tx_0+b_t\epsilon\),密度可微且交换积分与微分合法时,

\begin{align} \nabla_{x_t}\log p_t(x_t\mid c) &=\mathbb E\left[-\frac{x_t-a_tx_0}{b_t^2}\,\middle|\,x_t,c\right]\tag{42.6}\\ &=-\frac{\mathbb E[\epsilon\mid x_t,c]}{b_t}. \tag{42.7}\end{align}

因此噪声回归的最优条件均值与得分成比例。在相同 \(b_t>0\) 下,式(42.5)对应

\[ \widehat\epsilon=\epsilon_\theta(x_t,t,\varnothing) +w\left[\epsilon_\theta(x_t,t,c)-\epsilon_\theta(x_t,t,\varnothing)\right]. \tag{42.8}\]

无分类器引导(Classifier-Free Guidance,CFG)通过条件丢弃训练,让生成模型提供两种估计,无须另训分类器(Ho 和 Salimans 2022)。丢弃的是语义条件,不是时间;空条件的编码方式也必须在训练中确定。

外推精度边界

本章 \(w=0\) 返回无条件预测,\(w=1\) 返回普通条件预测,\(w>1\) 为外推。有的文献写成 \((1+s)\epsilon_c-s\epsilon_u\),其 \(s=w-1\),不能按相同数值比较。

在固定时间且归一化积分存在时,式(42.5)是形式密度 \(p_t(x\mid c)^w p_t(x)^{1-w}\) 的对数梯度。但不同时间的这种密度族未必满足原前向扩散关系,因此不能据此断言最终采样分布恰为 \(p_0(x\mid c)^w p_0(x)^{1-w}\)。模型近似与求解误差还会进一步改变结果。

设无条件与条件预测分别为 \((0.2,-0.1)\)\((0.5,0.3)\),则 \(w=2\)\((0.8,0.7)\)。这说明差向量被放大,并不说明图像更正确。若两支预测误差为 \(e_u,e_c\),引导误差满足

\[ \|e_{\rm cfg}\|\le |1-w|\|e_u\|+|w|\|e_c\|. \tag{42.9}\]

大引导可能放大误差、改变多样性和产生伪影。以负面提示替代空条件时,基线已变成另一个条件分支,不再是真正无条件密度;其语义应明确说明。1

42.4潜空间表示及重建限制

VAE 目标及重参数化

变分自编码器(Variational Autoencoder,VAE)以 \(q_\phi(z\mid x)\) 近似后验,解码器为 \(p_\psi(x\mid z)\)。由 Jensen 不等式,

\[ \log p_\psi(x)\ge \mathbb E_{q_\phi}\log p_\psi(x\mid z) -D_{\rm KL}(q_\phi(z\mid x)\|p(z)). \tag{42.10}\]

对对角高斯 \(q_\phi=\mathcal N(\mu,\operatorname{diag}\sigma^2)\) 与标准正态先验,KL 为

\[ \frac12\sum_j(\mu_j^2+\sigma_j^2-\log\sigma_j^2-1). \tag{42.11}\]

重参数化 \(z=\mu_\phi(x)+\sigma_\phi(x)\odot\eta\)\(\eta\sim\mathcal N(0,I)\) 将随机输入与参数分离,使梯度沿均值与尺度传播。实际视觉自编码器可能加入感知或对抗重建目标,故不能将所有潜空间编码器都称为仅优化上述标准 ELBO。

潜空间扩散(Latent Diffusion)先学习压缩表示,再在该表示上训练生成过程(Rombach 等 2022)。图像为 \(H\times W\times C_x\)、压缩率为 \(f\) 时,潜元素数为 \(\frac{HWC_z}{f^2}\),原图与潜空间元素比为 \(\frac{f^2C_x}{C_z}\)。例如 \(512\times512\times3\)\(64\times64\times4\),比值为48,空间位置数减少64倍。元素比不等于端到端加速比,编码、解码和主干通道均有成本。

缩放协议及不可恢复信息

若生成器训练使用 \(z'=sz\),采样结束后必须先得到 \(z=\frac{z'}{s}\) 再解码。遗漏缩放改变解码器输入分布;不能将一个模型的常数复制给其他制品。像素归一化、色域、裁剪、潜通道、后验采样或均值选择也必须一致。

编码器丢失的信息不会因为后续生成器更大而被可靠恢复。细小文字、线条与局部身份细节尤其需要独立验证。自编码器重建误差和生成误差属于不同来源:先对真实输入做编码解码对照,才能判断瓶颈是否已出现在表示层。

42.5流匹配及连续路径

(选修)

条件速度回归

本节以 \(\tau\in[0,1]\) 从噪声走向数据,端点记为 \(Z_0\)\(Z_1\),区别于第41章《扩散模型的概率原理》从干净样本出发的离散加噪记号。取一个端点联合分布,定义线性路径

\[ Z_\tau=(1-\tau)Z_0+\tau Z_1,\qquad U=Z_1-Z_0. \tag{42.12}\]

流匹配(Flow Matching)可以通过条件路径监督速度场(Lipman 等 2022)。平方损失

\[ \mathcal L=\mathbb E\|u_\theta(Z_\tau,\tau,c)-U\|^2 \tag{42.13}\]

在固定 \((z,\tau,c)\) 下的最优解为 \(u^*(z,\tau,c)=\mathbb E[U\mid Z_\tau=z,c]\)。证明来自平方展开:任意预测与条件均值之差的平方,加上与预测无关的条件方差,构成全部条件风险。

对光滑紧支撑测试函数 \(\varphi\),若微分与期望可以交换,

\[ \frac{d}{d\tau}\mathbb E[\varphi(Z_\tau)] =\mathbb E[\nabla\varphi(Z_\tau)^\top U] =\mathbb E[\nabla\varphi(Z_\tau)^\top u^*(Z_\tau,\tau,c)]. \tag{42.14}\]

因此该边缘速度满足对应密度路径的弱形式连续性方程。若速度场具备适当正则性与可积性,求解 \(\frac{dZ_\tau}{d\tau}=u^*(Z_\tau,\tau,c)\) 可以运输这些边缘分布。端点配对可以独立,也可来自其他耦合;它会改变条件速度与学习难度。

直线路径的生成边界

(选修)

训练样本路径是直线,但同一中间位置可能对应多对端点,其条件平均速度会随位置与时间变化。故学习到的边缘轨迹不必是各训练端点之间的那条直线,不能从线性插值直接推出一次网络调用即可精确生成。

Euler 更新为 \(z_{k+1}=z_k+h_k u_\theta(z_k,\tau_k,c)\)。若场足够光滑,单步局部截断误差为二阶、固定区间的全局误差通常为一阶;网络误差另计。以一维 \(u(z)=z,z(0)=1\) 为例,精确终点为 \(e\),单步 Euler 得2,两步得2.25,都不精确。该构造说明减少步数需要相应的求解或训练依据。

扩散中的 \(v\) 参数化常表示信号与噪声的特定线性组合,流匹配的 \(u\) 则是路径导数。两者都可能被接口称为 velocity,却不能只凭名称互换。预测对象、时间方向和求解器必须共同确定。

42.6编辑、视频及联合媒体

(选修) 图像编辑将参考图、遮罩或结构控制作为额外条件。若要求未编辑区域严格保持,应区分像素级约束与模型倾向;潜空间遮罩经过编码解码可能影响边缘及邻近区域。多次去噪中的已知区域替换还需匹配当前噪声尺度,不能直接把干净像素与高噪状态混合后宣称符合原模型。

视频潜变量可写为 \([B,C_z,F',H',W']\),时空补丁数为

\[ N=\frac{F'}{p_t}\frac{H'}{p_h}\frac{W'}{p_w}, \tag{42.15}\]

这里假设尺寸可整除,真实实现的补齐与边界另计。设每帧有 \(S\) 个空间位置,共 \(F'\) 帧,全时空注意力配对数为 \(F'^2S^2\);空间与时间分解注意力约为 \(F'S^2+SF'^2\),但其连接结构不同,不能称为完全相同算子的无损替换。

(选修) 例如16个潜帧,每帧 \(32\times32\) 位置,补丁为 \(1\times2\times2\),则 \(S=256,N=4096\),完整打分矩阵每头有约1678万项。帧数翻倍使全注意力项增至4倍,而空间分支仅翻倍。帧率、时长与潜时间压缩共同决定 \(F'\);某些因果时间编码器对首帧采用特殊处理,不能简单假设所有模型都有 \(F'=\frac{F}{f_t}\)

音视频联合生成需要共同时间基准、采样率与对齐条件。视觉连续不证明声画同步,片段看似合理也不证明物理动力学正确。所谓世界模型还需要动作条件、状态覆盖和闭环任务验证;视频观感不能替代控制稳定性证据。

42.7训练、采样及制品一致性

算法42.1 计算过程

条件潜空间生成的数据流。

  1. 固定像素预处理、编码器与潜缩放,取得训练潜变量及条件表示;记录条件缺失规则。

  2. 按训练目标采样时间和噪声,构造扰动或路径状态,计算噪声、样本或路径速度目标。

  3. 训练主干,确保输出形状、监督对象与时间权重一致;条件丢弃只按已定义策略执行。

  4. 推理时从匹配先验初始化,用匹配的预测参数化和时间方向逐步求解;需要引导时组合两支预测。

  5. 恢复潜缩放并解码,保留精确组件版本、生成配置与输出来源记录。

  6. 分别评价重建限制、条件遵循、质量、多样性、编辑保持与视频时间一致性;不以单张图代替分布评估。
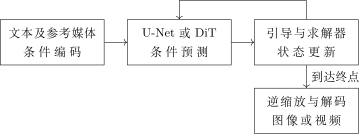
预测网络与求解器反复协作,解码仅在规定终点执行。
图 42.2 预测网络与求解器反复协作,解码仅在规定终点执行。

42.2显示预测与状态更新的分工;只有组件协议相容时,循环才具有所声明的概率含义。质量评估需同时检查条件遵循、分布多样性及任务细节:图文相似度只检查所用表示空间中的接近程度,不能独立证明计数、否定或局部文字正确;某种分布距离很小,也不能证明每个条件下都生成了正确结果。

服务预算应同时限制分辨率、帧数、采样步数、候选数和并发;请求数本身不足以描述工作量。组件清单包含主干、文本编码器、分词器、自编码器、缩放、求解器与控制模块。代码可获取、权重可获取和特定部署用途允许是不同事实,应依据所用精确制品记录,不能继承同家族其他版本的结论。


  1. 将两支合并为一个批次可以减少某些调度开销,但仍需处理两组条件前向,不等于只计算一支的成本。↩︎

WORKBOOK / 习题

配套习题与解析

先独立作答,再展开参考解析。选修题保留原书标记。

习题 42.1

写出视觉与文本交叉注意力的全部形状,比较它与联合注意力的配对数。

展开参考解析

单头视觉\(H_v\in\mathbb R^{N_v\times d}\),文本\(H_t\in\mathbb R^{N_t\times d_t}\),投影得\(Q\in\mathbb R^{N_v\times d_k},K\in\mathbb R^{N_t\times d_k},V\in\mathbb R^{N_t\times d_v}\)。分数和权重为\(N_v\times N_t\),输出\(N_v\times d_v\),多头再拼接投影。交叉配对数\(N_vN_t\);联合注意力以\(N_v+N_t\)位置构成\((N_v+N_t)^2\)对,包含双方内部及反向交互,结构不同不能只按成本等价替换。

习题 42.2

潜图补丁边长从4改为2时,位置数与完整打分矩阵如何变化?哪些成本不遵循平方变化?

展开参考解析

固定潜图面积、无补齐且不计特殊位置,块边从4到2使每块面积降为四分之一,位置数增4倍,完整分数矩阵增16倍。逐位置线性层通常随位置数增4倍,补丁输入投影维数也改变;VAE编码、解码、文本编码等不按16倍变化。实际速度还取决于分块内核和带宽。

习题 42.3

从高斯扰动密度推导条件得分与噪声条件均值的关系,指出 \(b_t=0\) 时的问题。

展开参考解析

扰动\(x_t=a_tx_0+b_t\epsilon\)\(b_t>0\)时条件核得分为\(\nabla_{x_t}\log q(x_t\mid x_0,c)=-\frac{x_t-a_tx_0}{b_t^2}=-\frac{\epsilon}{b_t}\)。在可交换微分积分且密度正的条件下,对后验\(x_0\mid x_t,c\)求期望得 \(\nabla\log p_t(x_t\mid c)=-\frac{E[\epsilon\mid x_t,c]}{b_t}\)。b为0时核退化、该除法不成立,必须通过端点极限或单独边界处理。

习题 42.4

\((1+s)\epsilon_c-s\epsilon_u\) 转换成本章引导约定,并计算 \(s=3\) 对应的 \(w\)

展开参考解析

本章约定\(\epsilon_g=\epsilon_u+w(\epsilon_c-\epsilon_u)=w\epsilon_c+(1-w)\epsilon_u\)。比较系数可得\(w=1+s\),s为3时w为4。不同库把guidance称为s或w,参数同名不能直接照搬;条件缺失训练、数值精度与双路推理协议也需一致。

习题 42.5

为什么固定时间的幂次密度解释不能直接证明 CFG 终点分布?

展开参考解析

在固定t上,\(s_u+w(s_c-s_u)\)可写成\(\nabla\log[p_t(x\mid c)^w p_t(x)^{1-w}]\),但这只是该时间局部得分形式。各t的幂次密度未必满足采用的前向/反向动态所需的一致边缘方程,且归一化与模型误差另有条件。因此不能据此断言采样终点恰为对应幂次数据密度,更不能保证w越大越真实。

习题 42.6

推导对角高斯到标准正态的 KL,解释重参数化如何支持梯度传播。

展开参考解析

\(q(z\mid x)=\mathcal N(\mu,\operatorname{diag}\sigma^2)\)\(\mathcal N(0,I)\)的KL为\(\tfrac12\sum_j(\mu_j^2+\sigma_j^2-1-\log\sigma_j^2)\),来自均值项、协方差迹、维数项与行列式比。写\(z=\mu+\sigma\odot\epsilon,\epsilon\sim\mathcal N(0,I)\)后,随机源独立参数,可通过\(\mu,\sigma\)对重建损失反传。重参数化不消除采样方差,也不保证潜空间无信息损失。

习题 42.7

计算 \(1024\times1024\times3\)\(128\times128\times16\) 的元素压缩比,解释为何不是64倍。

展开参考解析

原元素数\(1024^2\times3=3145728\),潜元素\(128^2\times16=262144\),比值12。空间面积比64,但通道从3到16,所以元素比为\(\frac{64\times3}{16}=12\)。元素个数还没有乘精度字节数,不能直接等同文件压缩率或端到端加速。

习题 42.8选修

证明平方速度回归的条件均值最优性,并写出连续性方程的弱形式。

展开参考解析

令U为训练条件路径速度,固定\((z,t,c)\)时平方回归同样分解为不可约条件方差加\(\|u-E[U\mid z,t,c]\|^2\),最优场为条件期望。对光滑紧支撑\(\varphi\),若微分可交换,\(\frac{dE[\varphi(Z_t)]}{dt}=E[\nabla\varphi(Z_t)^Tu(Z_t,t,c)]\),等价弱式\(\partial_tp+\nabla\cdot(pu)=0\)。从弱式到唯一ODE运输还需速度正则性、可积性等条件,不能只凭训练损失低得出精确生成。

习题 42.9选修

\(u(z)=z\) 使用四步 Euler,比较结果与 \(e\),解释误差来源。

展开参考解析

补足初值和区间为\(z(0)=1,t\in[0,1]\),步长\(h=\frac{1}{4}\)。递推\(z_{k+1}=1.25z_k\),四步为\(1.25^4=2.44140625\);精确\(e\approx2.71828183\),低估约0.27687558。局部截断\(O(h^2)\)、固定区间全局\(O(h)\)需光滑与稳定条件;网络近似误差不包含在该纯求解器例子中。

习题 42.10选修

比较完整时空注意力与分解注意力的连接关系,说明为何不能只比较 FLOPs。

展开参考解析

F帧每帧S位置,完整配对\(F^2S^2\);空间后时间分解约\(FS^2+SF^2\)。后者先在同帧或同位置混合,跨帧跨位置关系通过多层/组合间接传播,通常不等于一次完整注意力。还须比较布局变换、同步、局部性、表达能力及质量,FLOPs相同或较少不能证明性能与能力优势。

习题 42.11选修

为图像编辑分别定义条件遵循与未编辑区域保持指标,构造二者冲突的情形。

展开参考解析

例如“把杯子改为红色,背景不动”,分别度量目标掩码内颜色/语义符合率和掩码外像素误差、结构差异。使整图偏红可提高粗图文相似度却损害背景保持;强制每个外部像素不变又可能留下杯边不自然。应声明边界羽化范围和允许光照变化,并用人工或任务标注检验,不能只用一项总相似度。

习题 42.12

设计生成制品清单,列出替换 VAE、文本编码器或求解器时必须核对的契约。

展开参考解析

清单含主干、VAE、文本编码器/分词器、潜通道/尺度、时间映射、预测对象、采样网格、CFG约定、控制模块和精度。换VAE须核对潜维数、缩放、分布与解码;换文本编码器须核对维数、模板及训练语义空间;换求解器须核对时间方向、预测类型和端点。组件可加载只证明接口部分兼容,仍需固定输入的数值及生成质量验证。

习题 42.13选修

计划把生成器的求解步数由30步降至1步。分别说明仅改变数值求解步数与使用适配的一致性训练或蒸馏模型所需的论据,并设计覆盖质量、多样性、条件约束和真实延迟的比较。

展开参考解析

仅改变步数会改变数值离散误差;训练插值路径为直线,也不能推出模型边缘速度沿实际轨迹恒定或单步 Euler 精确。采用一致性训练或蒸馏时,应核对模型预测对象、噪声或时间端点、条件输入与对应采样协议,确保单步执行符合训练目标。使用固定测试条件和覆盖多个随机种子的样本集合,比较质量分布、多样性、条件遵循及失败切片,并计入编码、解码和其他流水线阶段测量实际延迟及资源占用。记录模型制品和求解配置;单张成功样本或 FLOPs 下降不足以支持整体部署结论。

REFERENCES

参考文献

Ho, Jonathan, 和 Tim Salimans. 2022. 《Classifier-Free Diffusion Guidance》. 2022年. https://arxiv.org/abs/2207.12598.
Lipman, Yaron, Ricky T. Q. Chen, Heli Ben-Hamu, Maximilian Nickel, 和 Matt Le. 2022. 《Flow Matching for Generative Modeling》. 2022年10月6日. https://arxiv.org/abs/2210.02747.
Peebles, William, 和 Saining Xie. 2023. 《Scalable Diffusion Models with Transformers》. 2023年. https://arxiv.org/abs/2212.09748.
Rombach, Robin, Andreas Blattmann, Dominik Lorenz, Patrick Esser, 和 Björn Ommer. 2022. 《High-Resolution Image Synthesis with Latent Diffusion Models》. 2022年. https://arxiv.org/abs/2112.10752.

搜索全书

搜索全书正文、习题与解析