缓存减少已经完成的计算,算子优化减少完成一次计算所需的数据移动与调度,推测解码则尝试在一次目标模型调用中确认多个输出。三者作用于不同成本项。判断一种优化是否成立,首先要确定它保留了什么:同一数学算子、同一概率分布,还是仅保留某项任务质量的近似水平。
第30章《增量解码》解释历史状态的复用。本章先推导在线归一化与分块注意力,再讨论融合、编译和形状,最后证明精确推测解码的分布保持性质。低精度误差在第34章《模型优化》展开,请求级调度在第31章《批处理调度》展开。
33.1计算、搬运及启动成本
本章主要符号见表33.1。
表 33.1 推理计算优化的主要符号。
| 符号 | 含义 |
|---|---|
| \(T_q,T_k,d_h,d_v\) | 查询数、键数、键头维数和值头维数。 |
| \(Q,K,V\) | 单头矩阵,形状分别为 \(T_q\times d_h,T_k\times d_h,T_k\times d_v\)。 |
| \(z_j,v_j\) | 某查询对第 \(j\) 个键的分数及对应值向量。 |
| \(m,\ell,u\) | 已处理键集合的最大分数、缩放指数和、缩放值加权和。 |
| \(F,Q_b,R,b\) | 运算量、搬运字节数、有效计算速率和有效带宽。 |
| \(p,q\) | 给定前缀下的目标采样分布与草稿采样分布。 |
| \(k,\alpha\) | 单轮草稿候选数及特定假设下的条件接受概率。 |
对一个执行片段,计算时间至少为 \(\frac{F}{R}\),数据传输时间至少为 \(\frac{Q_b}{b}\)。两者可部分重叠,因此 \(\max(\frac{F}{R},\frac{Q_b}{b})\) 是简化下界,而不是全部延迟。主机调度、设备启动、同步和布局变换还会增加成本。小矩阵可能受启动时延限制,大矩阵可能受计算或带宽限制,不能只比较浮点运算数。
若某优化仅加速原总时间中的比例 \(f\),该部分加速 \(s\) 倍,其他部分不变,则总加速比为
例如某算子占40%,即使加速4倍,总加速也只有 \(\frac{1}{0.6+0.1}\approx1.43\)。加入新的布局转换或同步后还会更低。算子收益必须沿完整路径核算。
33.2在线 Softmax 的充分统计量
分块归一化合并
单查询注意力输出为
\(M_j\) 表示允许的加性偏置或掩码。将键分为两组后,各组独立 Softmax 的分母不同,直接相加或等权平均两组输出通常错误;必须知道每组在全局分母中所占的质量。
对非空有效键集合 \(A\),保存
\(m_A,\ell_A\) 是标量,\(u_A\in\Real^{d_v}\)。在线归一化通过更新最大值与归一化和,避免先遍历完整向量求最大值再单独计算分母(Milakov 和 Gimelshein 2018)。
适配器合并定理
对不相交有效集合 \(A,B\),令 \(m=\max(m_A,m_B)\),则
因为 \(e^{m_A-m}e^{z_j-m_A}=e^{z_j-m}\),第一行正好等于全体键的缩放指数和,第二行同理。因此合并结果仍满足式(33.3),最终输出为 \(o=\frac{u}{\ell}\)。
只要每次合并保留这三个统计量,就可以按任意分块顺序处理同一键集合。在精确算术下,合并对应集合并集,因而结果与分块方式无关;浮点舍入会受顺序影响。不物化完整概率矩阵并不意味着省略某些键,也不意味着近似 Softmax。
空块不能直接通过 \(m=-\infty\) 与另一个空块相减来处理。实现应使用有效标志:全掩码块不贡献统计量;首个非空块直接初始化。若整个查询行没有合法键,数学分母为零,需要按模型接口明确定义输出或拒绝输入,不能让未定义值传播。
例25.1
设分数为 \((\log2,\log1,\log6)\),对应标量值为 \((1,4,5)\),前两个键组成块 \(A\),第三个键组成块 \(B\)。有 \[\begin{aligned} m_A&=\log2,&\ell_A&=\frac{3}{2},&u_A&=3,\\ m_B&=\log6,&\ell_B&=1,&u_B&=5. \end{aligned}\] 共同最大值为 \(\log6\),块 \(A\) 的缩放系数为 \(\frac{1}{3}\),因此 \[\ell=(\frac{1}{3})(\frac{3}{2})+1=\frac{3}{2},\qquad u=(\frac{1}{3})3+5=6,\qquad o=4.\] 完整计算为 \(\frac{2\times1+1\times4+6\times5}{2+1+6}=4\)。两个块的局部输出分别为2和5;直接相加得到7,等权平均得到3.5,均不等于正确结果,因为两块的全局指数质量分别为3和6。
算法33.1 单查询的分块精确注意力
输入:查询、按块读取的键值、可见性规则;输出:注意力值向量。
初始化为“尚无有效键”,不对空集合最大值作算术运算。
读取一块键值,计算分数与掩码。若无合法位置,跳到下一块。
计算本块 \((m_b,\ell_b,u_b)\);若是首个有效块,直接保存,否则按式(33.5)合并。
处理完所有块后,若存在有效键,返回 \(\frac{u}{\ell}\);否则执行预先定义的全掩码行处理。
33.3FlashAttention 及存储层次
显式实现通常先写出 \(T_q\times T_k\) 分数,再读出求 Softmax,最后读取概率矩阵计算与 \(V\) 的乘积。若 \(T_q=T_k=8192\),单头分数矩阵含67108864个元素;即使每元素仅2字节,也占128 MiB,32头则仅这一类矩阵已达4 GiB,尚未计批量和其他状态。
FlashAttention 将查询块、键值块及归一化状态安排在片上存储中,利用分块计算减少中间矩阵与高带宽显存之间的往返(Dao 等 2022)。核心收益在于数据移动,不是将稠密注意力的 \(O(T_qT_kd_h)\) 算术阶改成线性。因果掩码可以跳过某些完全不可见块,但仍保留对应可见集合内的完整注意力。
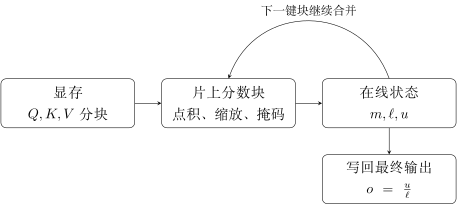
块大小、并行度及反向重算
较大的块可以复用更多数据,却占用更多寄存器和片上存储,降低同时驻留的执行单元数;过小的块则增加读取和循环开销。因此块大小由头维、精度、设备资源及并行映射共同决定,不能只追求最大块。
训练时无需保存全部注意力概率,也可以在反向中由保存的行归一化信息和重算分数恢复局部概率。令 \(P=\operatorname{softmax}(S)\)、\(O=PV\),上游梯度为 \(G_O\),则
这些关系解释为什么反向可逐块重新计算所需概率。实际实现还须处理掩码、Dropout及浮点累计;不能在重算时更换随机掩码。
接口、后端及正确性条件
缩放点积注意力接口规定输入输出语义,具体后端由设备、形状、精度和支持条件选择。调用统一接口不等于确认使用了某个指定内核。采用优化路径时,掩码极性、非方形因果对齐、头分组、缩放因子和张量步幅均须保持一致。
例如缓存解码的查询只覆盖最新位置,而键包含整个历史。如果将一个 \(1\times T_k\) 因果掩码误按查询局部索引从零对齐,可能只允许读取第一个键。正确可见集合取决于查询的逻辑位置,不能只由矩阵左上角推断。此类错误输出可能仍有限,因此“没有 NaN”不是正确性证据。
33.4算子融合及执行图
算子融合(Operator Fusion)把相邻运算放在同一执行内核中,减少中间张量写回和启动。以 \(y=\phi(xW+b)\) 为例,若矩阵乘法后写回 \(Z=xW\),偏置与激活再分别读写,额外流量与 \(Z\) 的元素数成正比。将偏置、激活作为矩阵乘法的尾部计算,可避免这些完整中间结果的显存往返。
融合也有边界:中间结果被多个分支使用时,重新计算可能比保存更贵;融合后寄存器压力过大可能使数据溢出到较慢存储;跨设备通信或跨线程全局归约常需要显式同步。数学表达能合并,不保证单个大内核一定更快。
图编译(Graph Compilation)将一段运算图转为特化执行程序;执行图回放(Execution Graph Replay)复用已记录的提交依赖,主要减少重复调度。两者并非同义:回放不必重新选择算子算法,编译也不保证所有动态控制流都能被捕获。
当主机读取设备张量的值以决定分支时,可能引入同步并切断可捕获区域。应把数据依赖与元数据依赖分开分析。不能为了避免图断裂而把用户要求的停止条件或可见性逻辑删去。
形状特化的摊销模型
设一次编译成本为 \(C\),未编译每次耗时 \(t_e\),编译后耗时 \(t_c<t_e\),调用 \(n\) 次,则净收益条件为
若 \(C=3\)秒,每次由2毫秒降到1.5毫秒,需要超过6000次调用才能取得净时间收益。对每个形状分别编译时,应逐桶计算 \(C_i,n_i\),冷门桶可能始终无法摊平。
形状分桶(Shape Bucketing)把实际形状映射到有限执行形状。设长度随机变量为 \(T\),映射到桶上界 \(b(T)\),填充位置的期望为 \(\mathbb E[b(T)-T]\)。对稠密注意力,额外计算更接近 \(\mathbb E[b(T)^2-T^2]\),不能只按平均长度差估计。桶过多增加编译和缓存,桶过少增加无效计算与预留内存。
33.5推测解码的精确性
接受质量及残差质量
推测解码(Speculative Decoding)由较便宜的草稿过程提出候选,再由目标模型验证(Leviathan, Kalman, 和 Matias 2022)。下面讨论保持目标采样分布的精确形式,不将贪心匹配规则混入随机采样证明。
采样分布条件
\(p\) 与 \(q\) 定义在同一离散词元空间,均为归一化概率。候选确实按 \(q\) 采样,计算的概率包括各自实际使用的温度、截断和约束。目标 \(p\) 是希望保留的分布;\(q\) 不必与 \(p\) 使用相同采样参数。所有概率对应同一个已确认前缀。
对候选 \(x\sim q\),当 \(q(x)>0\) 时以
接受。\(q(x)=0\) 的词元不会被提议,无需对其计算该比值。接受并输出 \(x\) 的无条件质量为 \(q(x)a(x)=\min(p(x),q(x))\)。总接受率为
第二个等号由 \(\min(a,b)=\frac{a+b-|a-b|}{2}\) 得到。因此接受率等于1减去两个分布的总变差距离。
若拒绝,令 \(Z=1-A\),从残差分布
采样,其中 \([u]_+=\max(u,0)\)。由于两分布和均为1,正差之和恰为 \(Z\),残差归一化成立。最终输出概率为
若 \(Z=0\),拒绝事件概率为零,不应执行除以零的残差构造。目标有质量而草稿为零的位置,可通过拒绝后的残差获得,因此草稿不必覆盖目标的完整支持集。
例25.2
设 \(p=(0.5,0.3,0.2)\)、\(q=(0.2,0.5,0.3)\)。接受概率为 \((1,0.6,\frac{2}{3})\),接受路径质量为 \((0.2,0.3,0.2)\),总接受率0.7。拒绝概率0.3,正残差为 \((0.3,0,0)\),因此拒绝后必定输出第一个词元。合并得到 \((0.5,0.3,0.2)\),正好是目标分布。
若错误地在拒绝后直接从 \(p\) 重采样,最终质量为 \((0.2,0.3,0.2)+0.3p=(0.35,0.39,0.26)\),已改变目标。较高接受率不能补救错误的拒绝分支。
33.6多词元验证及缓存事务
草稿依次提出 \(k\) 个候选 \(x_1,\ldots,x_k\)。目标模型利用因果前向,一次计算这些候选对应前缀下的条件分布,以及全部接受之后的下一分布。验证必须按候选顺序进行:仅在前面候选全部接受时,当前目标条件才对应已确认前缀。
第一次拒绝发生在 \(j\) 时,保留 \(x_{<j}\),按该位置残差采样修正词元,并丢弃 \(x_{>j}\)。如果全部接受,则可从目标在完整草稿前缀后的分布再采样一个词元。逐位置应用式(33.13)并对已确认前缀归纳,可得最终序列仍服从目标自回归分布。
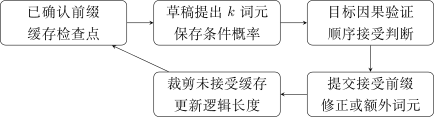
生成的修正词元尚未必被目标模型前向处理。因此实现需区分“已输出序列长度”和“已物化KV的长度”,下一次调用从未物化的后缀接续。草稿模型也要恢复到相同已确认前缀。简单删除输出文本却保留被拒绝词元的KV,会破坏下一步条件概率。
终止词元一旦接受或由修正分支生成,应立即结束请求,不再附加奖励词元。长度预算也应裁剪本轮可提交量。随机数流不同可以导致同一种子生成不同具体样本;分布保持不等于逐样本输出相同。1
算法33.2 保持目标分布的推测解码
输入:目标 \(p\)、草稿 \(q\)、已确认前缀、候选预算 \(k\)、停止规则;输出:目标分布下的新词元。
保存草稿与目标的已确认缓存边界。草稿自回归采样不超过 \(k\) 个候选,并保存或能够精确重建每步完整的条件提议分布 \(q_i(\cdot)\)。仅保存抽中词元的概率不足以构造拒绝后的残差分布;等价实现必须提供精确残差采样所需的分布表示。
目标因果验证候选,取得每个候选前缀下的实际目标概率及全部接受后的分布。
按顺序比较独立均匀随机数与接受概率;接受则提交该候选,遇停止标记立即结束。
第一次拒绝时,按式(33.12)采样修正词元,舍弃后续候选及其缓存,结束本轮。
若候选全部接受且尚未达到停止或长度条件,从额外目标分布采样一个词元。
同步两套逻辑前缀,标记尚未物化的KV后缀;继续下一轮或返回完成结果。
33.7推测收益及正确性边界
设一轮中每个候选在之前均已接受的条件下,接受概率都为常数 \(\alpha\),暂不考虑提前终止。至少提交 \(i+1\) 个词元需要前 \(i\) 个候选全部接受,因此一轮提交量 \(N\) 的期望为
\(\alpha=1\) 时取极限 \(k+1\)。条件接受率不恒定时,应使用各级生存概率,不能把所有候选的总体平均接受率直接代入幂次。
设草稿每步代价 \(c_d\),目标验证一轮代价 \(c_v(k)\),缓存和采样管理代价 \(c_m\),普通目标单步代价 \(c_t\)。近似加速比为
取 \(k=3,\alpha=0.8\),期望提交量为2.952。若 \(c_t=10\)毫秒、\(c_d=1\)毫秒、\(c_v=12\)毫秒、\(c_m=1\)毫秒,则近似加速比为 \(\frac{29.52}{16}=1.845\)。若验证代价增到30毫秒,则降到 \(\frac{29.52}{34}<1\)。这些是给定成本的构造算例,不是任何设备的实测。
滑动窗口注意力(Sliding-Window Attention)只保留规定范围内的可见键。对原本全注意力的模型,删除窗口外质量通常改变输出,即使分块计算本身完全精确。若被删除的原注意力概率质量为 \(\delta\),所有值向量范数不超过 \(M\),保留部分重新归一化后输出 \(o'\),则当 \(\delta<1\) 时
证明是将原输出写成 \((1-\delta)o'+\delta o_{\mathrm{drop}}\),再用三角不等式。该上界需要知道被删除的质量,不能由“距离较远”自动推断 \(\delta\) 很小。原生窗口模型按照其既定掩码执行,则是在保留该模型自身的目标。
最终正确性需要区分算子数值容差、缓存逻辑一致、采样分布与任务质量。随机解码不能只比较一次文本是否相同;应结合分布证明与小词表概率算例。性能记录则区分首次编译、稳态执行、首词元、后续词元以及排队边界,避免把局部内核收益误认为端到端收益。
确定性贪心解码可采用与目标最大概率词元逐项比较的专门规则,但那是在复现贪心路径,不是证明随机目标分布保持。↩︎