预训练决定模型首先学习怎样的文本分布,以及有限资源应投入多少参数和多少训练词元。两者不能分开讨论:同样的词元数量可能对应不同语言、领域与重复程度;同样的参数数量也可能因训练不足而不能充分发挥作用。规模定律提供的是受条件约束的预算模型,训练目标则规定该模型究竟在衡量什么。
本章从有效监督词元上的最大似然出发,讨论文档边界、数据混合和预训练任务,再推导给定计算预算下的模型与数据配置。第18章《训练数据工程基础》的数据流水线负责构造合格语料,第27章《模型规模及资源预算》的算力规划负责把工作量映射到设备、网络和存储,第19章《训练稳定性》的训练优化负责参数如何更新。本章连接这三者,回答“用什么分布、优化什么目标、分配多少训练量”。
23.1预训练所估计的分布
由联合概率到条件预测
预训练(Pretraining)通常从随机初始化开始,利用大规模数据学习可迁移的表示与生成分布。已有基座上的继续预训练(Continued Pretraining,CPT)沿用相近目标,但初始参数已经包含先前训练分布的信息,不能把它当作同等数据预算下的从零训练。
设文档 \(x=(x_1,\ldots,x_T)\),在给定起始标记与终止规则下,链式法则给出
\(\theta\) 为可学习参数,\(x_{<t}\) 是当前位置之前的词元。该概率分解并不要求文档内部各词元独立;相反,相关性通过条件分布表达。训练时使用真实前缀,称为教师强制(Teacher Forcing)。推理时前缀包含模型自身生成的内容,因此训练似然改善与生成质量改善有关,却不是完全相同的判据。
若训练样本来自分布 \(P\),在固定上下文定义下,期望负对数似然可写为
这里 \(c\) 表示可见上下文,\(y\) 为预测目标,\(H\) 为条件熵,\(D_{\mathrm{KL}}\) 为相对熵。第一项在分布固定时与参数无关,最小化损失因而推动模型逼近该训练条件分布。改变文档筛选、采样权重或可见前缀,就改变了这里的 \(P\);数据处理不是目标之外的中性准备步骤。
符号及假设
| 符号 | 含义 |
|---|---|
| \(P_i,\pi_i\) | 来源 \(i\) 的有效目标词元分布及其训练混合权重。 |
| \(B,T,V\) | 批次序列数、物理块长度与词表大小。 |
| \(m_{b,t},S\) | 预测位置的监督掩码;当前聚合范围内有效目标总数。 |
| \(N,D,C\) | 模型参数规模、训练消费词元数与训练浮点运算量。 |
| \(D_u,D_s,D_p\) | 不同内容的可用词元量、有效监督量、实际处理位置量。 |
| \(E,A,B_s,\alpha,\beta\) | 经验损失底座、两个正系数及两个正幂律指数。 |
| \(\kappa,C_0\) | 计算近似中的比例系数与给定计算预算。 |
\(B_s\) 使用下标,以避免与批次大小 \(B\) 混淆;\(N\) 在本章专指参数规模,不用于表示有效词元数。
预算模型的适用条件
似然比较固定分词器、验证分布、边界策略与监督区域。规模拟合针对相近的密集 Transformer 架构、数据质量、训练长度与优化完成程度;参数计数和词元计数采用同一口径。幂律是有限观测范围内的经验假设,不是对任意任务、模型或重复语料都成立的定理。
23.2有效词元上的目标及归一化
标签配对及稳定交叉熵
考虑长度为 \(T\) 的输入块 \((x_0,\ldots,x_{T-1})\)。模型输出 \(Z\in\mathbb R^{B\times T\times V}\),位置 \(t\) 的向量 \(z_{b,t,:}\) 预测 \(x_{b,t+1}\),因此块内候选目标只有 \(T-1\) 个。若库中标签最初复制输入,损失内部须将输出的前 \(T-1\) 位与标签的后 \(T-1\) 位配对。另一种等价接口显式构造目标序列,并让输入相对于目标右移。两种实现不能同时移位。
令 \(m_{b,t}=1\) 表示这一预测配对参与监督,\(m_{b,t}=0\) 表示忽略,则
实现对数求和指数时可先减去最大分数再加回,以避免指数溢出。\(S=0\) 的批次没有定义平均训练目标,必须跳过更新或在构造阶段排除,不能把分母替换成一之后声称取得零损失。
由 softmax 的导数可得
因此,分母不仅改变日志数值,也改变梯度权重。填充掩码控制哪些位置是实际输入,因果掩码控制可见性,监督掩码控制哪些配对贡献梯度;三个对象必须分别定义。
批次均值的聚合偏差
设两个微批次分别含 \(S_1=2\)、\(S_2=6\) 个有效目标,对应平均损失 \(L_1=1\)、\(L_2=3\)。整体目标为
而简单平均得到2。后者给短批次中的每个词元三倍权重。对梯度累积,正确的整体梯度为
混合精度和裁剪见第19章《训练稳定性》,分布式梯度平均见第29章《分布式训练》;目标层面的原则是先确定总监督量,再分配各微批次的权重。
按文档等权也是合法但不同的目标。若文档 \(i\) 的有效长度为 \(T_i\),词元等权与文档等权分别为
文档等权提高短文档中单个词元的影响。选择哪一种取决于希望拟合的统计单位,不应由数据加载器的默认归约偶然决定。
困惑度的比较条件
困惑度(Perplexity,PPL)定义为 \(\exp(\mathcal L)\),其中对数以自然底计算。它等于正确目标概率几何平均数的倒数。上例整体困惑度为 \(\exp(2.5)\approx12.18\),既不等于两个批次困惑度的算术平均,也不等于 \(\exp(2)\)。
困惑度不是模型可能输出的词数,更不是事实错误率。它的比较依赖相同分词器、验证文本、可见上下文和目标掩码。使用相同文本而改变分词器,会改变目标单位及条件分解;此时可以补充每字节负对数似然,但仍须统一规范化和文本覆盖。1
23.3序列装箱的条件分布
终止标记及注意力隔离
序列装箱(Sequence Packing)把多个片段安排进物理块以减少空位。若独立文档 \(a\)、\(b\) 被连成 \(a,\mathrm{EOS},b,\mathrm{EOS}\),采用普通因果注意力时,\(b\) 的预测条件包含 \(a\)。加入终止标记只是提供边界信息,并不把联合概率自动变为 \(p(a)p(b)\)。
若训练目标要求文档独立,设位置 \(t\) 的文档编号为 \(d(t)\),可见性需要满足
同时必须处理跨段目标配对。屏蔽 \(a\) 对 \(b\) 的注意力,并不自动阻止 \(a\) 的末尾输出预测 \(b\) 的第一个词元。通常每段含起始标记,由起始标记预测该段首词元;上一段终止位置到下一段起始位置的配对不计入损失。是否重置位置编号也需固定,因为位置分布会因此改变。
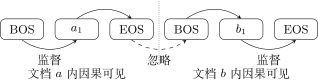
对于连续章节、代码文件集合或保留上下文的对话,跨片段可见也可能是刻意设计。关键在于物理切片是否对应统计独立单位。把同一文档拆段后完全隔离,会损失长距离条件;把不相关文档连接而不隔离,则引入人为前缀分布。
块边界及尾部损失
连续词元流切成多个独立输入块时,每个块最后位置缺少块内后继目标。若采用重叠一个词元的窗口,可保留该边界预测,但更大的重叠会重复监督内容。若只保留重叠区域作为上下文,应将已经计入过的目标屏蔽,以免改变权重。
尾部丢弃、填充、跨分片续接分别影响覆盖率、计算利用率和读取状态。假设100个文件各有129个词元,每个文件单独按128切块会丢弃100个词元;跨文件保留缓冲尾部可减少这一损失,却必须另外保留文档边界,不能以减少浪费为理由改变条件结构。验证集也必须使用同一明确策略,否则损失变化可能只是可见上下文或被评分目标不同。
装箱率与监督率是不同指标
非填充位置占物理位置的比例描述装箱利用率;有效目标占物理位置的比例描述监督密度。边界标记、仅供上下文的前缀和掩码区域均可能消耗计算而不贡献直接损失。规模预算必须同时保留这两类计数。
23.4数据混合及长尾覆盖
重要性权重
设来源 \(i\) 的目标词元分布为 \(P_i\),希望以权重 \(\pi_i\) 训练,则
若加载器先以概率 \(q_i\) 选择来源,再抽取平均有 \(\bar s_i\) 个有效目标的文档,聚合后的词元比例近似为
因此,两个来源按文档各取一半,若平均有效长度分别为100与900,实际词元比例为一比九。要得到词元各半,需要文档采样概率九比一。对具有不同监督密度的任务,应使用有效目标长度而不只使用原始文档长度。
常用温度平滑以合格可用词元量 \(n_i\) 定义 \(\pi_i\propto n_i^\tau\),\(0\le\tau\le1\)。这里 \(\tau\) 是混合指数,并非 softmax 温度或规模幂律指数。\(\tau=1\) 保留规模比例,\(\tau=0\) 对非空来源等权。降低指数会提高小来源相对份额,但不能增加该来源实际拥有的不同信息。
数据混合配比
例16.1
设三个来源可用词元量为90、9、1十亿。自然比例为 \(0.90,0.09,0.01\);取 \(\tau=\frac{1}{2}\) 后,权重与 \(\sqrt{90},3,1\) 成正比,约为 \(0.7034,0.2224,0.0741\),最后一项因四舍五入可作相应校正。计划消费200十亿词元时,各来源的名义遍历倍数为
约为 \(1.56,4.94,14.83\)。小来源的词元权重提高约七倍,其重复程度也显著增加。该指标是消费量与库存量之比,不证明每篇文档恰好被访问同样次数。
带替换采样 \(m\) 次、均匀抽取 \(n\) 个不同对象时,期望见过的不同对象数为
推导只需对每个对象定义是否至少出现一次的指示变量,再求期望之和。\(m=n\) 时,大样本近似只有 \((1-e^{-1})n\) 个不同对象被访问。真实文档长度不等且存在近重复,不能直接把此对象公式视为不同信息词元的精确计数。
训练分布及评测分布
训练混合比例表达资源投入,评测混合比例表达质量偏好,两者不必相同。若目标评测分布权重为 \(r_i\),训练采样权重为 \(\pi_i>0\),可用 \(\frac{r_i}{\pi_i}\) 对来源损失作重要性加权,使期望匹配目标,但极端权重会放大方差。若目标来源完全没有训练支持,加权无法产生缺失样本。
质量筛选也会改变语言和文体覆盖。低困惑度文本可能更贴近评分模型熟悉的分布,却未必覆盖罕见术语或形式化推导。预训练配方应分别记录准入、质量层、语言、领域、长度和重复程度;不宜把所有因素压成一个无法解释的“优质分数”。数据流水线的实现见第18章《训练数据工程基础》,本章关心这些决策怎样改变 \(P_{\mathrm{train}}\)。
课程及继续预训练
课程学习(Curriculum Learning)使混合权重或难度随训练进程变化,记为 \(\pi_i(u)\),其中 \(u\) 可以是累计词元数。即便总消费量相同,先通用后领域与交错混合也不一定得到相同参数,因为连续梯度更新并不交换顺序。课程应同时说明阶段长度、过渡方式和通用能力保持条件。
继续预训练通常需要评估领域收益与旧分布退化。保留部分通用数据可以约束漂移,却没有一个跨模型通用的保证比例。小规模配方比较应固定有效词元预算、候选模型与评测切片,再决定是否扩展;测试集不得反复用于选择混合权重。
23.5不同预训练任务的监督结构
自回归、掩码恢复与去噪的区别首先在于可见信息和被预测变量,而不只是模型名称。统一表示为:从原始文档 \(x\) 通过变换 \(q(c,y\mid x)\) 产生条件 \(c\) 与目标 \(y\),优化
并明确按目标词元还是样本归一化。对于并行预测多个掩码位置的模型,求和项使用各位置的条件概率,不意味着这些概率构成任意长度文本的自回归联合概率。
| 任务 | 可见信息 | 预测内容 | 主要边界 |
|---|---|---|---|
| 自回归语言建模 | 当前词元之前的前缀 | 下一词元 | 直接匹配逐步续写;训练前缀是真实数据。 |
| 掩码语言建模 | 含遮蔽的双向上下文 | 被选中的词元 | 擅长双向表示;训练损失不能直接当作原文自回归困惑度。 |
| 跨度去噪 | 删除跨度后的文档与哨兵标记 | 被删跨度的序列 | 需要固定破坏分布、跨度顺序和停止协议。 |
| 前缀语言建模 | 完整前缀与已生成后缀 | 后续部分 | 前缀通常不计目标损失,监督密度随切分点变化。 |
| 中间填充 | 原文前段与后段 | 中间缺失内容 | 需要重排及边界标记;序列顺序不同于原文。 |
T5 的研究比较了文本到文本框架中的去噪目标与迁移设置(Raffel 等 2020)。以原文“甲 乙 丙 丁 戊”为例,删除“乙 丙”并以哨兵 \(s_0\) 替代,条件可写为“甲 \(s_0\) 丁 戊”,目标为“\(s_0\) 乙 丙 \(s_1\)”;哨兵用于定位缺失跨度,不能临时解释成通用起始标记。这里的符号例用于说明条件结构,具体制品的终止标记仍以其协议为准。
中间填充(Fill-in-the-Middle,FIM)可以将文档拆为前段 \(a\)、中段 \(b\)、后段 \(c\),重排为带边界标记的 \(a,c,b\),从而让因果模型在生成 \(b\) 时同时读取原文两侧(Bavarian 等 2022)。它并未让因果注意力读取重排序列的未来,而是通过改变顺序使两侧内容成为已知前缀。
混合任务可写为 \(L=\sum_k\lambda_kL_k\),但 \(\lambda_k\) 的含义依赖 \(L_k\) 的归一化。如果一个任务只监督15%位置,另一个监督近乎全部位置,相同样本抽样率并不等于相同目标词元贡献。比较任务还应报告处理位置量和实际计算量,否则较低损失可能来自较容易的条件或更高的监督资源,而不是更优的表示学习机制。
23.6参数、数据及计算的统一预算
词元计量口径
\(D_u\) 表示去重后可用内容的规模,\(D_s\) 表示累计有效目标数,\(D_p\) 表示模型实际处理的位置数。重复多个遍历增加 \(D_s\) 和 \(D_p\),不会同比增加 \(D_u\);填充和仅供上下文的位置增加 \(D_p\),不一定增加 \(D_s\)。
设每次参数更新有 \(R\) 个数据并行进程,每进程累积 \(G\) 个微批次,每批次 \(B\) 个长度 \(T\) 的块,训练 \(K\) 步,在规则相同且无额外掩码时
例如 \(K=1000,R=4,G=2,B=8,T=1024\),得到 \(D_p=65536000\),\(D_s=65472000\)。跨段屏蔽和填充会进一步降低 \(D_s\),实际应累加监督掩码,而不是永远套用 \(T-1\)。
训练计算近似的来源
对主要由密集矩阵乘法构成的网络,前向每个词元约需与参数规模成比例的运算;反向包含输入与权重梯度两部分。因此常用
作为数量级近似。这里乘加计为两次浮点运算,\(D\) 通常接近处理词元量;只有在监督密度高且边界损失很小时,才近似等于有效目标量。2
式(23.16)没有显式表达随上下文增长的注意力开销、激活重计算和特殊算子成本。长上下文时应重新估计 \(\kappa\) 或改用更详细模型。设备峰值乘运行时间是硬件上限;通信、存储等待与内核效率决定实际完成的模型计算,不应把峰值预算直接代入损失定律。
23.7经验规模定律的拟合
幂律描述及数据条件
规模定律(Scaling Law)以经验函数描述模型规模、数据和计算与损失之间的关系。Kaplan 等人的研究系统分析了语言模型交叉熵随这些变量变化的规律(Kaplan 等 2020);后续 Chinchilla 工作重新研究固定训练计算下的参数与训练词元分配(Hoffmann 等 2022)。这些研究的配置与拟合程序不同,不能把其中的指数拼接成一条统一物理定律。
本章使用一个便于分析的加性模型
\(E\) 表示该经验模型中的渐近底座,\(AN^{-\alpha}\) 与 \(B_sD^{-\beta}\) 分别描述参数和数据受限时的损失余量。有限观测不能证明拟合出的 \(E\) 就等于真实语言熵;数据、分词器和条件窗口的变化也会改变它。
单独固定数据研究参数增长时,若已知底座 \(L_\infty\),有
例如参数每扩大四倍、损失余量减半,则 \(\alpha=\frac{\log2}{\log4}=\frac{1}{2}\)。若错误地对 \(\log L\) 作线性拟合,底座占比较高时斜率会明显偏小。把未知底座与指数同时从狭窄区间估计,也容易产生多组近似等价解。
拟合应覆盖两个维度
仅在一条 \(ND\) 固定曲线上取样,会使参数与数据强相关,难以分别识别两者贡献。应在多组参数规模和训练长度上设计实验,并保留独立规模点检验预测。每个实验须具有可比的优化完成程度:若大模型使用明显不合适的学习率,拟合可能把优化不足误归因为规模效率差。
一种拟合形式为
其中 \(j\) 为实验点,\(w_j\) 为可靠性权重,\(\rho\) 可取平方损失或稳健损失。使用对数残差表示偏重相对误差;它不是唯一正确选择,应与预算决策关注的误差相匹配。约束正系数可通过指数参数化实现。
同一训练运行中的多个检查点共享数据与随机轨迹,不能当成相互独立实验无限增加置信度。应按训练运行或随机种子组织重采样,并报告外推点的误差区间。残差若随规模、长度或来源系统变化,说明模型遗漏了因素,而不是增加小数位就能提高可信度。
算法23.1 规模拟合与预算候选生成
冻结分词器、数据混合、评测集合、上下文和参数计数口径;保留测试集不参与配方选择。
设计覆盖多个 \(N\) 与 \(D\) 的训练网格,为每个规模分配合理优化配置,记录真实消费量与计算估计。
以有效目标总和聚合固定验证集损失,保留运行身份、重复程度与异常说明。
拟合式(23.17),在未参与拟合的规模点比较预测与实际损失,分析残差及参数不确定性。
在给定预算下求连续候选,再映射到可部署的离散架构与可用数据范围;对相邻候选开展预算内比较。
保存数据配方、拟合区间、候选选择依据与中止条件,使后续扩大规模有明确依据。
23.8计算最优分配的推导
拉格朗日条件
将式(23.17)与 \(C=\kappa ND\le C_0\) 联立。因为在假设范围内损失随 \(N,D\) 单调下降,内部最优点会用尽预算。定义拉格朗日函数
分别对 \(N,D\) 求导并令其为零:
第一式乘 \(N\),第二式乘 \(D\),消去相同的 \(\lambda\kappa ND\),得到
该条件平衡的是按对数规模计算的边际收益;只有 \(\alpha=\beta\) 时,两项损失余量才相等。
令 \(K_c=\frac{C_0}{\kappa}\),代入 \(D=\frac{K_c}{N}\),可得
这是所选经验函数及计算约束的数学结论。它本身并不能证明真实模型满足该函数。
最优点的唯一性及预算指数
令 \(u=\log N\),固定预算后的非底座损失为
其二阶导数
因此在没有额外边界的连续正数域中,驻点是唯一全局最优点。存在显存上限、最小模型规模或数据库存约束时,最优解可能落在可行区边界。
最优规模随预算的指数分别为 \(\frac{\beta}{\alpha+\beta}\) 与 \(\frac{\alpha}{\alpha+\beta}\)。当两指数相等时,模型和数据都按预算平方根增加;预算扩大四倍时,两者各扩大两倍。最优余量则满足
收益随计算增长而递减。若 \(\alpha\ne\beta\),最优 \(\frac{D_*}{N_*}\) 也随预算变化;固定“每参数多少词元”的口诀无法代替式(23.25)。
计算最优分配
例16.2
以下数值为便于手算而构造的模型,不是任何公开模型的拟合结果。定义 \(n=\frac{N}{10^9}\)、\(d=\frac{D}{10^9}\),假设
计算预算给出 \(nd=16\)。由边际平衡 \(n^{-\frac{1}{2}}=4d^{-\frac{1}{2}}\),得 \(d=16n\),联立后 \(n_*=1,d_*=16\),预测损失为4。
| 参数 \(n\) | 词元 \(d\) | 乘积 \(nd\) | 预测损失 |
|---|---|---|---|
| 0.25 | 64 | 16 | 4.5 |
| 1 | 16 | 16 | 4.0 |
| 4 | 4 | 16 | 4.5 |
较小模型获得更多数据但容量项较大,较大模型压缩了训练长度而数据项较大。两端计算量相同,不能通过比较参数规模直接判断结果。预算扩大四倍后,最优为 \(n=2,d=32\),损失 \(2+\sqrt2\approx3.414\)。
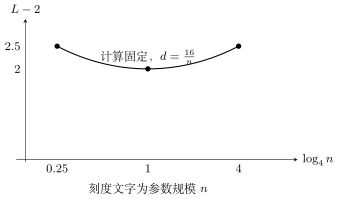
若可用不同数据只有四十亿词元且不允许重复,则 \(d\le4\)。在相同预算下,连续可行最优落在 \(d=4,n=4\),损失为4.5。允许重复并不意味着可以继续沿原函数把 \(d\) 增至16:原拟合如果主要使用新数据,就必须为重复训练重新建模。
23.9规模结论的外推边界
数据受限及优化受限
经验式中的数据量通常建立在特定重复范围和质量分布上。重复曝光有时仍能改善优化,却不能无限提供新的统计信息。合成数据也必须考察新信息、错误相关性与验证覆盖,不能因为文件数增加就把它等价计入原始独立数据预算。
同样,计算量相同但学习率、批次、衰减与停止时机不同,可能导致不同损失。规模最优讨论要求各候选达到可比的预算内训练效率,而不是所有模型机械使用同一更新步数。第19章《训练稳定性》将展开优化器状态与调度;在本章的预算实验中,它们属于必须记录的控制条件。
训练最优及全生命周期最优
Chinchilla 式问题关注给定训练计算的模型选择。部署时还可能关注模型容量、延迟和累计推理量。若未来生成 \(Q\) 个词元,简化生命周期成本可写为
其中 \(\kappa_{\mathrm{inf}}\) 是给定推理场景下的近似系数。较小模型经过更多训练,可能在大量调用时降低总成本;这改变了约束与优化目标,不能直接套用仅训练计算最优点。真实推理成本还随上下文、缓存与硬件变化,上式仅说明新增目标项的方向。
损失及能力的不同尺度
验证交叉熵平滑下降,并不保证每个下游任务同时改善。离散正确率可能受评分阈值、提示方式和样本量影响;某个能力切片也可能因混合配比下降。模型选择应同时保留可比的预训练损失与领域、语言、长上下文等任务指标,不能只把损失变小解释为所有能力提升。
规模定律的正确用法
规模定律用于缩小预算候选范围,并提出可被实验否定的预测。拟合区间、分布、架构或目标发生变化后,应重新评估系数与误差。连续最优解是架构选型的起点,最终方案还须满足数据库存、设备容量和部署要求。
23.10预训练的数据流及状态流
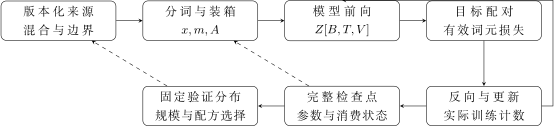
一次训练状态可记为 \(s_k=(\theta_k,o_k,h_k,r_k,d_k)\),分别表示参数、优化器状态、调度状态、随机状态与数据消费位置。一次更新为 \(s_{k+1}=F(s_k,\mathcal B_k)\)。只恢复参数会改变后续状态转移,不能称为精确续训。数据配比随进度变化时,还需要恢复其阶段位置;流式洗牌则需要能够重建缓冲与分片消费关系。
算法23.2 按有效词元推进预训练
训练过程平均损失反映历史参数在各批次上的表现,不等于最终参数的验证损失。用于选择最佳检查点的验证集已经参与模型选择,最终测试集应继续隔离。配套小型实践能够说明目标、更新与恢复机制;它的语料范围和预算并不构成通用基座能力的证据。